
Contenido 12 secciones
- ¿Qué es un mapa del sitio (sitemap)?
- ¿Por qué es importante el mapa del sitio para el comercio electrónico?
- ¿Qué es robots.txt y en qué se diferencia del mapa del sitio?
- ¿Qué páginas debe incluir el mapa del sitio de una tienda de comercio electrónico?
- ¿Cómo se crea un mapa del sitio?
- ¿Cómo se divide el mapa del sitio en catálogos grandes?
- ¿Cómo se usa correctamente el campo lastmod?
- ¿Cómo se comunica el mapa del sitio a los buscadores?
- ¿Cuáles son los errores más comunes en el mapa del sitio?
- Lista de comprobación del mapa del sitio
- ¿Cómo se gestionan el mapa del sitio y robots.txt en Faprika?
- Preguntas frecuentes
Ha añadido una nueva categoría a su tienda, ha actualizado cientos de productos, pero pasan las semanas y no ve su reflejo en los resultados de búsqueda. O al revés: en los resultados aparecen direcciones de carrito, cuenta y filtros, y las páginas que de verdad quiere vender quedan atrás. Estos dos problemas suelen tener el mismo origen: no ha dicho con claridad a los robots de los buscadores cuáles son las páginas importantes de su sitio. La herramienta más básica para ello es el mapa del sitio.
En esta guía respondemos a la pregunta qué es un mapa del sitio desde la perspectiva del comercio electrónico: qué es el archivo sitemap.xml y qué contiene, en qué se diferencia de robots.txt y cómo funcionan juntos, qué direcciones deben y no deben entrar en el mapa de una tienda de comercio electrónico, cómo se divide el mapa en catálogos grandes, el uso correcto del campo lastmod, cómo se comunica el mapa a los buscadores, los errores más frecuentes y la lista de comprobación previa a la publicación. Al final encontrará su relación con Faprika y unas preguntas frecuentes de seis preguntas.
¿Qué es el mapa del sitio (sitemap)?
Un mapa del sitio es un archivo que enumera las direcciones de las páginas de un sitio web que se desea indexar y que se ofrece a los robots de los buscadores. Su formato más habitual es el archivo XML situado en la raíz del sitio, cuyo nombre suele ser sitemap.xml.
Los robots de los buscadores suelen recorrer un sitio siguiendo los enlaces: pasan de una página a otra y descubren direcciones nuevas. Este método suele funcionar, pero no es perfecto. Si una página recién añadida no tiene enlaces desde ningún sitio, si llegar a una página de producto profunda exige muchos clics o si el sitio es muy grande, algunas páginas se descubren tarde o nunca. El mapa del sitio cubre ese hueco: entrega una lista al robot antes de que recorra el sitio.
Conviene saber desde el principio que el mapa no garantiza nada. Que una página figure en el mapa no asegura que se indexe ni que aparezca en los primeros puestos; el mapa es una pista, no una orden. Pero es una pista potente y marca la diferencia, sobre todo en las páginas nuevas, profundas o que cambian con frecuencia.
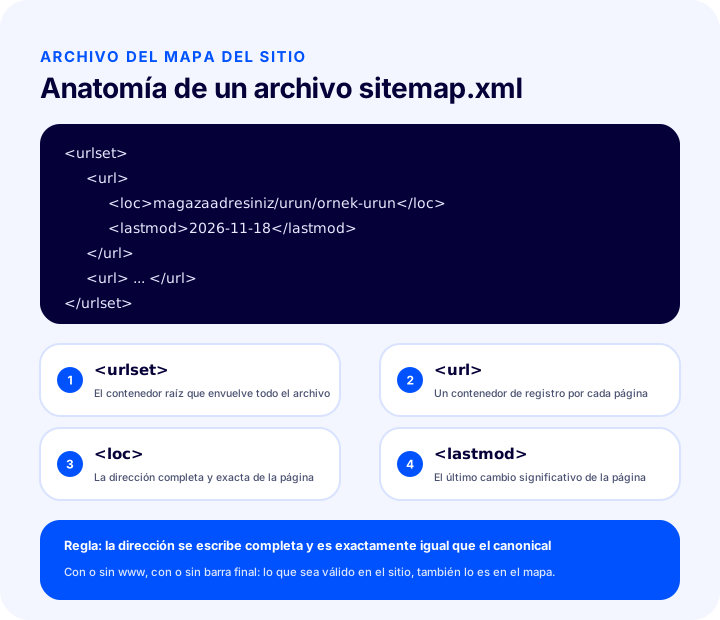
Como se ve en la ilustración, el archivo se construye con unas pocas etiquetas sencillas. La etiqueta más externa, urlset, envuelve todos los registros; cada página se coloca en una caja url, loc lleva la dirección completa de la página y lastmod la fecha del último cambio significativo de la página. El siguiente ejemplo muestra el contenido de un mapa de una sola página; “magazaadresiniz” representa su nombre de dominio.
<urlset>
  <url>
    <loc>magazaadresiniz/urun/ornek-urun</loc>
    <lastmod>2026-11-18</lastmod>
  </url>
</urlset>| Etiqueta | Función | ¿Es obligatoria? |
|---|---|---|
| urlset | Caja raíz que abarca todas las direcciones del archivo | Sí |
| url | Un registro por cada página | Sí |
| loc | Dirección completa de la página | Sí |
| lastmod | Fecha del último cambio significativo de la página | No, pero es útil si se usa bien |
El mapa del sitio no tiene por qué ser solo XML; los sitios también tienen páginas de «mapa del sitio» dirigidas a los visitantes. Lo que se explica en este artículo es el archivo XML preparado para los robots. La lista simple de enlaces dirigida al visitante sirve a la experiencia de usuario y contribuye a la estructura de enlaces internos.
¿Por qué es importante el mapa del sitio para el comercio electrónico?
Los sitios de comercio electrónico son de los que más se benefician del mapa del sitio, porque albergan muchísimas páginas que cambian de forma constante. Se añaden productos, cambian los precios y el stock, se reorganizan las categorías y se abren y cierran páginas de campaña.
- Los productos nuevos se descubren antes. El producto añadido a la tienda aparece en el mapa y el robot no tiene que buscarlo en la cadena de enlaces.
- Las páginas profundas no se pierden. Llegar a los productos que quedan tras categorías, subcategorías y paginación puede llevar tiempo; el mapa da la dirección directamente.
- El presupuesto de rastreo no se malgasta. El tiempo y el número de solicitudes que los robots dedican a un sitio son limitados. Si el mapa solo contiene páginas valiosas, la atención del robot se dirige hacia ellas.
- Los problemas se ven pronto. En las herramientas de los buscadores se puede consultar cuántas de las direcciones del mapa se han indexado y cuáles han dado error; es una de las formas más prácticas de detectar problemas técnicos.
- Los grandes cambios se comunican. Tras un rediseño, un cambio en la estructura de direcciones o una actualización masiva de productos, un mapa actualizado ayuda a que la nueva situación se conozca con rapidez.
¿Qué es robots.txt y en qué se diferencia del mapa del sitio?
Robots.txt es el archivo de texto situado en la raíz del sitio que indica a los robots de los buscadores a qué secciones no deben entrar. El mapa del sitio dice «vengan aquí» y robots.txt dice «no entren aquí»; uno es una invitación y el otro un límite.
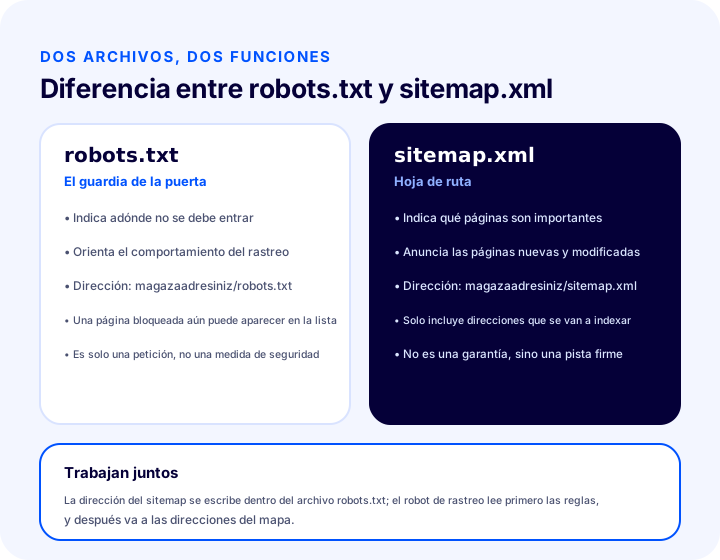
| Función | robots.txt | sitemap.xml |
|---|---|---|
| ¿Qué indica? | Adónde no se debe entrar | Qué páginas son importantes |
| Función | Orienta el comportamiento de rastreo | Favorece el descubrimiento y la prioridad de rastreo |
| Formato | Reglas en texto plano | Lista de direcciones en XML |
| Ubicación | Raíz del sitio | Normalmente la raíz del sitio; su dirección se indica en robots.txt |
| ¿Es una herramienta de seguridad? | No, es solo una solicitud | No |
| ¿Impide por sí solo la indexación? | No, solo restringe el rastreo | No |
El aspecto de un archivo robots.txt es sencillo. En el ejemplo siguiente, para todos los robots no se rastrean las secciones de carrito y cuenta de usuario, y la dirección del mapa se indica al final. Las rutas están escritas a modo de ejemplo; cambian según las direcciones reales de su propio sitio.
User-agent: *
Disallow: /sepet
Disallow: /uye

Sitemap: magazaadresiniz/sitemap.xml
La última línea es importante: escribir la dirección del mapa en robots.txt es una forma sencilla y fiable de que los robots encuentren el mapa por sí solos. Así, aunque no se haya hecho un aviso aparte de la dirección del mapa, el robot lee primero las reglas y después va a las direcciones del mapa.
¿Cómo funcionan juntos?
Cuando un robot llega a un sitio, mira primero el archivo robots.txt, aprende las reglas y obtiene de allí la dirección del mapa. Después visita en orden las direcciones del mapa; una dirección bloqueada por robots.txt no se rastrea aunque esté en el mapa. Esta contradicción es un error frecuente en los sitios de comercio electrónico y se trata en las secciones siguientes: bloquear con robots.txt una dirección que se ha puesto en el mapa es decirle al robot a la vez «ven» y «no entres».
¿Bloquear con robots.txt y bloquear con noindex es lo mismo?
No; robots.txt restringe el rastreo, mientras que noindex pide que la página no aparezca en los resultados de búsqueda. Si el robot no puede entrar en la página, tampoco puede ver la directiva noindex de la página; por eso, si quiere sacar una página de los resultados, bloquearla con robots.txt no es el camino correcto.
| Finalidad | Herramienta adecuada | Nota |
|---|---|---|
| Que los robots no rastreen en absoluto una sección | robots.txt | Adecuado para zonas inútiles como carrito y cuenta de usuario |
| Que una página no aparezca en los resultados de búsqueda | noindex | El robot debe poder entrar en la página para leer la directiva |
| Indicar cuál es la página principal entre varias parecidas | etiqueta canonical | La página sigue abierta y se indica la dirección principal |
| Trasladar una dirección antigua a una nueva | Redirección 301 | La dirección que redirige no entra en el mapa |
Para más detalles sobre las redirecciones, puede leer el artículo qué es una redirección 301.
Le recomendamos leer¿Qué es una redirección 301?¿Qué páginas debe incluir el mapa del sitio de una tienda de comercio electrónico?
En el mapa entra toda página que quiera que aparezca en los resultados de búsqueda, que se abra sin problemas y que tenga su propia dirección canonical. Como criterio sencillo: es adecuada toda página que le alegraría que un cliente encontrara al llegar desde un resultado de búsqueda.
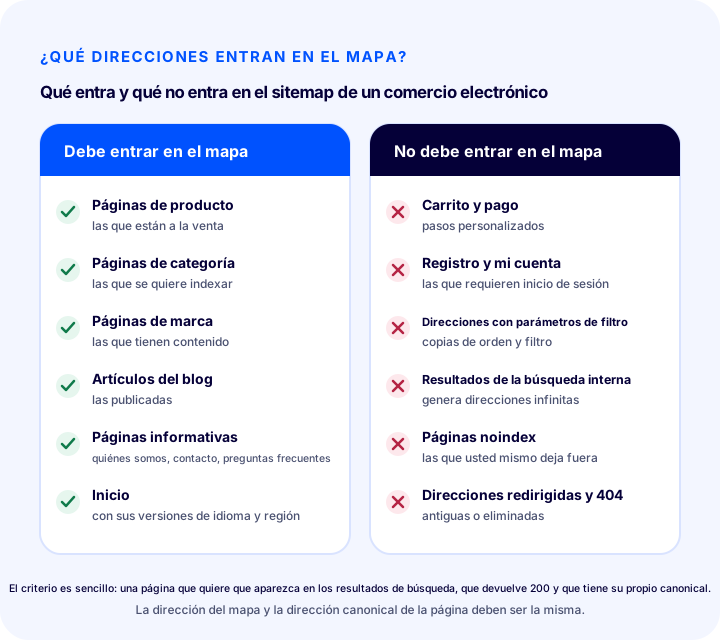
Lo que debe entrar en el mapa
- Páginas de producto. Productos a la venta, con descripción e imagen. Decida qué hacer con los productos retirados de la venta: si se han retirado de forma permanente, deben salir del mapa y hacerse una redirección adecuada.
- Páginas de categoría. Las categorías que quiere indexar y que tienen contenido suficiente. Para saber cómo reforzar las páginas de categoría, consulte la guía de SEO de páginas de categoría.
- Páginas de marca y de colección. Las que tienen contenido completo.
- Artículos del blog y guías. Los que están publicados y no tienen copias.
- Páginas informativas e institucionales. Páginas como Quiénes somos, contacto y preguntas frecuentes. Para las páginas legales obligatorias, el artículo páginas legales de un sitio de comercio electrónico le sirve de guía.
- Página de inicio. En un sitio multilingüe, la página de inicio de cada idioma, junto con sus versiones en los demás idiomas.
Lo que no debe entrar en el mapa
- Pasos de carrito, pago y pedido. Páginas personales e inútiles en los resultados de búsqueda.
- Páginas de registro, inicio de sesión y mi cuenta. Toda página que exige iniciar sesión.
- Direcciones con parámetros de filtro y ordenación. Las distintas combinaciones de orden y filtro de una misma categoría generan innumerables direcciones duplicadas. Para saber por qué estas direcciones causan problemas, puede consultar el artículo optimización de los filtros de producto y de la barra de búsqueda.
- Páginas de resultados de búsqueda interna. Cada palabra que escribe el visitante puede generar una dirección nueva; nace un conjunto de direcciones sin fin.
- Páginas con etiqueta noindex. Listar en el mapa como «esto es importante» una página de la que ha dicho «que no salga en los resultados» es incoherente.
- Direcciones redirigidas. Se enumera el destino de la redirección, no las direcciones antiguas que van a otra dirección mediante 301.
- Direcciones que devuelven 404 o error. La dirección de un producto eliminado no debe permanecer en el mapa.
- Páginas duplicadas y vacías. Una categoría sin productos o una página de etiqueta sin contenido.
| Tipo de página | ¿Debe estar en el mapa? | Motivo |
|---|---|---|
| Producto a la venta | Sí | Puede convertirse en venta desde una búsqueda |
| Categoría que se va a indexar | Sí | Cubre las búsquedas amplias |
| Artículo de blog publicado | Sí | Lleva a quien busca información hacia la tienda |
| Carrito y pago | No | Personal, sin valor de búsqueda |
| Páginas de cuenta de usuario | No | Requiere iniciar sesión |
| Dirección con parámetros de filtro | No | Contenido duplicado y multiplicación de direcciones |
| Resultados de la búsqueda interna | No | Direcciones ilimitadas y sin valor |
| Página noindex | No | Contradice al mapa |
| Dirección redirigida con 301 | No | Se enumera la dirección de destino |
| Dirección que devuelve 404 | No | Genera errores y daña la confianza |
¿Cómo se crea un mapa del sitio?
El mapa del sitio suele generarlo automáticamente la plataforma de comercio electrónico, o se extrae con una herramienta y se sube a la raíz del sitio. Escribirlo a mano solo tiene sentido en sitios muy pequeños; a medida que crece el número de páginas, un mapa gestionado manualmente se queda inevitablemente obsoleto.
- Decida qué páginas deben entrar. Aplique a su sitio la tabla de la sección anterior.
- Genere el mapa o actívelo desde el panel. Si su plataforma lo genera por sí misma, revise su contenido; si no, créelo con una herramienta y súbalo a la raíz.
- Revise las direcciones. ¿Son coherentes el dominio, el uso de www, https y la barra final?
- Escriba la dirección del mapa en robots.txt. Los robots encuentran el mapa desde allí.
- Notifique el mapa en las herramientas de los buscadores. Las herramientas muestran si el mapa se lee y el estado de las direcciones que contiene.
- Revise con regularidad. ¿Se reflejan en el mapa los productos nuevos, las categorías eliminadas y los cambios en la estructura de direcciones?
¿Qué información debe ir en el mapa y cuál sobra?
Para cada dirección, el dato imprescindible es la propia dirección. La fecha de última modificación (lastmod) es útil, pero solo si es correcta. Muchas plataformas generan también campos adicionales; su presencia no daña el mapa, pero en lugar de confiar en campos distintos de la dirección y la fecha correcta, lo que importa es que la propia página y los enlaces internos sean sólidos.
¿Qué formatos existen?
El mapa se prepara sobre todo en XML. También puede usarse el formato de texto simple, con una dirección por línea. XML se prefiere en el comercio electrónico porque puede incluir información adicional como lastmod.
¿Cómo se divide el mapa del sitio en catálogos grandes?
Un único archivo de mapa tiene un límite de número de direcciones y de tamaño de archivo; cuando el catálogo crece, el mapa se divide en varios archivos y se prepara un mapa índice que los enumera. El mapa índice no contiene direcciones de páginas; solo lista las direcciones de los mapas secundarios.
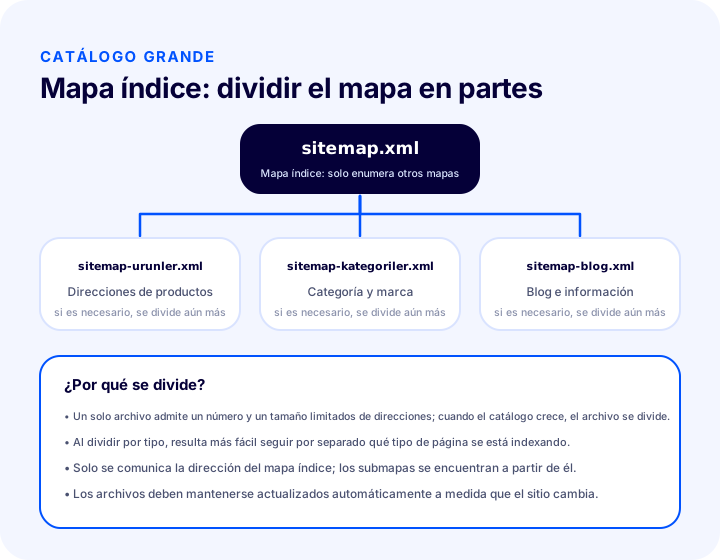
Para dividir, el criterio más útil suele ser el tipo de página: productos, categorías y marcas, blog y páginas informativas se colocan en archivos distintos. Esto tiene dos ventajas. La primera, que cada archivo se mantiene dentro del límite. La segunda, que en las herramientas de los buscadores puede ver por separado cuántas páginas de cada tipo están indexadas; los problemas de los productos aparecen de forma independiente de las categorías. En sitios multilingües también tiene sentido separar por idioma.
Lo que hay que tener en cuenta es que solo se notifica la dirección del mapa índice; los mapas secundarios se encuentran desde ella. Los nombres y el número de los archivos secundarios los define según la estructura de su sitio; los nombres de archivo de arriba son solo ejemplos.
¿Cómo se usa correctamente el campo lastmod?
Lastmod es la fecha que indica cuándo cambió por última vez de forma significativa el contenido de una página. Si es correcta, recuerda a los robots qué páginas deben volver a visitar; si es errónea, reduce la fiabilidad.
- Escriba la fecha real del cambio. La fecha se actualiza cuando cambia la descripción, la imagen, el precio o el contenido importante del producto.
- No ponga la fecha de hoy en todas las páginas cada día. Si la fecha se actualiza sin que haya cambiado nada, los robots dejan de fiarse de ella y el campo pierde su valor.
- No altere la fecha por cambios pequeños e irrelevantes. La fecha no debe cambiar por una fecha o un contador del pie de página.
- El formato de fecha debe ser estándar. Basta con el formato año, mes y día; ejemplo: 2026-11-18.
- Si no conoce la fecha, no la invente. El campo es opcional; es mejor dejarlo vacío que escribir una fecha errónea.
Hay además esta distinción: el mapa solo contiene direcciones y fechas; lo que cuenta el contenido de la página lo expresan los datos estructurados. Para marcar para los buscadores información como el producto, el precio y las reseñas, puede consultar el artículo qué son los datos estructurados.
Le recomendamos leer¿Qué son los datos estructurados?¿Cómo se notifica el mapa del sitio a los buscadores?
El mapa del sitio se notifica de dos maneras: escribiéndolo dentro del archivo robots.txt y enviándolo a través de las herramientas que los buscadores ofrecen a los propietarios de sitios. Hacer ambas cosas a la vez es el método más sólido.
- Escríbalo en robots.txt. Al final del archivo, añada la dirección completa del mapa con la línea “Sitemap:”. Los robots lo ven la primera vez que llegan al sitio.
- Verifique el sitio en las herramientas de los buscadores. Una vez demostrado que es el propietario, introduce la dirección del mapa en la herramienta.
- Supervise el estado. La herramienta muestra si el mapa se lee, cuántas direcciones se han descubierto y cuáles dan error.
- Siga las actualizaciones. Si su mapa se actualiza solo, no necesita volver a enviarlo; basta con consultar de vez en cuando en la herramienta la fecha de la última lectura.
Después de notificar el mapa, no espere resultados en poco tiempo; los buscadores leen el mapa según su propio calendario. Pero el informe de estado es valioso porque muestra las direcciones erróneas desde el primer día.
¿Cuáles son los errores más frecuentes en el mapa del sitio?
El error más frecuente es configurar el mapa una vez, olvidarse de él y dejar que se quede obsoleto con el tiempo. El mapa debe vivir junto con el sitio; los errores siguientes surgen casi siempre de este descuido.
1. Direcciones que contradicen a canonical
Si la dirección del mapa apunta a otra dirección en la etiqueta canonical de la página, el robot queda atrapado entre ambas. En el mapa solo debe escribirse la dirección canonical.
2. Direcciones redirigidas o que devuelven 404
Si una dirección antigua permanece en el mapa y esa dirección va a otra parte con 301 o da error, el robot va en vano. El mapa solo debe contener páginas que se abren directamente y devuelven el estado 200.
3. Páginas noindex que permanecen en el mapa
No es posible decir a la vez “no indexar” e “esta página es importante”. Si una página es noindex, se retira del mapa; para que el mapa se mantenga actualizado, esta revisión debe hacerse automáticamente.
4. Direcciones bloqueadas por robots.txt que están en el mapa
El robot toma la dirección del mapa, pero no puede entrar por una regla de robots.txt. Aparece en la herramienta como error de “bloqueado” y el mapa pierde credibilidad.
5. Inclusión en el mapa de direcciones de filtros, ordenación y búsqueda interna
Estas direcciones generan páginas duplicadas muchas veces mayores que el tamaño del catálogo; el mapa se infla y el robot no puede dedicar tiempo a las páginas realmente valiosas.
6. Formato de dirección incoherente
Si algunas direcciones se escriben con www y otras sin él, unas con barra final y otras sin ella, surge una incoherencia entre el mapa y el sitio. Se elige un único formato y se usa igual en todas partes.
7. Dejar un mapa antiguo y muerto
Cuando cambia la estructura de direcciones, si el archivo del mapa antiguo se queda ahí, el robot sigue buscando páginas que ya no existen. En las reestructuraciones, compruebe que el mapa también se haya renovado.
8. No listar los archivos de mapas secundarios
Si se usa un mapa índice, asegúrese de que todos los archivos secundarios estén enumerados en el índice; un mapa secundario que no figura en la lista puede no leerse.
| Error | Consecuencia | Solución |
|---|---|---|
| Dirección que contradice a canonical | El robot duda de cuál dirección fiarse | Escriba solo la dirección canonical en el mapa |
| Dirección que devuelve 301 o 404 | Rastreo inútil, informe de errores | Liste solo las direcciones que devuelven 200 |
| Página noindex | Señal incoherente | Retire del mapa la página noindex |
| Dirección bloqueada por robots.txt | Error de bloqueo | O levante el bloqueo o retire la dirección del mapa |
| Direcciones de filtros y búsqueda interna | Mapa inflado, contenido duplicado | No incluya estas direcciones en el mapa |
| Formato de dirección incoherente | El sitio y el mapa no coinciden | Defina un único formato |
Lista de comprobación para el mapa del sitio
Antes de publicar el mapa o al revisarlo con regularidad, basta con mirar estos ocho puntos. Si puede responder que sí a todos, su mapa está sano.
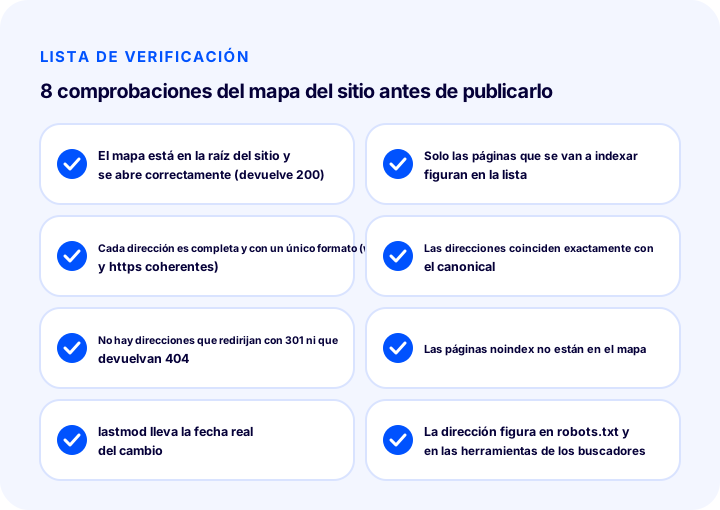
- El mapa está en la raíz del sitio y se abre. Abra la dirección en el navegador: el archivo debe cargarse y el estado de la página debe ser correcto.
- Solo se enumeran las páginas que se van a indexar. No hay direcciones de carrito, cuenta de usuario, filtros ni búsqueda interna.
- Cada dirección está escrita completa y con un único formato. El dominio, www y https son coherentes.
- Las direcciones coinciden exactamente con la dirección canonical de las páginas.
- No hay direcciones que redirijan con 301 ni que devuelvan 404.
- Ninguna página noindex está en el mapa.
- Lastmod lleva la fecha real del cambio o no se usa en absoluto.
- La dirección del mapa está escrita en robots.txt y notificada en las herramientas de los buscadores.
¿Cómo se gestionan el mapa del sitio y robots.txt en Faprika?
En la plataforma de comercio electrónico de Faprika, la gestión de canonical, etiquetas de título, robots y sitemap figura en una misma línea de funciones. Así, estos ajustes que atañen a la identidad de la página no se piensan de forma desconectada.
En la comparación de funciones de los planes hay una línea “Canonical / H Etiket Yönetimi / Robots / Sitemap”; su alcance puede variar según el plan, y para más detalle puede consultar la página de planes de comercio electrónico. Aparte de lo relacionado con el mapa, hay otras líneas que apoyan el SEO: “301 / 302 / 410 Paneli / URL Kayıtlarını Yönetme” sirve para gestionar las redirecciones cuando cambian las direcciones, “Toplu Otomatik SEO/Meta Bilgi Güncelleme” para editar en bloque los campos de título y descripción, y “SEO Raporları” para supervisar el estado. En qué plan se incluyen estas funciones también se ve en la comparación de planes.
Para saber dónde y cómo se hacen los ajustes generales de SEO en el panel de Faprika, le orientan la guía cómo configurar el SEO del comercio electrónico y la página de formación ajustes de SEO. Si en su tienda hay un caso especial relacionado con el mapa, por ejemplo una estructura multilingüe o un catálogo grande, puede consultarlo con nuestro equipo en la reunión de demo.
Preguntas frecuentes
¿Qué es un mapa del sitio?
Un mapa del sitio es un archivo que enumera las direcciones de las páginas de un sitio web que se desea indexar y que se ofrece a los robots de los buscadores. Su formato más habitual es el archivo sitemap.xml en la raíz del sitio, y ayuda a los robots a descubrir más rápido las páginas nuevas y modificadas.
¿El mapa del sitio y robots.txt son lo mismo?
No. El mapa del sitio indica a los robots qué páginas son importantes, mientras que robots.txt señala adónde no deben entrar. Se usan juntos: la dirección del mapa se escribe en robots.txt, y el robot lee primero las reglas y luego va a las direcciones del mapa.
¿Necesita todo sitio de comercio electrónico un mapa del sitio?
En la práctica, sí. Para los sitios de comercio electrónico con muchos productos y páginas que cambian constantemente, el mapa acelera el descubrimiento de productos y categorías nuevos y facilita la supervisión de los problemas técnicos. El mapa no garantiza nada, pero reduce las pérdidas.
¿Qué páginas no deben entrar en el mapa del sitio?
No deben entrar en el mapa las páginas de carrito, pago, registro y cuenta, las direcciones con parámetros de filtro y ordenación, los resultados de búsqueda interna, las páginas noindex, las direcciones redirigidas a otra y las que devuelven 404. En el mapa solo figuran las páginas que desea indexar, que se abren sin problemas y que tienen su propia dirección canonical.
¿Cómo se comunica el mapa del sitio a los buscadores?
La dirección del mapa se escribe en el archivo robots.txt con la línea «Sitemap:» y además se envía a través de las herramientas que los buscadores ofrecen a los propietarios de sitios. La herramienta también muestra si el mapa se ha leído y cuál es el estado de las direcciones que contiene.
¿Cómo se gestiona el mapa del sitio cuando crece el catálogo?
Un solo archivo de mapa admite un número y un tamaño limitados de direcciones; en los catálogos grandes el mapa se divide en varios archivos según el tipo de página y se prepara un mapa índice que los enumera. Solo se comunica la dirección del mapa índice. El mapa debe actualizarse automáticamente a medida que se añaden y se retiran productos.


