
Sommaire 12 sections
- Qu'est-ce qu'un plan de site (sitemap) ?
- Pourquoi un plan du site est-il important pour l'e-commerce ?
- Qu'est-ce que robots.txt et en quoi diffère-t-il d'un plan du site ?
- Quelles pages inclure dans le plan d'un site e-commerce ?
- Comment créer un plan du site
- Comment diviser le plan du site pour les grands catalogues
- Comment utiliser correctement le champ lastmod
- Comment soumettre le plan du site aux moteurs de recherche
- Quelles sont les erreurs courantes dans un plan du site ?
- Liste de contrôle du plan du site
- Comment le plan du site et robots.txt sont-ils gérés dans Faprika ?
- Questions fréquentes
Vous avez ajouté une nouvelle catégorie à votre boutique et mis à jour des centaines de produits, mais des semaines plus tard, vous n'en voyez toujours pas la trace dans les résultats de recherche. Ou l'inverse : des adresses de panier, de compte et de filtre apparaissent dans les résultats, tandis que les pages que vous voulez vraiment vendre restent en retrait. La cause commune de ces deux problèmes est souvent la même : vous n'avez pas indiqué clairement aux robots des moteurs de recherche quelles pages de votre site sont importantes. L'outil le plus élémentaire pour cela est le plan du site.
Dans ce guide, nous répondons à la question qu'est-ce qu'un plan du site sous l'angle de l'e-commerce : ce qu'est le fichier sitemap.xml et ce qu'il contient, en quoi il diffère de robots.txt et comment les deux fonctionnent ensemble, quelles adresses inclure ou non dans le plan d'un site e-commerce, comment le plan est divisé pour les grands catalogues, comment bien utiliser le champ lastmod, comment le plan est soumis aux moteurs de recherche, les erreurs courantes et une liste de contrôle à parcourir avant la mise en ligne. À la fin, vous trouverez le lien avec Faprika et une FAQ de six questions.
Plan du site (sitemap) : qu'est-ce que c'est ?
Un plan du site est un fichier qui liste les adresses des pages d'un site web dont vous souhaitez l'indexation et les présente aux robots des moteurs de recherche. Sa forme la plus courante est le fichier XML situé à la racine du site, généralement nommé sitemap.xml.
Les robots des moteurs de recherche parcourent généralement un site en suivant les liens : ils passent d'une page à l'autre et découvrent de nouvelles adresses. Cette méthode fonctionne souvent, mais elle n'est pas parfaite. Si une page nouvellement ajoutée n'est liée depuis aucune autre, si atteindre une page produit enfouie demande de nombreux clics, ou si le site est très volumineux, certaines pages sont découvertes tardivement, voire jamais. Le plan du site comble cette lacune : il remet une liste au robot avant l'exploration.
Il faut savoir dès le départ qu'un plan du site ne garantit rien. Une page listée dans le plan n'est pas certaine d'être indexée ni de se classer haut ; le plan est un indice, pas un ordre. Mais c'est un indice fort, qui fait la différence surtout pour les pages nouvelles, profondes ou fréquemment modifiées.
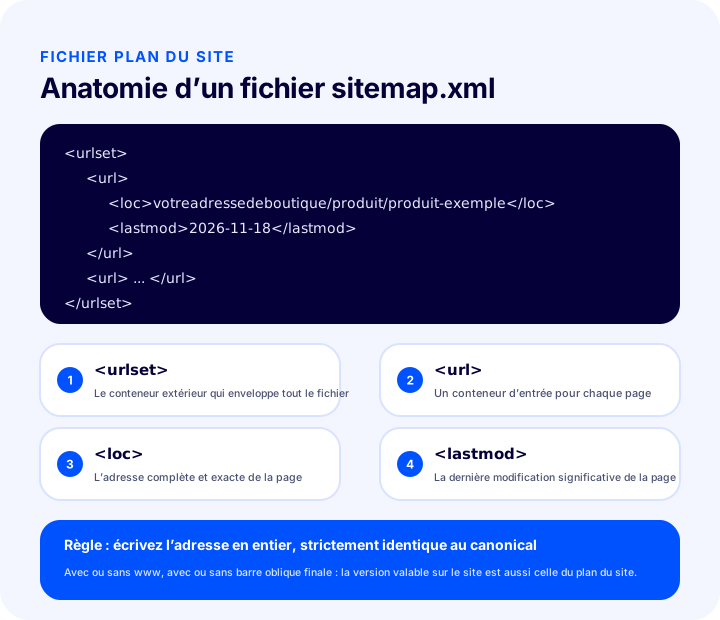
Comme le montre le schéma, le fichier est construit à partir de quelques balises simples. La balise la plus externe, urlset, enveloppe toutes les entrées, chaque page est placée dans un bloc url, loc porte l'adresse complète de la page et lastmod la date de sa dernière modification significative. L'exemple ci-dessous montre le contenu d'un plan du site d'une seule page ; « magazaadresiniz » représente votre nom de domaine.
<urlset>
  <url>
    <loc>magazaadresiniz/urun/ornek-urun</loc>
    <lastmod>2026-11-18</lastmod>
  </url>
</urlset>| Étiquette | Rôle | Obligatoire ? |
|---|---|---|
| urlset | L'élément racine qui couvre toutes les adresses du fichier | Oui |
| url | Une entrée par page | Oui |
| loc | L'adresse complète de la page | Oui |
| lastmod | Date de la dernière modification significative de la page | Non, mais utile si elle est bien utilisée |
Un plan du site n'est pas obligatoirement au format XML ; les sites ont aussi des pages « plan du site » destinées aux visiteurs. Cet article décrit le fichier XML préparé pour les robots. La simple liste de liens destinée aux visiteurs relève en revanche de l'expérience utilisateur et contribue à la structure des liens internes.
Pourquoi un plan du site est-il important pour l'e-commerce ?
Les sites e-commerce hébergent un grand nombre de pages en constante évolution ; ils comptent donc parmi les types de sites qui profitent le plus d'un plan du site. Des produits sont ajoutés, les prix et les stocks changent, les catégories sont réorganisées, des pages de campagne s'ouvrent et se ferment.
- Les nouveaux produits sont découverts plus vite. Un produit ajouté à la boutique apparaît dans le plan du site, et le robot n'a pas à le chercher le long d'une chaîne de liens.
- Les pages profondes ne se perdent pas. Les produits cachés derrière des catégories, sous-catégories et pagination peuvent être longs à atteindre ; le plan du site donne directement l'adresse.
- Le budget d'exploration n'est pas gaspillé. Le temps et le nombre de requêtes que les robots consacrent à un site sont limités. Si le plan du site ne contient que des pages de valeur, l'attention du robot s'y porte.
- Les problèmes deviennent visibles tôt. Dans les outils des moteurs de recherche, on peut voir combien d'adresses du plan ont été indexées et lesquelles ont renvoyé des erreurs ; c'est l'un des moyens les plus pratiques de repérer des problèmes techniques.
- Les grands changements sont signalés. Après une refonte, un changement de structure d'adresses ou une mise à jour groupée de produits, un plan du site à jour aide à faire connaître rapidement la nouvelle situation.
Qu'est-ce que robots.txt et en quoi diffère-t-il d'un plan du site ?
Robots.txt est un fichier texte à la racine du site qui indique aux robots des moteurs de recherche les sections où ils ne doivent pas entrer. Le plan du site dit « venez ici », robots.txt dit « n'entrez pas ici » ; l'un est une invitation, l'autre une limite.
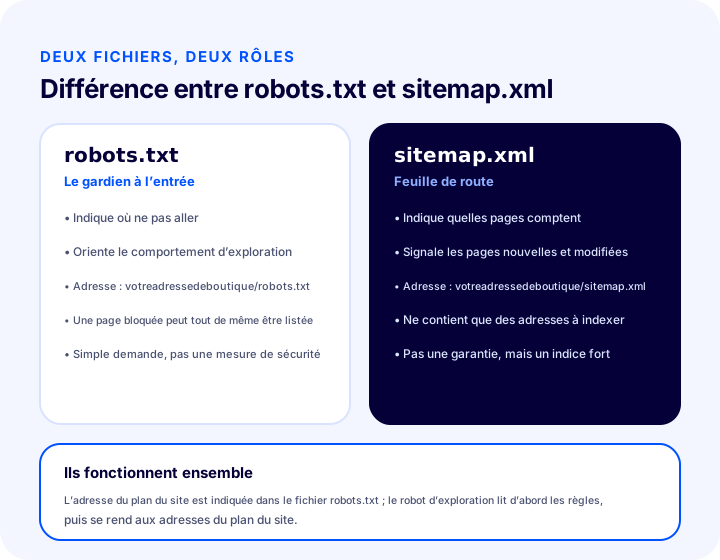
| Fonctionnalité | robots.txt | sitemap.xml |
|---|---|---|
| Indique | Où les robots ne doivent pas aller | Quelles pages sont importantes |
| Rôle | Oriente le comportement d'exploration | Soutient la découverte et la priorité d'exploration |
| Format | Règles en texte brut | Liste d'adresses en XML |
| Emplacement | Racine du site | Généralement la racine du site ; son adresse est indiquée dans robots.txt |
| Un outil de sécurité ? | Non, seulement une demande | Non |
| Empêche-t-il l'indexation à lui seul ? | Non, il restreint seulement l'exploration | Non |
Un fichier robots.txt a un aspect simple. Dans l'exemple ci-dessous, les sections panier et compte ne sont pas explorées pour tous les robots, et l'adresse du plan du site est indiquée à la fin. Les chemins sont donnés à titre d'exemple ; ils changent selon les adresses réelles de votre propre site.
User-agent: *
Disallow: /sepet
Disallow: /uye

Sitemap: magazaadresiniz/sitemap.xml
La dernière ligne est importante : écrire l'adresse du plan du site dans robots.txt est un moyen simple et fiable pour que les robots le trouvent automatiquement. Ainsi, même sans annonce séparée de l'adresse du plan, le robot lit d'abord les règles, puis se rend aux adresses du plan.
Comment les deux fonctionnent-ils ensemble ?
Quand un robot arrive sur un site, il consulte d'abord le fichier robots.txt, apprend les règles et y prend l'adresse du plan du site. Puis il visite les adresses du plan dans l'ordre ; il n'explore pas une adresse bloquée par robots.txt, même si elle figure dans le plan. Cette contradiction est une erreur fréquente sur les sites e-commerce et est traitée dans les sections suivantes : bloquer avec robots.txt une adresse que vous placez dans le plan du site revient à dire au robot à la fois « viens » et « n'entre pas ».
Bloquer avec robots.txt, est-ce la même chose que bloquer avec noindex ?
Non ; robots.txt restreint l'exploration, tandis que noindex demande que la page n'apparaisse pas dans les résultats de recherche. Si le robot ne peut pas entrer sur la page, il ne voit pas non plus la directive noindex qu'elle contient ; pour retirer une page des résultats, la bloquer avec robots.txt n'est donc pas la bonne méthode.
| Objectif | Outil adapté | Remarque |
|---|---|---|
| Vouloir que les robots n'explorent pas du tout une section | robots.txt | Adapté aux zones inutiles comme le panier et le compte |
| Qu'une page n'apparaisse pas dans les résultats de recherche | noindex | Le robot doit pouvoir entrer sur la page pour lire la directive |
| Indiquer laquelle de plusieurs pages similaires est la principale | balise canonical | La page reste ouverte et l'adresse principale est précisée |
| Déplacer une ancienne adresse vers une nouvelle | Redirection 301 | L'adresse qui redirige n'entre pas dans le plan du site |
Pour plus de détails sur les redirections, vous pouvez lire l'article qu'est-ce qu'une redirection 301.
À lire égalementQu’est-ce qu’une redirection 301 ?Quelles pages inclure dans le plan d'un site e-commerce ?
Toute page que vous souhaitez voir apparaître dans les résultats de recherche, qui s'ouvre sans problème et possède sa propre adresse canonical, a sa place dans le plan du site. Comme repère simple : toute page sur laquelle vous seriez heureux qu'un client arrive depuis un résultat de recherche convient.
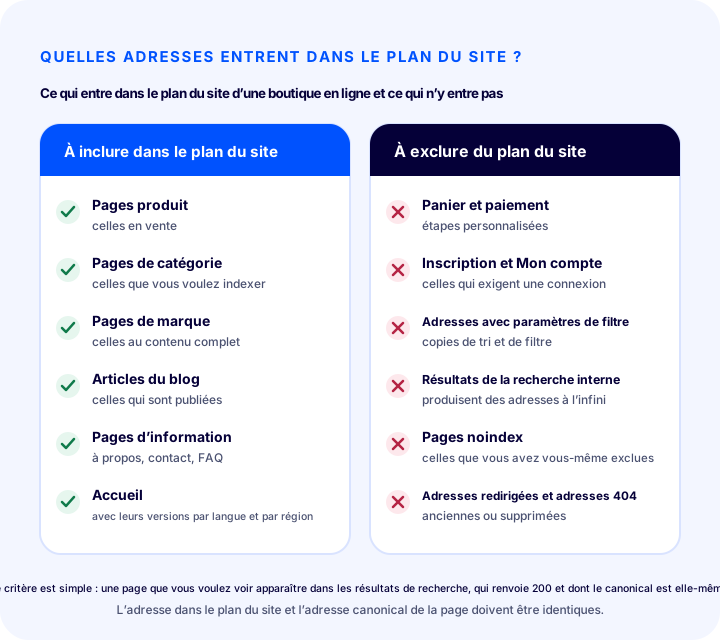
Ce qui doit figurer dans le plan du site
- Pages produit. Produits en vente qui ont une description et une image. Décidez du sort des produits retirés de la vente : s'ils sont retirés définitivement, ils doivent sortir du plan du site et une redirection appropriée doit être mise en place.
- Pages catégorie. Catégories que vous souhaitez indexer et qui ont suffisamment de contenu. Pour savoir comment renforcer les pages catégorie, consultez le guide SEO des pages catégorie.
- Pages marque et collection. Celles dont le contenu est renseigné.
- Articles de blog et guides. Articles publiés qui n'ont pas de doublons.
- Pages d'information et institutionnelles. Pages telles que À propos, Contact et questions fréquentes. Pour les pages légales obligatoires, l'article pages légales d'un site e-commerce sert de guide.
- Page d'accueil. Sur un site multilingue, la page d'accueil de chaque langue, avec les versions linguistiques correspondantes.
Ce qui ne doit pas figurer dans le plan du site
- Étapes de panier, de paiement et de commande. Pages personnelles et sans utilité dans les résultats de recherche.
- Pages d'inscription, de connexion et de mon compte. Toute page qui exige une connexion.
- Adresses avec paramètres de filtre et de tri. Les différentes combinaisons de tri et de filtre d'une même catégorie produisent d'innombrables adresses en double. Pour comprendre pourquoi ces adresses posent problème, consultez l'article sur l'optimisation du filtrage des produits et de la barre de recherche.
- Pages de résultats de recherche interne. Chaque mot saisi par un visiteur peut générer une nouvelle adresse ; il en résulte un réservoir d'adresses sans fin.
- Pages avec une balise noindex. Lister dans le plan du site comme « importante » une page dont vous avez dit « ne pas l'afficher dans les résultats » est incohérent.
- URL redirigées. On liste la destination de la redirection, et non les anciennes adresses qui renvoient ailleurs par une 301.
- URL qui renvoient une 404 ou une erreur. L'adresse d'un produit supprimé ne doit pas rester dans le plan du site.
- Pages en double et pages vides. Une catégorie sans produit, une page d'étiquette sans contenu.
| Type de page | Doit-elle figurer dans le plan du site ? | Justification |
|---|---|---|
| Produit en vente | Oui | Peut se transformer en vente depuis la recherche |
| Catégorie à indexer | Oui | Répond aux recherches larges |
| Article de blog publié | Oui | Amène les internautes en quête d'informations vers la boutique |
| Panier et paiement | Non | Personnel, sans valeur de recherche |
| Pages de compte | Non | Nécessite une connexion |
| URL avec paramètres de filtre | Non | Contenu en double et multiplication des URL |
| Résultats de la recherche interne | Non | URL illimitées et sans valeur |
| Page noindex | Non | Contredit le plan du site |
| URL redirigée par une 301 | Non | Lister l'URL de destination |
| URL renvoyant une 404 | Non | Génère des erreurs et nuit à la confiance |
Comment créer un plan du site
Un plan du site est généralement généré automatiquement par la plateforme d'e-commerce, ou produit avec un outil puis déposé à la racine du site. L'écrire à la main n'a de sens que pour de très petits sites ; à mesure que le nombre de pages augmente, un plan géré manuellement devient inévitablement obsolète.
- Décidez quelles pages doivent y figurer. Appliquez le tableau de la section précédente à votre propre site.
- Générez le plan du site ou activez-le depuis le panneau. Si votre plateforme le génère elle-même, vérifiez son contenu ; sinon, créez-le avec un outil et déposez-le à la racine.
- Vérifiez les URL. Le nom de domaine, l'usage de www, le https et la barre oblique finale sont-ils cohérents ?
- Indiquez l'adresse du plan du site dans le robots.txt. Les robots y trouvent le plan du site.
- Signalez le plan du site dans les outils des moteurs de recherche. Ces outils indiquent si le plan du site est lu et quel est l'état des URL qu'il contient.
- Contrôlez régulièrement. Les nouveaux produits, les catégories supprimées et la modification de la structure des URL se reflètent-ils dans le plan du site ?
Quelles informations faut-il inscrire dans le plan du site, et lesquelles sont superflues ?
L'information essentielle pour chaque URL est l'adresse elle-même. La date de dernière modification (lastmod) est utile, mais seulement si elle est exacte. De nombreuses plateformes génèrent aussi des champs supplémentaires ; leur présence ne nuit pas au plan du site, mais plutôt que de se fier à d'autres champs que l'adresse et une date exacte, il faut que la page elle-même et ses liens internes soient solides.
Quels formats existent ?
Le plan du site est le plus souvent préparé en XML. Un format texte simple est aussi possible ; une URL est écrite par ligne. En e-commerce, on préfère le XML, car il peut porter des informations supplémentaires comme lastmod.
Comment découper un plan du site pour les grands catalogues
Un seul fichier de plan du site est limité à un certain nombre d'URL et à une certaine taille ; lorsque le catalogue grossit, le plan est réparti en plusieurs fichiers et l'on prépare un plan d'index qui liste ces fichiers. Le plan d'index ne contient lui-même aucune URL de page ; il se contente d'énumérer les adresses des sous-plans.
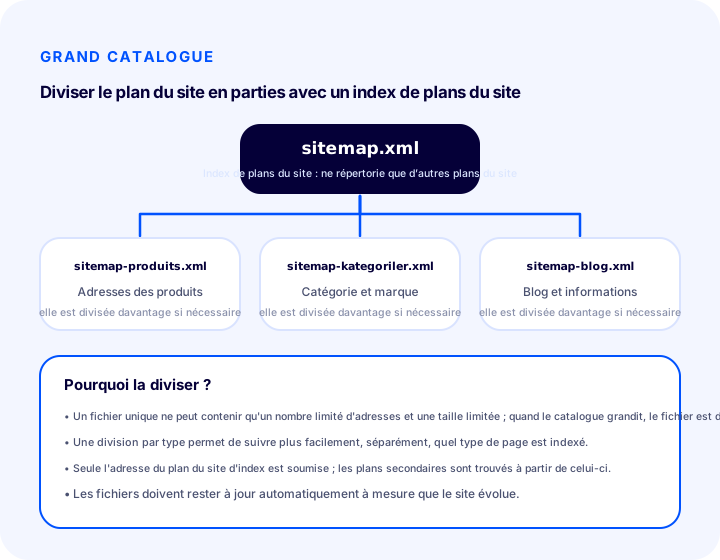
Pour le découpage, le critère le plus utile est souvent le type de page : produits, catégories et marques, blog et pages d'information vont dans des fichiers distincts. Cela présente deux avantages. D'abord, chaque fichier reste dans la limite. Ensuite, dans les outils des moteurs de recherche, vous voyez séparément combien de pages de chaque type sont indexées ; les problèmes des produits apparaissent indépendamment de ceux des catégories. Pour les sites multilingues, séparer par langue est également judicieux.
Le point à retenir est que seule l'adresse du plan d'index est signalée ; les sous-plans sont découverts à partir de là. Vous déterminez le nom et le nombre des fichiers enfants selon la structure de votre site ; les noms de fichiers ci-dessus ne sont donnés qu'à titre d'exemple.
Comment utiliser correctement le champ lastmod
Lastmod est la date qui indique quand le contenu d'une page a été modifié pour la dernière fois de manière significative. Si elle est exacte, elle rappelle aux robots quelles pages revisiter ; si elle est fausse, elle nuit à la crédibilité.
- Indiquez la date de modification réelle. La date est mise à jour lorsque la description, l'image, le prix ou un contenu important d'un produit change.
- Ne ramenez pas chaque jour la date de toutes les pages à aujourd'hui. Si la date est mise à jour alors que rien n'a changé, les robots ne se fient plus à la date et le champ perd sa valeur.
- Ne modifiez pas la date pour de petits changements sans importance. Une date ou un compteur dans le pied de page ne doit pas faire changer la date.
- Utilisez un format de date standard. L'année, le mois et le jour suffisent ; exemple : 2026-11-18.
- Si vous ne connaissez pas la date, ne l'inventez pas. Le champ est facultatif ; mieux vaut le laisser vide que d'indiquer une date fausse.
Il y a encore une distinction : le plan du site ne porte que des URL et des dates ; ce sont les données structurées qui décrivent le contenu de la page. Pour baliser des informations telles que les produits, les prix et les avis à destination des moteurs de recherche, consultez l'article Qu'est-ce que les données structurées.
À lire égalementQu’est-ce que les données structurées ?Comment signaler un plan du site aux moteurs de recherche
Un plan du site se signale de deux façons : en l'inscrivant dans le fichier robots.txt et en l'envoyant via les outils que les moteurs de recherche proposent aux propriétaires de sites. Faire les deux ensemble est la méthode la plus fiable.
- Inscrivez-le dans le robots.txt. Ajoutez à la fin du fichier l'adresse complète du plan du site avec une ligne « Sitemap: ». Les robots la voient dès leur première visite sur le site.
- Validez le site dans les outils des moteurs de recherche. Après avoir prouvé que vous êtes le propriétaire du site, vous saisissez l'adresse du plan du site dans l'outil.
- Suivez l'état. L'outil indique si le plan du site est lu, combien d'URL ont été découvertes et lesquelles renvoient des erreurs.
- Suivez les mises à jour. Si votre plan du site se met à jour automatiquement, inutile de le renvoyer ; il suffit de consulter de temps en temps dans l'outil la date de dernière lecture.
N'attendez pas de résultats rapides après avoir signalé le plan du site ; les moteurs de recherche le lisent selon leur propre calendrier. Mais le rapport d'état est précieux, car il révèle dès le premier jour les URL défectueuses.
Quelles sont les erreurs courantes dans un plan du site ?
L'erreur la plus fréquente est de mettre en place le plan du site une fois, de l'oublier et de le laisser vieillir. Le plan doit vivre avec le site ; les erreurs ci-dessous découlent le plus souvent de cette négligence.
1. URL qui contredisent la canonical
Si l'URL du plan du site pointe, dans la balise canonical de la page, vers une autre URL, le robot est pris entre les deux. Seule l'URL canonical doit être inscrite dans le plan du site.
2. URL redirigées ou renvoyant une 404
Si une ancienne adresse reste dans le plan du site alors qu'elle renvoie ailleurs par une 301 ou génère une erreur, le robot s'y rend pour rien. Le plan ne doit contenir que des pages qui s'ouvrent directement et renvoient un statut 200.
3. Pages noindex restées dans le plan du site
Il n'est pas possible de dire à la fois « indexez ceci » et « cette page est importante ». Si une page est noindex, elle est retirée du plan du site ; ce contrôle doit être automatique pour que le plan reste à jour.
4. URL bloquées par le robots.txt présentes dans le plan du site
Le robot prend l'adresse dans le plan du site mais ne peut pas y accéder à cause d'une règle du robots.txt. Cela apparaît dans l'outil comme une erreur « bloquée » et le plan du site perd sa crédibilité.
5. URL de filtre, de tri et de recherche interne dans le plan du site
Ces URL produisent des pages en double dont le nombre dépasse de plusieurs fois la taille du catalogue ; le plan du site gonfle et le robot ne peut plus consacrer son temps aux pages réellement précieuses.
6. Format d'URL incohérent
Si certaines URL sont écrites avec www et d'autres sans, certaines avec une barre oblique finale et d'autres sans, une incohérence apparaît entre le plan du site et le site. On choisit un seul format et on l'utilise partout de la même façon.
7. Laisser en place un ancien plan du site obsolète
Si l'ancien fichier de plan du site reste en place lorsque la structure des URL change, le robot continue de chercher des pages qui n'existent plus. Lors des refontes, vérifiez que le plan du site a lui aussi été renouvelé.
8. Fichiers de sous-plans non listés
Si vous utilisez un plan d'index, assurez-vous que tous les fichiers enfants y sont listés ; un sous-plan non listé risque de ne pas être lu.
| Erreur | Conséquence | Solution |
|---|---|---|
| URL en contradiction avec la canonical | Le robot ne sait plus à quelle URL se fier | N'inscrire que l'URL canonical dans le plan du site |
| URL renvoyant une 301 ou une 404 | Exploration inutile, rapports d'erreurs | Ne lister que les URL qui renvoient 200 |
| Page noindex | Signal incohérent | Retirer la page noindex du plan du site |
| URL bloquée par le robots.txt | Erreur « bloquée » | Soit lever le blocage, soit retirer l'URL du plan du site |
| URL de filtre et de recherche interne | Plan du site gonflé, contenu en double | Ne pas inclure ces URL dans le plan du site |
| Format d'URL incohérent | Le site et le plan du site ne concordent pas | Choisir un seul format |
Liste de contrôle du plan du site
Avant de publier le plan du site ou lors d'une revue régulière, il suffit de vérifier ces huit points. Si vous pouvez répondre oui à tous, votre plan du site est sain.
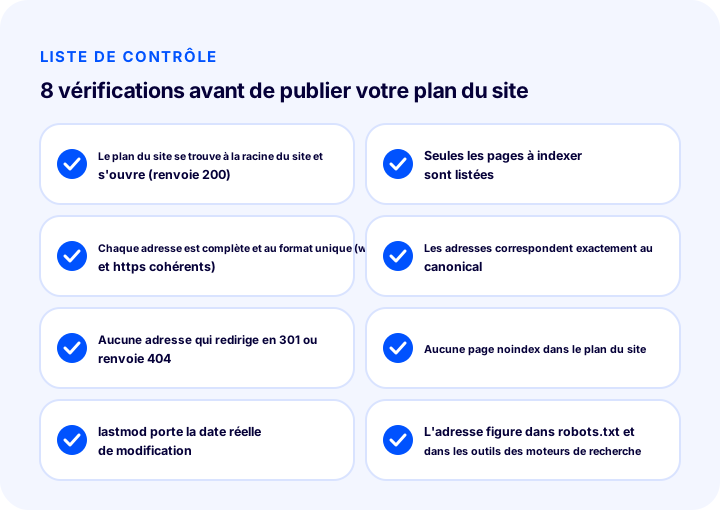
- Le plan du site se trouve à la racine du site et s'ouvre. Ouvrez l'adresse dans un navigateur ; le fichier doit s'afficher et le statut de la page doit être réussi.
- Seules les pages à indexer sont listées. Aucune URL de panier, de compte, de filtre ou de recherche interne.
- Chaque URL est écrite en entier et dans un format unique. Le nom de domaine, www et https sont cohérents.
- Les URL sont strictement identiques aux URL canonical des pages.
- Aucune URL ne redirige par une 301 ou ne renvoie une 404.
- Aucune page noindex ne figure dans le plan du site.
- Lastmod porte la date de modification réelle ou n'est pas utilisé du tout.
- L'adresse du plan du site est inscrite dans le robots.txt et signalée dans les outils des moteurs de recherche.
Comment le plan du site et le robots.txt sont-ils gérés dans Faprika ?
Dans la plateforme d'e-commerce Faprika, la gestion de la canonical, de la balise title, du robots et du plan du site figure sur une même ligne de fonctionnalités. Ainsi, ces réglages qui concernent l'identité d'une page ne sont pas pensés de façon dissociée.
La comparaison des fonctionnalités des offres comprend une ligne « Canonical / Gestion des balises H / Robots / Sitemap » ; sa portée peut varier selon les offres, et pour plus de détails vous pouvez consulter la page des offres e-commerce. En dehors des tâches liées au plan du site, d'autres lignes soutiennent le volet SEO : « Panneau 301 / 302 / 410 / Gestion des enregistrements d'URL » sert à gérer les redirections lors des changements d'adresse, « Mise à jour automatique en masse des informations SEO/Meta » à modifier en bloc les champs de titre et de description, et « Rapports SEO » à suivre l'état. L'offre qui comprend ces fonctionnalités se voit aussi dans la comparaison des offres.
Pour savoir où et comment se font les réglages SEO généraux dans le panneau Faprika, le guide Comment configurer le SEO e-commerce et la page de formation Paramètres SEO vous guideront. Si votre boutique présente un cas particulier lié au plan du site, par exemple une structure multilingue ou un grand catalogue, vous pouvez poser la question à notre équipe lors de la démonstration.
Questions fréquentes
Qu'est-ce qu'un plan du site ?
Un plan du site est un fichier qui liste les adresses des pages d'un site web dont vous souhaitez l'indexation et les présente aux robots des moteurs de recherche. Sa forme la plus courante est le fichier sitemap.xml à la racine du site ; il aide les robots à découvrir plus vite les pages nouvelles et modifiées.
Un plan du site est-il la même chose que robots.txt ?
Non. Un plan du site indique aux robots quelles pages sont importantes, tandis que robots.txt précise où ils ne doivent pas aller. Les deux s'utilisent ensemble : l'adresse du plan du site est écrite dans robots.txt, et un robot lit d'abord les règles puis se rend aux adresses du plan.
Chaque site d'e-commerce a-t-il besoin d'un plan du site ?
En pratique, oui. Pour les sites d'e-commerce comptant de nombreux produits et des pages qui changent en permanence, un plan du site accélère la découverte des nouveaux produits et catégories et facilite le suivi des problèmes techniques. Un plan du site ne garantit rien, mais il réduit les pertes.
Quelles pages ne doivent pas figurer dans le plan du site ?
Les pages panier, paiement, inscription et compte, les adresses avec paramètres de filtre et de tri, les résultats de recherche interne, les pages noindex, les adresses redirigées ailleurs et celles qui renvoient 404 ne doivent pas figurer dans le plan du site. Il ne contient que les pages que vous souhaitez indexer, qui s'ouvrent sans problème et ont leur propre adresse canonical.
Comment soumettre un plan du site aux moteurs de recherche ?
L'adresse du plan du site est inscrite dans le fichier robots.txt par une ligne « Sitemap: » et soumise aussi via les outils que les moteurs de recherche proposent aux propriétaires de sites. L'outil indique également si le plan a été lu et l'état des adresses qu'il contient.
Comment gérer le plan du site quand le catalogue grandit ?
Un fichier de plan du site ne peut contenir qu'un nombre limité d'adresses et une taille limitée ; pour les grands catalogues, le plan est réparti en plusieurs fichiers selon le type de page et un plan d'index listant ces fichiers est préparé. Seule l'adresse du plan d'index est soumise. Le plan doit se mettre à jour automatiquement à mesure que des produits sont ajoutés et retirés.


