
Inhalt 12 Abschnitte
- Was ist eine Sitemap?
- Warum ist eine Sitemap für E-Commerce wichtig?
- Was ist robots.txt und wie unterscheidet sie sich von einer Sitemap?
- Welche Seiten gehören in die Sitemap eines E-Commerce-Shops?
- So erstellen Sie eine Sitemap
- So teilen Sie die Sitemap bei großen Katalogen auf
- So verwenden Sie das Feld lastmod richtig
- So reichen Sie die Sitemap bei Suchmaschinen ein
- Welche Fehler treten bei Sitemaps häufig auf?
- Checkliste für Ihre Sitemap
- Wie werden Sitemap und robots.txt in Faprika verwaltet?
- Häufig gestellte Fragen
Sie haben Ihrem Shop eine neue Kategorie hinzugefügt und Hunderte Produkte aktualisiert, sehen aber auch Wochen später noch nichts davon in den Suchergebnissen. Oder umgekehrt: In den Suchergebnissen erscheinen Warenkorb-, Konto- und Filteradressen, während die Seiten, die Sie eigentlich verkaufen möchten, zurückfallen. Die gemeinsame Ursache beider Probleme ist oft dieselbe: Sie haben den Suchmaschinen-Robotern nicht klar mitgeteilt, welche Seiten Ihrer Website wichtig sind. Das grundlegendste Werkzeug dafür ist die Sitemap.
In diesem Leitfaden beantworten wir die Frage, was eine Sitemap ist, aus Sicht des E-Commerce: was die Datei sitemap.xml ist und was sie enthält, wie sie sich von robots.txt unterscheidet und wie beide zusammenarbeiten, welche Adressen in die Sitemap eines E-Commerce-Shops gehören und welche nicht, wie die Sitemap bei großen Katalogen aufgeteilt wird, wie das Feld lastmod richtig verwendet wird, wie die Sitemap bei Suchmaschinen eingereicht wird, häufige Fehler und eine Checkliste für die Zeit vor der Veröffentlichung. Am Ende finden Sie den Bezug zu Faprika und eine FAQ mit sechs Fragen.
Was ist Sitemap?
Eine Sitemap ist eine Datei, die die Adressen der Seiten einer Website auflistet, die indexiert werden sollen, und diese den Suchmaschinen-Robotern bereitstellt. Ihre häufigste Form ist die XML-Datei im Stammverzeichnis der Website, die meist sitemap.xml heißt.
Suchmaschinen-Roboter durchsuchen eine Website meist, indem sie Links folgen: Sie wechseln von einer Seite zur nächsten und entdecken neue Adressen. Diese Methode funktioniert oft, ist aber nicht fehlerfrei. Wenn eine neu hinzugefügte Seite nirgendwo verlinkt ist, wenn man für eine tief liegende Produktseite viele Klicks braucht oder wenn die Website sehr groß ist, werden manche Seiten spät oder gar nicht entdeckt. Eine Sitemap schließt diese Lücke: Sie gibt dem Roboter vor dem Crawlen eine Liste.
Man sollte von Anfang an wissen, dass eine Sitemap nichts garantiert. Dass eine in der Sitemap aufgeführte Seite indexiert wird oder weit oben rankt, ist nicht sicher; die Sitemap ist ein Hinweis, kein Befehl. Aber es ist ein starker Hinweis und macht vor allem bei neuen, tief liegenden oder häufig geänderten Seiten einen Unterschied.
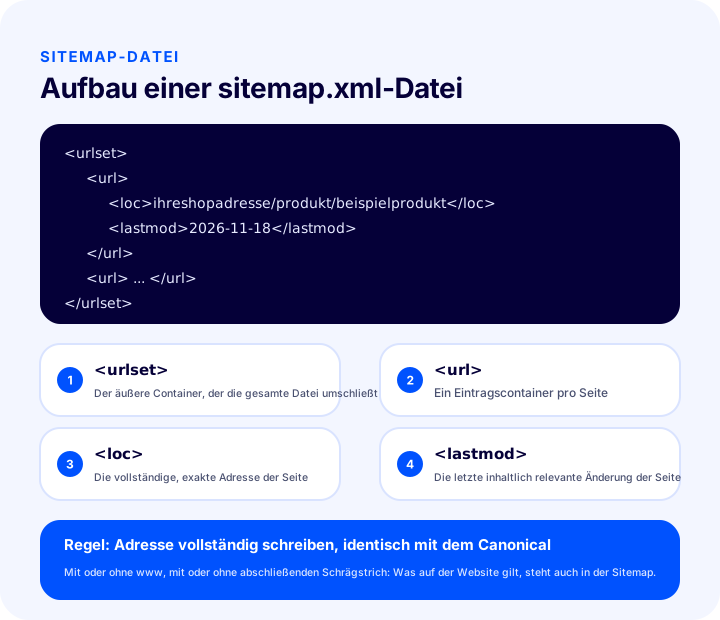
Wie die Abbildung zeigt, besteht die Datei aus wenigen einfachen Tags. Das äußerste Tag urlset umschließt alle Einträge, jede Seite steht in einem url-Block, loc enthält die vollständige Adresse der Seite und lastmod das Datum der letzten wesentlichen Änderung der Seite. Das folgende Beispiel zeigt den Inhalt einer Sitemap mit einer Seite; „magazaadresiniz“ steht für Ihren Domainnamen.
<urlset>
  <url>
    <loc>magazaadresiniz/urun/ornek-urun</loc>
    <lastmod>2026-11-18</lastmod>
  </url>
</urlset>| Tag | Aufgabe | Pflichtfeld? |
|---|---|---|
| urlset | Das Wurzel-Element, das alle Adressen der Datei umfasst | Ja |
| url | Ein Eintrag pro Seite | Ja |
| loc | Die vollständige Adresse der Seite | Ja |
| lastmod | Datum der letzten wesentlichen Änderung der Seite | Nein, aber bei richtiger Verwendung nützlich |
Eine Sitemap muss nicht zwingend XML sein; Websites haben auch „Sitemap“-Seiten für Besucher. In diesem Beitrag geht es um die XML-Datei für Roboter. Eine schlichte Linkliste für Besucher dient dagegen der Nutzererfahrung und trägt zur internen Verlinkungsstruktur bei.
Warum ist eine Sitemap für E-Commerce wichtig?
E-Commerce-Shops enthalten viele, sich ständig ändernde Seiten und gehören daher zu den Website-Typen, die am meisten von einer Sitemap profitieren. Produkte kommen hinzu, Preise und Bestände ändern sich, Kategorien werden neu geordnet, Kampagnenseiten werden geöffnet und geschlossen.
- Neue Produkte werden schneller entdeckt. Ein im Shop hinzugefügtes Produkt erscheint in der Sitemap, und der Roboter muss es nicht in einer Linkkette suchen.
- Tief liegende Seiten gehen nicht verloren. Produkte hinter Kategorien, Unterkategorien und Seitennummerierung sind womöglich nur schwer erreichbar; die Sitemap liefert die Adresse direkt.
- Das Crawl-Budget wird nicht unnötig verbraucht. Die Zeit und die Anzahl der Anfragen, die Roboter einer Website widmen, sind begrenzt. Enthält die Sitemap nur wertvolle Seiten, richtet sich die Aufmerksamkeit des Roboters darauf.
- Probleme werden früh sichtbar. In den Tools der Suchmaschinen lässt sich prüfen, wie viele der Adressen der Sitemap indexiert wurden und welche Fehler lieferten; das ist eine der praktischsten Methoden, technische Probleme aufzudecken.
- Große Änderungen werden bekannt gemacht. Nach einem Redesign, einer Änderung der Adressstruktur oder einer Massenaktualisierung der Produkte hilft eine aktuelle Sitemap dabei, dass der neue Stand schnell erkannt wird.
Was ist robots.txt und wie unterscheidet sie sich von einer Sitemap?
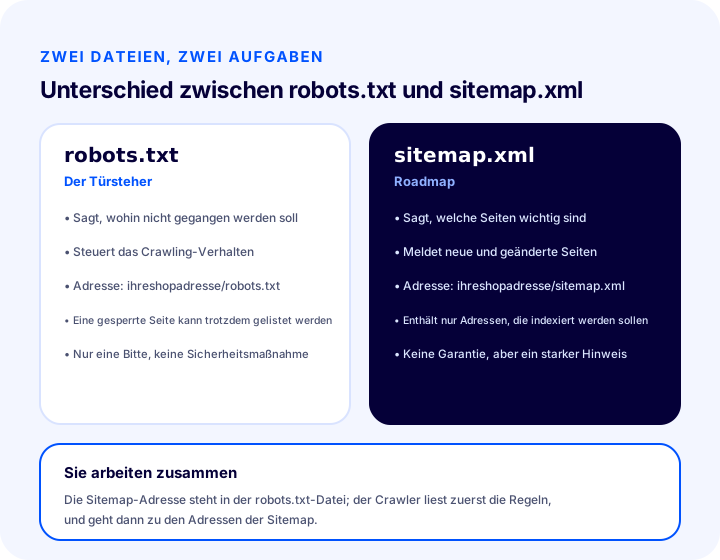
Robots.txt ist eine Textdatei im Stammverzeichnis der Website, die den Suchmaschinen-Robotern mitteilt, welche Bereiche sie nicht betreten sollen. Die Sitemap sagt „kommen Sie hierher“, robots.txt sagt „gehen Sie hier nicht hinein“; das eine ist eine Einladung, das andere eine Grenze.
| Funktion | robots.txt | sitemap.xml |
|---|---|---|
| Was sagt sie aus? | Wohin Roboter nicht gehen sollen | Welche Seiten wichtig sind |
| Rolle | Steuert das Crawling-Verhalten | Unterstützt die Entdeckung und die Crawl-Priorität |
| Format | Regeln als Klartext | XML-Liste von Adressen |
| Standort | Stammverzeichnis der Website | Meist das Stammverzeichnis der Website; die Adresse wird in der robots.txt angegeben |
| Ein Sicherheitswerkzeug? | Nein, nur eine Bitte | Nein |
| Verhindert sie allein die Indexierung? | Nein, sie schränkt nur das Crawling ein | Nein |
Eine robots.txt-Datei sieht einfach aus. Im folgenden Beispiel werden für alle Roboter die Bereiche Warenkorb und Konto nicht gecrawlt, und die Adresse der Sitemap steht am Ende. Die Pfade sind als Beispiele angegeben; sie richten sich nach den tatsächlichen Adressen Ihrer eigenen Website.
User-agent: *
Disallow: /sepet
Disallow: /uye

Sitemap: magazaadresiniz/sitemap.xml
Die letzte Zeile ist wichtig: Die Adresse der Sitemap in die robots.txt zu schreiben, ist ein einfacher und zuverlässiger Weg, damit Roboter die Sitemap automatisch finden. So liest der Roboter auch ohne gesonderte Meldung der Sitemap-Adresse zuerst die Regeln und ruft dann die Adressen der Sitemap auf.
Wie arbeiten beide zusammen?
Wenn ein Roboter eine Website aufruft, schaut er zuerst in die Datei robots.txt, lernt die Regeln kennen und entnimmt dort die Adresse der Sitemap. Dann besucht er die Adressen der Sitemap der Reihe nach; eine per robots.txt gesperrte Adresse crawlt er nicht, selbst wenn sie in der Sitemap steht. Dieser Widerspruch ist ein häufiger Fehler in E-Commerce-Shops und wird in den folgenden Abschnitten behandelt: Eine Adresse, die Sie in die Sitemap aufnehmen, per robots.txt zu sperren, heißt, dem Roboter zugleich „komm“ und „geh nicht hinein“ zu sagen.
Ist das Sperren per robots.txt dasselbe wie das Sperren per noindex?
Nein; robots.txt schränkt das Crawling ein, noindex dagegen verlangt, dass die Seite nicht in den Suchergebnissen erscheint. Kann der Roboter die Seite nicht betreten, sieht er auch die noindex-Anweisung auf ihr nicht; wenn Sie eine Seite aus den Ergebnissen entfernen möchten, ist das Sperren per robots.txt daher nicht der richtige Weg.
| Zweck | Passendes Werkzeug | Hinweis |
|---|---|---|
| Wenn Roboter einen Bereich gar nicht crawlen sollen | robots.txt | Geeignet für nutzlose Bereiche wie Warenkorb und Konto |
| Wenn eine Seite nicht in den Suchergebnissen erscheinen soll | noindex | Der Roboter muss die Seite betreten können, um die Anweisung zu lesen |
| Festlegen, welche von mehreren ähnlichen Seiten die Hauptseite ist | Canonical-Tag | Die Seite bleibt erreichbar und die Hauptadresse wird angegeben |
| Eine alte Adresse auf eine neue umziehen | 301-Weiterleitung | Die weiterleitende Adresse kommt nicht in die Sitemap |
Einzelheiten zu Weiterleitungen finden Sie im Beitrag Was ist eine 301-Weiterleitung?.
LesempfehlungWas ist eine 301-Weiterleitung?Welche Seiten gehören in die Sitemap eines E-Commerce-Shops?
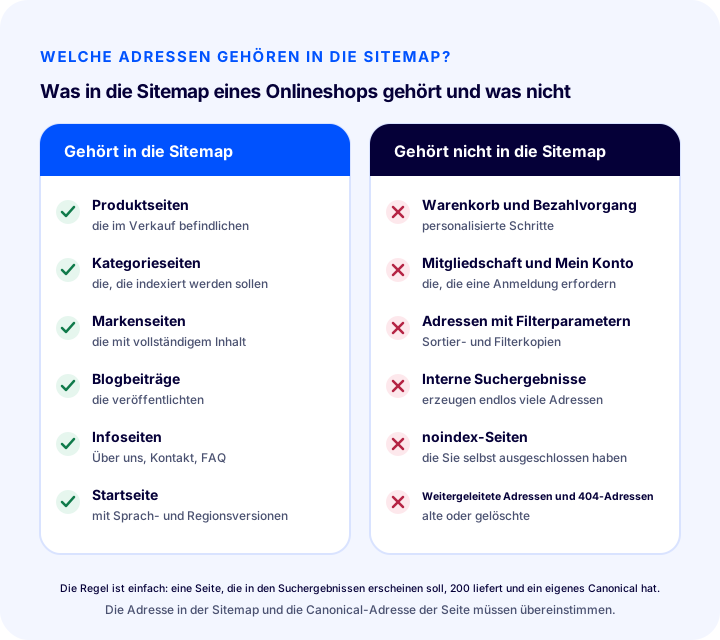
In die Sitemap gehört jede Seite, die in den Suchergebnissen erscheinen soll, problemlos aufrufbar ist und eine eigene Canonical-Adresse hat. Als einfacher Maßstab gilt: Jede Seite, auf der ein Kunde aus den Suchergebnissen landen darf, ohne dass es Ihnen unangenehm wäre, ist geeignet.
Was in die Sitemap gehört
- Produktseiten. Produkte im Verkauf, die eine Beschreibung und ein Bild haben. Entscheiden Sie, was mit aus dem Verkauf genommenen Produkten geschieht: Wurden sie dauerhaft entfernt, müssen sie aus der Sitemap genommen und eine passende Weiterleitung eingerichtet werden.
- Kategorieseiten. Kategorien, die indexiert werden sollen und ausreichend Inhalt haben. Wie Sie Kategorieseiten stärken, lesen Sie im Leitfaden SEO für Kategorieseiten.
- Marken- und Kollektionsseiten. Solche mit ausgefülltem Inhalt.
- Blogbeiträge und Leitfäden. Veröffentlichte Beiträge, die keine Duplikate haben.
- Informations- und Unternehmensseiten. Seiten wie „Über uns“, „Kontakt“ und häufig gestellte Fragen. Für die vorgeschriebenen rechtlichen Seiten dient der Beitrag Rechtliche Seiten für einen E-Commerce-Shop als Orientierung.
- Startseite. Bei einer mehrsprachigen Website die Startseite jeder Sprache zusammen mit den zugehörigen Sprachversionen.
Was nicht in die Sitemap gehört
- Warenkorb-, Kassen- und Bestellschritte. Persönliche Seiten, die in den Suchergebnissen nutzlos sind.
- Mitglieds-, Anmelde- und Kontoseiten. Jede Seite, die eine Anmeldung erfordert.
- Adressen mit Filter- und Sortierparametern. Verschiedene Sortier- und Filterkombinationen derselben Kategorie erzeugen unzählige doppelte Adressen. Warum diese Adressen Probleme verursachen, lesen Sie im Beitrag Optimierung von Produktfiltern und Suchleiste.
- Seiten mit internen Suchergebnissen. Jedes vom Besucher eingegebene Wort kann eine neue Adresse erzeugen; es entsteht ein uferloser Adresspool.
- Seiten mit noindex-Tag. Eine Seite, bei der Sie sagen „diese Seite soll nicht in den Ergebnissen erscheinen“, in der Sitemap als „wichtig“ aufzuführen, ist widersprüchlich.
- Weitergeleitete Adressen. Aufgeführt wird das Ziel der Weiterleitung, nicht die alten Adressen, die per 301 auf eine andere Adresse verweisen.
- Adressen, die 404 oder einen Fehler liefern. Die Adresse eines gelöschten Produkts darf nicht in der Sitemap bleiben.
- Doppelte und leere Seiten. Eine Kategorie ohne Produkte, eine Tag-Seite ohne Inhalt.
| Seitentyp | Gehört sie in die Sitemap? | Begründung |
|---|---|---|
| Zum Verkauf stehendes Produkt | Ja | Kann aus der Suche zum Verkauf führen |
| Zu indexierende Kategorie | Ja | Deckt breite Suchanfragen ab |
| Veröffentlichter Blogbeitrag | Ja | Führt Informationssuchende in den Shop |
| Warenkorb und Bezahlvorgang | Nein | Persönlich, ohne Suchwert |
| Kontoseiten | Nein | Erfordert eine Anmeldung |
| Adresse mit Filterparametern | Nein | Doppelte Inhalte und Adressvermehrung |
| Interne Suchergebnisse | Nein | Unbegrenzte, wertlose Adressen |
| noindex-Seite | Nein | Widerspricht der Sitemap |
| Per 301 weitergeleitete Adresse | Nein | Die Zieladresse auflisten |
| Adresse mit 404 | Nein | Verursacht Fehler und schadet dem Vertrauen |
So erstellen Sie eine Sitemap
Eine Sitemap wird in der Regel automatisch von der E-Commerce-Plattform erzeugt oder mit einem Tool erstellt und im Stammverzeichnis der Website abgelegt. Von Hand zu schreiben ist nur bei sehr kleinen Websites sinnvoll; mit wachsender Seitenzahl veraltet eine manuell gepflegte Sitemap zwangsläufig.
- Entscheiden Sie, welche Seiten aufgenommen werden sollen. Wenden Sie die Tabelle aus dem vorigen Abschnitt auf Ihre eigene Website an.
- Erzeugen Sie die Sitemap oder aktivieren Sie sie im Panel. Erzeugt Ihre Plattform sie selbst, prüfen Sie den Inhalt; falls nicht, erstellen Sie sie mit einem Tool und laden Sie sie ins Stammverzeichnis hoch.
- Prüfen Sie die Adressen. Sind Domain, www-Verwendung, https und der abschließende Schrägstrich einheitlich?
- Tragen Sie die Sitemap-Adresse in die robots.txt ein. Crawler finden die Sitemap dort.
- Melden Sie die Sitemap in den Tools der Suchmaschinen. Die Tools zeigen, ob die Sitemap gelesen wird und welchen Status die enthaltenen Adressen haben.
- Kontrollieren Sie regelmäßig. Spiegeln sich neue Produkte, gelöschte Kategorien und eine geänderte Adressstruktur in der Sitemap wider?
Welche Angaben gehören in die Sitemap, welche sind überflüssig?
Die wesentliche Angabe zu jeder Adresse ist die Adresse selbst. Das Datum der letzten Änderung (lastmod) ist nützlich, aber nur, wenn es stimmt. Viele Plattformen erzeugen zusätzlich weitere Felder; ihr Vorhandensein schadet der Sitemap nicht, doch statt sich auf Felder außer der Adresse und einem korrekten Datum zu verlassen, sollten die Seite selbst und ihre internen Links stark sein.
Welche Formate gibt es?
Sitemaps werden meist als XML erstellt. Auch ein einfaches Textformat ist möglich; pro Zeile wird eine Adresse geschrieben. Im E-Commerce wird XML bevorzugt, weil es zusätzliche Angaben wie lastmod aufnehmen kann.
So teilen Sie eine Sitemap bei großen Katalogen auf
Eine einzelne Sitemap-Datei ist auf eine bestimmte Anzahl von Adressen und eine bestimmte Dateigröße begrenzt; wächst der Katalog, wird die Sitemap auf mehrere Dateien aufgeteilt und eine Index-Sitemap erstellt, die diese Dateien auflistet. Die Index-Sitemap enthält selbst keine Seitenadressen, sondern führt nur die Adressen der Unter-Sitemaps auf.
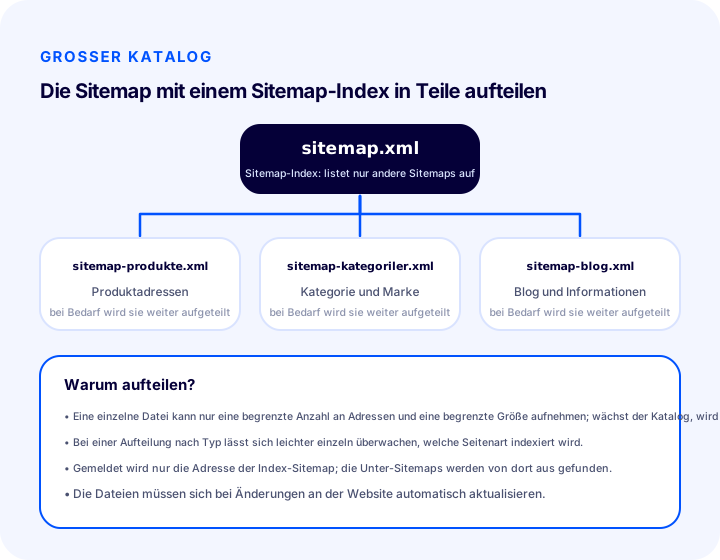
Zum Aufteilen ist der Seitentyp oft das nützlichste Kriterium: Produkte, Kategorien und Marken sowie Blog- und Informationsseiten kommen in getrennte Dateien. Das hat zwei Vorteile. Erstens bleibt jede Datei innerhalb der Grenze. Zweitens sehen Sie in den Tools der Suchmaschinen getrennt, wie viele Seiten welchen Typs indexiert sind; Probleme bei Produkten treten unabhängig von den Kategorien zutage. Bei mehrsprachigen Websites ist auch eine Trennung nach Sprache sinnvoll.
Zu beachten ist, dass nur die Adresse der Index-Sitemap gemeldet wird; die Unter-Sitemaps werden von dort aus gefunden. Namen und Anzahl der Unterdateien legen Sie nach der Struktur Ihrer Website fest; die obigen Dateinamen dienen nur als Beispiel.
So verwenden Sie das lastmod-Feld richtig
lastmod ist das Datum, das angibt, wann sich der Inhalt einer Seite zuletzt in bedeutsamer Weise geändert hat. Ist es korrekt, erinnert es Crawler daran, welche Seiten sie erneut besuchen sollten; ist es falsch, mindert es die Glaubwürdigkeit.
- Tragen Sie das tatsächliche Änderungsdatum ein. Das Datum wird aktualisiert, wenn sich Beschreibung, Bild, Preis oder wichtiger Inhalt eines Produkts ändert.
- Setzen Sie nicht täglich das Datum aller Seiten auf heute. Wird das Datum aktualisiert, obwohl sich nichts geändert hat, vertrauen Crawler dem Datum nicht mehr und das Feld verliert seinen Wert.
- Ändern Sie das Datum nicht bei kleinen, unbedeutenden Änderungen. Ein Datum oder ein Zähler im Seitenfuß sollte das Datum nicht verändern.
- Verwenden Sie ein Standard-Datumsformat. Jahr, Monat und Tag genügen; Beispiel: 2026-11-18.
- Wenn Sie das Datum nicht kennen, erfinden Sie keines. Das Feld ist optional; es leer zu lassen ist besser, als ein falsches Datum einzutragen.
Noch ein Unterschied: Die Sitemap enthält nur Adressen und Daten; was der Inhalt der Seite aussagt, beschreiben strukturierte Daten. Wie Sie Informationen wie Produkte, Preise und Bewertungen für Suchmaschinen auszeichnen, erfahren Sie im Beitrag Was sind strukturierte Daten.
LesempfehlungWas sind strukturierte Daten?So melden Sie die Sitemap bei Suchmaschinen
Eine Sitemap wird auf zwei Wegen gemeldet: durch Eintragen in die robots.txt-Datei und durch Übermitteln über die Tools, die Suchmaschinen Website-Betreibern anbieten. Beides zusammen ist die sicherste Methode.
- Tragen Sie sie in die robots.txt ein. Fügen Sie am Ende der Datei mit einer „Sitemap:“-Zeile die vollständige Adresse der Sitemap hinzu. Crawler sehen sie, sobald sie die Website zum ersten Mal besuchen.
- Bestätigen Sie die Website in den Tools der Suchmaschinen. Nachdem Sie nachgewiesen haben, dass Sie der Website-Inhaber sind, geben Sie die Adresse der Sitemap im Tool ein.
- Behalten Sie den Status im Blick. Das Tool zeigt, ob die Sitemap gelesen wird, wie viele Adressen entdeckt wurden und welche Fehler liefern.
- Verfolgen Sie Aktualisierungen. Aktualisiert sich Ihre Sitemap automatisch, müssen Sie sie nicht erneut melden; es genügt, im Tool ab und zu das Datum des letzten Lesevorgangs zu prüfen.
Erwarten Sie nach dem Melden der Sitemap nicht schnell Ergebnisse; Suchmaschinen lesen sie nach ihrem eigenen Zeitplan. Der Statusbericht ist jedoch wertvoll, weil er fehlerhafte Adressen von Anfang an zeigt.
Was sind häufige Fehler bei Sitemaps?
Der häufigste Fehler ist, die Sitemap einmal einzurichten, zu vergessen und mit der Zeit veralten zu lassen. Die Sitemap sollte mit der Website leben; die folgenden Fehler entstehen meist aus dieser Vernachlässigung.
1. Adressen, die dem Canonical widersprechen
Verweist die Adresse in der Sitemap im Canonical-Tag der Seite auf eine andere Adresse, steckt der Crawler zwischen beiden fest. In die Sitemap gehört nur die Canonical-Adresse.
2. Weitergeleitete Adressen oder Adressen mit 404
Bleibt eine alte Adresse in der Sitemap, die per 301 woandershin führt oder einen Fehler liefert, läuft der Crawler ins Leere. Die Sitemap sollte nur Seiten enthalten, die direkt aufgerufen werden können und den Status 200 liefern.
3. noindex-Seiten, die in der Sitemap verbleiben
Gleichzeitig „indexieren“ und „diese Seite ist wichtig“ zu sagen, ist nicht möglich. Ist eine Seite noindex, wird sie aus der Sitemap entfernt; diese Prüfung sollte automatisch erfolgen, damit die Sitemap aktuell bleibt.
4. Durch robots.txt gesperrte Adressen in der Sitemap
Der Crawler entnimmt die Adresse der Sitemap, darf sie aber wegen einer robots.txt-Regel nicht aufrufen. Im Tool erscheint das als Fehler „blockiert“, und die Sitemap verliert an Glaubwürdigkeit.
5. Filter-, Sortier- und interne Suchadressen in der Sitemap
Diese Adressen erzeugen doppelte Seiten in der vielfachen Größe des Katalogs; die Sitemap bläht sich auf, und der Crawler kann keine Zeit auf die wirklich wertvollen Seiten verwenden.
6. Uneinheitliches Adressformat
Werden manche Adressen mit www und andere ohne, manche mit und manche ohne abschließenden Schrägstrich geschrieben, entsteht eine Unstimmigkeit zwischen Sitemap und Website. Es wird ein einziges Format gewählt und überall gleich verwendet.
7. Eine alte, tote Sitemap bleibt bestehen
Bleibt die alte Sitemap-Datei bei einer Änderung der Adressstruktur bestehen, sucht der Crawler weiter nach Seiten, die es nicht mehr gibt. Prüfen Sie bei Umstrukturierungen, dass auch die Sitemap erneuert wurde.
8. Nicht aufgeführte Unter-Sitemap-Dateien
Wenn Sie eine Index-Sitemap verwenden, stellen Sie sicher, dass alle Unterdateien im Index aufgeführt sind; eine nicht aufgeführte Unter-Sitemap wird möglicherweise nicht gelesen.
| Fehler | Folge | Lösung |
|---|---|---|
| Adresse im Widerspruch zum Canonical | Der Crawler weiß nicht, welcher Adresse er vertrauen soll | Nur die Canonical-Adresse in die Sitemap schreiben |
| Adresse mit 301 oder 404 | Verschwendetes Crawling, Fehlerberichte | Nur Adressen mit 200 auflisten |
| noindex-Seite | Widersprüchliches Signal | Die noindex-Seite aus der Sitemap entfernen |
| Durch robots.txt gesperrte Adresse | Fehler „blockiert“ | Entweder die Sperre aufheben oder die Adresse aus der Sitemap entfernen |
| Filter- und interne Suchadressen | Aufgeblähte Sitemap, doppelte Inhalte | Diese Adressen nicht in die Sitemap aufnehmen |
| Uneinheitliches Adressformat | Website und Sitemap stimmen nicht überein | Ein einziges Format festlegen |
Checkliste für die Sitemap
Bevor Sie die Sitemap veröffentlichen oder wenn Sie sie regelmäßig überprüfen, genügt ein Blick auf diese acht Punkte. Können Sie alle mit Ja beantworten, ist Ihre Sitemap in Ordnung.
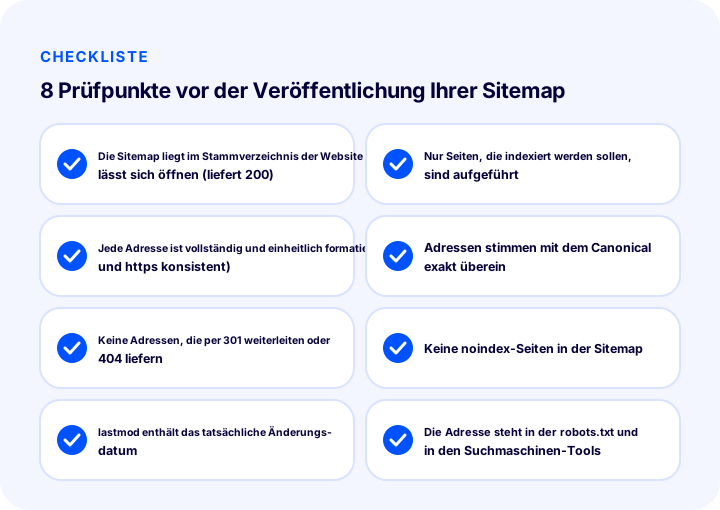
- Die Sitemap liegt im Stammverzeichnis der Website und lässt sich öffnen. Öffnen Sie die Adresse im Browser; die Datei sollte geladen werden und der Seitenstatus erfolgreich sein.
- Es sind nur Seiten aufgeführt, die indexiert werden sollen. Keine Warenkorb-, Konto-, Filter- oder internen Suchadressen.
- Jede Adresse ist vollständig und in einem einheitlichen Format geschrieben. Domain, www und https sind einheitlich.
- Die Adressen stimmen exakt mit den Canonical-Adressen der Seiten überein.
- Es gibt keine Adressen, die per 301 weiterleiten oder 404 liefern.
- Keine noindex-Seite steht in der Sitemap.
- lastmod enthält das tatsächliche Änderungsdatum oder wird gar nicht verwendet.
- Die Sitemap-Adresse steht in der robots.txt und ist in den Tools der Suchmaschinen gemeldet.
Wie werden Sitemap und robots.txt in Faprika verwaltet?
In der E-Commerce-Plattform von Faprika sind Canonical-, Title-Tag-, Robots- und Sitemap-Verwaltung in einer gemeinsamen Funktionszeile zusammengefasst. So werden diese Einstellungen, die die Identität einer Seite betreffen, nicht losgelöst voneinander betrachtet.
Im Funktionsvergleich der Pakete gibt es die Zeile „Canonical / H-Tag-Verwaltung / Robots / Sitemap“; ihr Umfang kann je nach Paket variieren, Einzelheiten finden Sie auf der Seite E-Commerce-Pakete. Neben Aufgaben rund um die Sitemap gibt es weitere Zeilen, die die SEO-Seite unterstützen: „301 / 302 / 410-Panel / Verwaltung von Adresseinträgen“ dient der Verwaltung von Weiterleitungen bei Adressänderungen, „Automatische Massenaktualisierung von SEO-/Meta-Angaben“ der gesammelten Bearbeitung von Titel- und Beschreibungsfeldern und „SEO-Berichte“ der Überwachung des Status. In welchem Paket diese Funktionen enthalten sind, sehen Sie ebenfalls im Paketvergleich.
Wo und wie die allgemeinen SEO-Einstellungen im Faprika-Panel vorgenommen werden, erfahren Sie im Ratgeber E-Commerce-SEO-Einstellungen vornehmen und auf der Schulungsseite SEO-Einstellungen. Hat Ihr Shop einen Sonderfall rund um die Sitemap, zum Beispiel eine mehrsprachige Struktur oder einen großen Katalog, können Sie unser Team im Demo-Gespräch danach fragen.
Häufig gestellte Fragen
Was ist eine Sitemap?
Eine Sitemap ist eine Datei, die die Adressen der Seiten einer Website auflistet, die indexiert werden sollen, und diese den Suchmaschinen-Robotern bereitstellt. Ihre häufigste Form ist die Datei sitemap.xml im Stammverzeichnis der Website; sie hilft den Robotern, neue und geänderte Seiten schneller zu entdecken.
Ist eine Sitemap dasselbe wie robots.txt?
Nein. Eine Sitemap sagt den Robotern, welche Seiten wichtig sind, während robots.txt festlegt, wohin sie nicht gehen sollen. Beide werden gemeinsam eingesetzt: Die Adresse der Sitemap steht in der robots.txt, und ein Roboter liest zuerst die Regeln und ruft dann die Adressen der Sitemap auf.
Braucht jede E-Commerce-Website eine Sitemap?
In der Praxis ja. Für E-Commerce-Websites mit vielen Produkten und ständig wechselnden Seiten beschleunigt eine Sitemap die Entdeckung neuer Produkte und Kategorien und erleichtert die Überwachung technischer Probleme. Eine Sitemap garantiert nichts, aber sie verringert Verluste.
Welche Seiten gehören nicht in die Sitemap?
Warenkorb-, Kassen-, Mitglieds- und Kontoseiten, Adressen mit Filter- und Sortierparametern, interne Suchergebnisse, noindex-Seiten, auf eine andere Adresse weitergeleitete Adressen und Adressen, die 404 liefern, gehören nicht in die Sitemap. In der Sitemap stehen nur Seiten, die indexiert werden sollen, problemlos aufrufbar sind und eine eigene Canonical-Adresse haben.
Wie wird eine Sitemap bei Suchmaschinen eingereicht?
Die Adresse der Sitemap wird mit einer Zeile „Sitemap:“ in die Datei robots.txt geschrieben und zusätzlich über die Tools eingereicht, die Suchmaschinen Website-Betreibern anbieten. Das Tool zeigt auch, ob die Sitemap gelesen wurde und wie der Status der enthaltenen Adressen ist.
Wie verwaltet man eine Sitemap, wenn der Katalog wächst?
Eine einzelne Sitemap-Datei kann nur eine begrenzte Anzahl an Adressen und eine begrenzte Größe aufnehmen; bei großen Katalogen wird die Sitemap nach Seitentyp auf mehrere Dateien aufgeteilt und eine Index-Sitemap erstellt, die diese Dateien auflistet. Gemeldet wird nur die Adresse der Index-Sitemap. Die Sitemap sollte sich automatisch aktualisieren, wenn Produkte hinzukommen oder entfernt werden.


