
Inhalt 12 Abschnitte
- Was ist das Canonical-Tag?
- Was ist doppelter Inhalt und warum ist er ein Problem?
- Wozu dient das Canonical-Tag?
- Wie schreibt man ein Canonical-Tag?
- Wann ist Canonical im E-Commerce nötig?
- Was ist ein selbstreferenzierender Canonical?
- Was ist der Unterschied zwischen Canonical und 301-Weiterleitung?
- Was ist der Unterschied zwischen Canonical, noindex und robots.txt?
- Welche häufigen Fehler gibt es beim Canonical-Tag?
- Funktioniert Canonical richtig und wie prüfe ich das?
- Canonical und Adressverwaltung mit Faprika
- Häufig gestellte Fragen
Eine Produktliste in Ihrem Shop sieht aus wie eine einzige Seite, kann aber tatsächlich unter mehreren Adressen erreichbar sein. Eine nach Preis sortiert, eine über einen Newsletter-Link aufgerufen, eine durch einen Farbfilter eingegrenzt, eine mit abschließendem Schrägstrich … Für den Kunden sind es alles dieselbe Seite; für die Suchmaschine ist jede eine eigene Adresse. Wenn derselbe Inhalt unter so vielen Adressen liegt, entsteht Unsicherheit darüber, welche Variante hervorgehoben werden soll.
In diesem Leitfaden beantworten wir die Frage Was ist das Canonical-Tag in einfacher Sprache: das Problem doppelter und ähnlicher Inhalte, wozu das Canonical-Tag (Standardadresse) dient, wie es geschrieben wird, wie es im E-Commerce bei Filter-, Sortier-, Tracking-Parameter-, Varianten- und Kategorieadressen eingesetzt wird, der selbstreferenzierende Canonical, der Unterschied zur 301-Weiterleitung, häufige Fehler und eine Checkliste. Am Ende finden Sie die Canonical-Verwaltung mit Faprika und ein FAQ mit sechs Fragen.
Was ist das Canonical-Tag?
Das Canonical-Tag ist ein HTML-Link-Tag im head-Bereich einer Seite, das Suchmaschinen die Standardadresse (Hauptadresse) einer Seite mitteilt. Wenn derselbe Inhalt unter mehreren Adressen erreichbar ist, legt es fest, welche Adresse indexiert und im Ranking angezeigt werden soll.
„Canonical“ bedeutet „maßgeblich, standardmäßig“. Das Tag lässt sich auch als „Standardadress-Tag“ oder „Angabe der Hauptadresse“ beschreiben; in der Branche heißt es üblicherweise Canonical-Tag, Canonical-URL oder rel=canonical. In seiner einfachsten Form ist es eine einzige Zeile:
<link rel="canonical" href="https://magazaadresiniz/spor-ayakkabi">Diese Zeile besagt: „Von welcher Adresse aus Sie diese Seite auch lesen, meine Hauptadresse ist magazaadresiniz/spor-ayakkabi.“ Der Besucher sieht das nicht, und in der Adressleiste ändert sich nichts. Gelesen wird das Tag von der Suchmaschine, die die Seite crawlt.
Ein wichtiges Detail: Canonical ist kein Befehl, sondern ein starker Hinweis. Die Suchmaschine berücksichtigt das Tag weitgehend, kann aber eine eigene Entscheidung treffen, wenn sie widersprüchliche Signale auf mehreren Seiten sieht. Das Tag allein zu schreiben genügt also nicht; auch Adresse, Weiterleitungen und Sitemap müssen zum Tag passen. In den folgenden Abschnitten bauen wir diese Übereinstimmung Schritt für Schritt auf.
Was ist doppelter Inhalt und warum ist er ein Problem?
Doppelter Inhalt liegt vor, wenn derselbe oder sehr ähnlicher Inhalt unter mehreren Adressen veröffentlicht wird. Im E-Commerce ist es wichtig zu wissen, dass dies meist nicht auf böse Absicht zurückgeht, sondern eine harmlose Folge der Struktur der Website ist.
Das Problem: Die Suchmaschine muss entscheiden, welche der Adressen mit demselben Inhalt sie im Ranking anzeigt. Die Entscheidung fällt möglicherweise nicht auf die gewünschte Adresse; so kann etwa eine parametrisierte, unschöne Adresse die saubere Kategorieadresse überholen. Außerdem verteilt sich der Wert der Links auf die Seite auf mehrere Adressen, und jede Adresse bleibt für sich schwach. Da die Suchmaschine auch nur begrenzte Zeit für das Crawlen Ihrer Ressourcen einplant, erreicht sie Ihre neuen und wichtigen Seiten womöglich spät, während sie sich mit unnötigen doppelten Adressen beschäftigt.
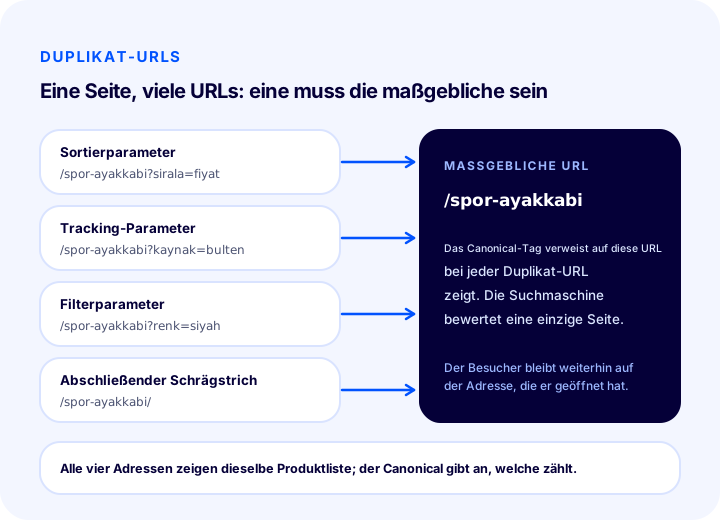
Die Grafik zeigt eine typische Kategorieseite. Sortierparameter, Tracking-Parameter, Filterparameter und abschließender Schrägstrich erzeugen vier getrennte Adressen; alle vier listen dieselben Produkte auf. Wenn das Canonical-Tag auf allen vieren die Hauptadresse angibt, bewertet die Suchmaschine eine einzige Seite, und der Wert bündelt sich auf dieser Seite.
| Problem doppelter Adressen | ماذا يحدث؟ | Ergebnis mit Canonical |
|---|---|---|
| Derselbe Inhalt unter mehreren Adressen | Die Suchmaschine entscheidet selbst, welche sie wählt | Sie geben die Wahl vor |
| Der Linkwert wird aufgeteilt | Jede Adresse bleibt schwach | Der Wert bündelt sich auf der Hauptadresse |
| Crawl-Zeit wird verschwendet | Wichtige Seiten werden spät entdeckt | Duplikate erhalten weniger Aufmerksamkeit |
| Eine unschöne Adresse erscheint in den Ergebnissen | Parametrisierte Adresse ist sichtbar | Die saubere Adresse hebt sich ab |
Wozu dient das Canonical-Tag?
Das Canonical-Tag erfüllt vier Aufgaben: Es gibt die Standardadresse an, bündelt den Wert auf einer Adresse, verringert die Unklarheit durch doppelte Inhalte und hilft, Crawl-Ressourcen auf wichtige Seiten zu lenken. Alles gehört dazu, der Suchmaschine die eigene Struktur der Website korrekt zu erklären.
- Gibt die Standardadresse an. Unter den Adressen, unter denen derselbe Inhalt liegt, bestimmen Sie, welche die Hauptadresse ist.
- Bündelt den Wert. Link- und Interessensignale, die auf verschiedene Adressen verteilt sind, treffen sich auf der Hauptadresse.
- Verringert Unklarheit. Statt zu raten, welche Variante sie für denselben Inhalt wählen soll, stützt sich die Suchmaschine auf Ihre Angabe.
- Ordnet parametrisierte Adressen. Sortier-, Filter- und Tracking-Parameter funktionieren weiter, ohne Ihre Website zu beeinträchtigen; in den Suchergebnissen erscheint nur die Hauptadresse.
Es gibt auch Dinge, die das Canonical-Tag nicht tut: Es nimmt die Seite nicht aus dem Index, leitet den Besucher nicht weiter und macht die doppelte Adresse nicht unerreichbar. Diese Unterschiede sehen Sie in späteren Abschnitten im Vergleich mit 301-Weiterleitungen und noindex im Detail.
Wie schreibt man ein Canonical-Tag?
Das Canonical-Tag wird im head-Bereich der Seite als einzelnes link-Tag geschrieben, mit rel="canonical" und dem Feld href, das den vollständigen Pfad der Hauptadresse enthält. Auf jeder Seite darf nur eines vorhanden sein.
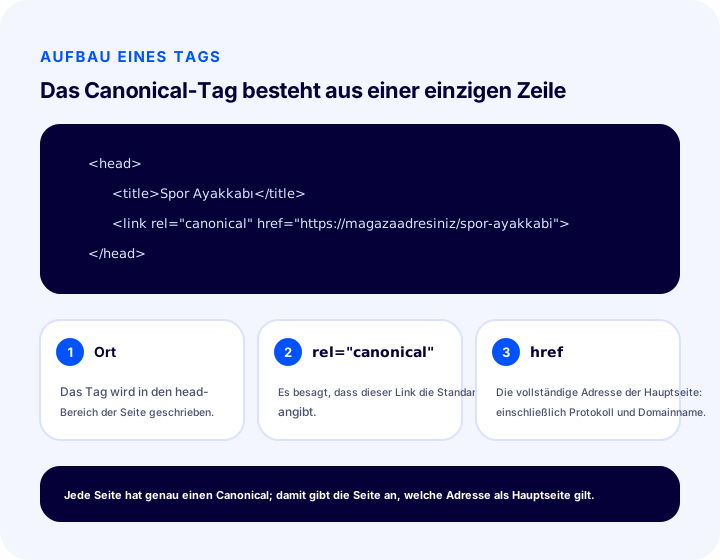
Das folgende Beispiel zeigt den Code einer parametrisierten Kategorieadresse. Auch wenn die Seite über die Adresse /spor-ayakkabi?sirala=fiyat geöffnet wird, verweist das Tag auf die Hauptadresse:
<head>
  <title>Spor Ayakkabı</title>
  <link rel="canonical" href="https://magazaadresiniz/spor-ayakkabi">
</head>| Teil | Was wird geschrieben? | Zu beachten |
|---|---|---|
| Ort | Der head-Bereich der Seite | Ein im body geschriebenes Tag wird möglicherweise ignoriert |
| rel-Feld | canonical | Die Schreibweise muss exakt sein; ein Tippfehler macht das Tag ungültig |
| href-Feld | Vollständige Adresse der Hauptseite | Verwenden Sie eine absolute Adresse einschließlich Protokoll (https) und Domainname |
| Menge | Ein Tag pro Seite | Ein zweites Tag erzeugt einen Widerspruch, beide können ignoriert werden |
1. Verwenden Sie eine absolute Adresse
Eine absolute Adresse ist die vollständige Adresse, die auch Protokoll und Domainname enthält (https://magazaadresiniz/spor-ayakkabi). Eine relative Adresse (/spor-ayakkabi) kann in manchen Fällen falsch interpretiert werden; die vollständige Adresse beseitigt jede Unklarheit.
2. Wählen Sie eine einzige Variante
Seien Sie bei der Schreibweise der Adresse konsequent: mit oder ohne www, https oder nicht, mit oder ohne abschließenden Schrägstrich? Für welche Variante Sie sich auch entscheiden, alle Canonical-Tags müssen dasselbe Format verwenden; sonst wird das Tag selbst zu einer neuen Quelle doppelter Adressen.
3. Die Hauptseite muss sich tatsächlich öffnen lassen
Die Adresse, auf die der Canonical verweist, muss problemlos geöffnet werden: Sie darf nicht weiterleiten, keinen Fehler liefern und keine Anmeldung verlangen. Ist die angegebene Adresse defekt, nützt das Tag nichts, und die Seite steht für sich allein.
4. Es muss zum Inhalt der Seite passen
Canonical verbindet Seiten mit demselben oder sehr ähnlichem Inhalt miteinander. Die Tags zweier unterschiedlicher Seiten auf dieselbe Adresse zu richten, führt die Suchmaschine in die Irre; Ihre Seite kann ignoriert oder für sich allein bewertet werden.
Bei Dateien (zum Beispiel PDF-Dokumenten) gibt es keinen Seitenbody; dieselbe Angabe kann daher auch im Header der Serverantwort erfolgen. Bei Produkt- und Kategorieseiten erzeugt die Seitenvorlage das Tag selbst, und Sie steuern es meist über Einstellungen.
Wann ist Canonical im E-Commerce nötig?
Im E-Commerce ist Canonical immer dann nötig, wenn derselbe Inhalt über mehrere Adressen erreichbar ist: Filter- und Sortierparameter, Tracking-Parameter, Variantenadressen, der Zugriff auf dasselbe Produkt aus mehreren Kategorien und Unterschiede bei Adressvarianten sind die wichtigsten Beispiele.
1. Filter- und Sortierparameter
Wenn in einer Produktliste nach Preis sortiert oder ein Filter für Farbe, Größe oder Marke gewählt wird, wird der Adresse ein Parameter hinzugefügt. Da die Sortierung meist dieselben Produkte in anderer Reihenfolge zeigt, hat sie keinen eigenen Seitenwert; diese Adressen verweisen auf die Hauptkategorieadresse. Bei Filtern hängt die Entscheidung vom Inhalt ab: Ein Filter, nach dem Menschen tatsächlich suchen und der genügend Produkte enthält, etwa „schwarze Sneaker“, kann als eigene Einstiegsseite gestaltet sein. Solche gezielt vorbereiteten Seiten verweisen auf ihre eigene Adresse; vom Nutzer beliebig gewählte Filterkombinationen verweisen auf die Hauptkategorie. Zur Nutzerseite der Filter lesen Sie den Leitfaden Optimierung von Produktfiltern und Suchleiste.
2. Tracking-Parameter
An Kampagnenlinks angehängte Tracking-Parameter (etwa Quelle, Medium, Kampagnenname) verändern den Inhalt der Seite nicht, aber die Adresse. Jede Variante aus Newsletter-, Social-Media- und Anzeigenlinks kann als neue Adresse gelten. Canonical verweist alle diese Adressen auf die saubere Adresse ohne Parameter; das Tracking funktioniert weiter, in den Suchergebnissen bleibt dagegen nur die saubere Adresse.
3. Variantenadressen
Wenn Varianten eines Produkts wie Farbe oder Größe unter eigenen Adressen aufgerufen werden, bergen diese nahezu identischen Adressen ein Duplikatrisiko. Haben die Varianten keinen eigenen Suchwert (etwa weil sie sich nur durch eine Nummer unterscheiden), wird die Adresse des Hauptprodukts als Canonical angegeben. Wird jede Variante eigenständig gesucht und unterscheidet sich der Inhalt tatsächlich, kann die Entscheidung anders ausfallen; prüfen Sie das für jedes Produkt einzeln. Der Ratgeber Was sind Produkteigenschaften hilft Ihnen beim Aufbau von Produkteigenschaften und Varianten.
4. Mehrere Kategorieadressen für dasselbe Produkt
Wird ein Produkt in mehreren Kategorien geführt, können über den Kategoriepfad verschiedene Adressen zur Produktseite entstehen (zum Beispiel, wenn der Kategoriename Teil der Adresse ist). Das Canonical-Tag aller dieser Adressen sollte auf die eine, dauerhafte Adresse des Produkts zeigen. So bündelt sich der Wert auf derselben Seite, egal aus welcher Kategorie das Produkt aufgerufen wird.
5. www, abschließender Schrägstrich und http/https
Lässt sich Ihre Website mit und ohne www sowie www, mit und ohne abschließenden Schrägstrich, mit http und mit https aufrufen, kann dieselbe Seite auf bis zu acht Adressen vervielfacht werden. Die eigentliche Lösung ist eine serverseitige 301-Weiterleitung auf eine einzige Version; das Canonical-Tag sollte darüber hinaus als zusätzliche Absicherung auf jeder Seite die gewählte Version wiederholen. Einzelheiten zur sicheren Verbindung finden Sie im Beitrag Was ist ein SSL-Zertifikat.
6. Seitennummerierung
Wird eine Kategorieliste auf mehrere Seiten aufgeteilt, zeigen die zweite und dritte Seite andere Produkte. Diese Seiten sind keine Kopien der ersten Seite; richtet man das Canonical-Tag aller Seiten auf die erste Seite, können die Produkte auf Seite zwei für Suchmaschinen unsichtbar werden. Grundsatz: Jede Seite der Nummerierung verweist auf sich selbst (selbstreferenzierendes Canonical).
7. Ergebnisseiten der Website-Suche
Ergebnisseiten, die durch Suchanfragen im Suchfeld entstehen, können unendlich viele Adressen erzeugen und haben keinen dauerhaften inhaltlichen Wert. Für diese Seiten reicht Canonical allein oft nicht aus; häufig ist es richtiger, sie nicht indexieren zu lassen (noindex). Der folgende Vergleich erleichtert diese Entscheidung.
| Situation | Empfohlenes Vorgehen | Worauf zeigt das Canonical? |
|---|---|---|
| Sortierparameter | Per Canonical mit der Originaladresse verknüpfen | Kategorieadresse ohne Parameter |
| Tracking-Parameter | Per Canonical mit der sauberen Adresse verknüpfen | Adresse ohne Parameter |
| Beliebige Filterkombination | Per Canonical mit der Hauptkategorie verknüpfen | Adresse der Hauptkategorie |
| Gezielt erstellte Filterseite | Mit eigener Adresse im Index belassen | Eigene Adresse |
| Variante, die sich nur durch eine Nummer unterscheidet | Per Canonical mit dem Hauptprodukt verknüpfen | Adresse des Hauptprodukts |
| Produktadresse aus einer anderen Kategorie | Auf die eine dauerhafte Produktadresse zeigen | Die Originaladresse des Produkts |
| Seiten der Nummerierung | Jede Seite verweist auf sich selbst | Eigene Adresse |
| www-, http- und Schrägstrich-Versionen | 301-Weiterleitung, Canonical als zusätzliche Absicherung | Die eine gewählte Version |
| Ergebnisse der Website-Suche | Meist noindex | Je nach Seite unterschiedlich |
Was ist ein selbstreferenzierendes Canonical?
Ein selbstreferenzierendes Canonical liegt vor, wenn eine Seite in ihrem Canonical-Tag die eigene Adresse angibt. Auch eine Seite ohne Duplikate teilt so ausdrücklich mit, dass sie selbst die Originaladresse ist.
Auf den ersten Blick wirkt das überflüssig: Warum sollte sich eine Seite ohne Kopien selbst angeben? Die Antwort: Die Seite kann auch unter einer Adresse aufgerufen werden, die Sie nicht kennen. Hängt jemand einen Tracking-Parameter an einen Link, ändert ein Werbetool die Adresse oder schreibt eine andere Website die Adresse leicht anders, entsteht eine neue Version der Seite. Trägt jede Seite ein Canonical, das auf sie selbst zeigt, werden all diese zufälligen Versionen automatisch mit der Originaladresse verbunden; zusätzlicher Aufwand entfällt.
| Seitentyp | Worauf sollte das Canonical zeigen? |
|---|---|
| Startseite | Die eine gewählte Adresse der Startseite |
| Kategorieseite | Kategorieadresse ohne Parameter |
| Produktseite | Die dauerhafte Adresse des Produkts |
| Blogbeitrag und Infoseite | Eigene Adresse |
| Seite der Nummerierung | Die eigene Adresse dieser Seite |
Was ist der Unterschied zwischen Canonical und 301-Weiterleitung?
Eine 301-Weiterleitung schickt Besucher und Suchmaschinen dauerhaft zur neuen Adresse; das Canonical-Tag lässt die Duplikatadresse dagegen offen und gibt nur an, welche die Originaladresse ist. Das Erste ist ein verbindlicher Umzug, das Zweite eine Empfehlung.
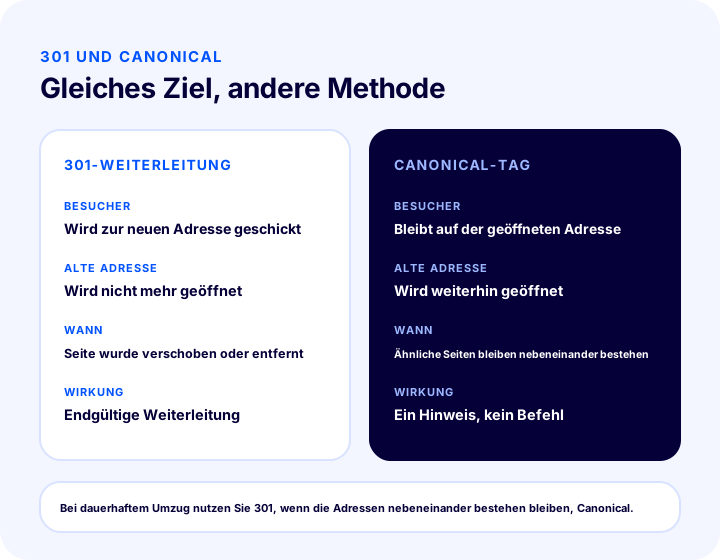
Unterscheiden Sie beides an einem Beispiel. Sie haben die Adresse einer Produktseite dauerhaft geändert: Die alte Adresse wird nicht mehr verwendet. Hier ist eine 301-Weiterleitung richtig; Besucher und Suchmaschinen, die die alte Adresse aufrufen, gelangen zur neuen. Andererseits lässt sich dieselbe Produktliste sowohl mit als auch ohne Sortierparameter aufrufen, und beide dienen dem Kunden. Hier muss die Duplikatadresse offen bleiben; das Canonical-Tag gibt die Originaladresse an.
| Funktion | 301-Weiterleitung | Canonical-Tag |
|---|---|---|
| Besucher | Wird zur neuen Adresse geschickt | Bleibt auf der geöffneten Adresse |
| Alte oder doppelte Adresse | Wird nicht mehr geöffnet | Wird weiterhin geöffnet |
| Wo wird es festgelegt? | In der Serverantwort | Im Head-Bereich der Seite |
| Wirkungsstärke | Endgültige Weiterleitung | Ein Hinweis, kein Befehl |
| Typische Anwendung | Verschobene oder entfernte Seite, Zusammenführung von Adressversionen | Seiten mit Parametern und ähnlichem Inhalt |
Faustregel: Wurde die Seite dauerhaft verschoben oder sollen Adressversionen zusammengeführt werden, nutzen Sie 301; sollen die Adressen nebeneinander bestehen, nutzen Sie Canonical. Wie eine Weiterleitung eingerichtet wird und worin sie sich von 302 und 410 unterscheidet, erklärt der Ratgeber Was ist eine 301-Weiterleitung ausführlich.
Was ist der Unterschied zwischen Canonical, noindex und robots.txt?
Canonical gibt an, welche Adresse die Originaladresse ist, noindex bittet darum, eine Seite nicht in den Suchergebnissen anzuzeigen, und robots.txt teilt Suchmaschinen mit, welche Adressen sie gar nicht erst betreten sollen. Die drei beantworten unterschiedliche Fragen und ersetzen einander nicht.
| Methode | Beantwortete Frage | Wann wird er eingesetzt? |
|---|---|---|
| Canonical | Welche Adresse ist die Originaladresse dieses Inhalts? | Gleicher oder ähnlicher Inhalt unter mehreren Adressen |
| noindex | Soll diese Seite in den Suchergebnissen erscheinen? | Seite ohne Wert oder mit notwendiger Verborgenheit |
| robots.txt | Soll diese Adresse überhaupt betreten werden? | Bereiche, die nicht gecrawlt werden sollen |
| 301-Weiterleitung | Wo befindet sich diese Adresse jetzt? | Dauerhafter Umzug und Zusammenführung von Versionen |
Das Vermischen dieser Methoden führt zu Problemen. Sperren Sie eine Seite beispielsweise per robots.txt für das Crawling, kann die Suchmaschine die Seite nicht aufrufen und das Canonical-Tag nicht lesen. Versehen Sie dieselbe Seite sowohl mit noindex als auch mit einem Canonical auf eine andere Seite, geben Sie zwei widersprüchliche Anweisungen. Wählen Sie für jede Seite eine einzige Absicht und drücken Sie sie mit einer einzigen Methode aus.
LesetippWas sind strukturierte Daten (Schema)?Welche häufigen Fehler gibt es beim Canonical-Tag?
Die meisten Canonical-Fehler entstehen nicht durch das Tag selbst, sondern weil die angegebene Adresse oder die Einstellungen drumherum falsch sind. Die häufigsten sind unten aufgeführt; alle lassen sich im Voraus vermeiden.
- Eine Canonical-Kette aufbauen. Verweist Seite A auf B und Seite B auf C, folgt die Suchmaschine dieser Kette womöglich nicht zuverlässig. Jedes Tag sollte direkt auf die Originaladresse zeigen.
- Widerspruch zu noindex. Stehen auf einer Seite gleichzeitig noindex und ein Canonical auf eine andere Adresse, ist das eine widersprüchliche Botschaft: „nicht indexieren, aber dies ist die Originalseite“.
- Auf eine weitergeleitete oder fehlerhafte Adresse zeigen. Wird die Originaladresse auf eine andere Adresse weitergeleitet oder lässt sich nicht aufrufen, läuft das Tag ins Leere.
- Adressen in der Sitemap belassen, die dem Tag widersprechen. Zeigt das Canonical einer in der Sitemap aufgeführten Adresse auf eine andere Adresse, weiß die Suchmaschine nicht, welchem Signal sie vertrauen soll. Die Sitemap sollte nur Originaladressen enthalten.
- Alle Seiten auf die Startseite verweisen. Zeigt das Canonical jeder Seite wegen eines Vorlagenfehlers auf die Startseite, verlieren Tausende Produkte und Kategorien im Index an Wert. Das ist einer der schwerwiegendsten Fehler.
- Die Seitennummerierung auf die erste Seite verweisen. Das erschwert die Entdeckung der Produkte auf der zweiten und den folgenden Seiten.
- Eine relative oder falsch geschriebene Adresse verwenden. Ein fehlendes Protokoll, die falsche Domainversion oder ein Tippfehler machen das Tag wirkungslos.
- Mehr als ein Tag auf einer Seite setzen. Erzeugen die Vorlage und ein Plugin gleichzeitig ein Tag, entstehen zwei Zeilen, und beide können ignoriert werden.
- Unterschiedliche Inhalte per Canonical zusammenführen wollen. Seiten, die sich voneinander unterscheiden, auf dieselbe Adresse zu verweisen, führt die Suchmaschine in die Irre; das Tag wird ignoriert.
- Adressen mit Parametern in internen Links verwenden. Verlinken Menüs und Karten Ihrer Website auf Adressen mit Parametern, verteilen sich die Signale, egal wie korrekt das Canonical ist. Auch interne Links sollten auf die Originaladresse zeigen.
Wie prüfe ich, ob das Canonical-Tag richtig funktioniert?
Um das Canonical-Tag zu prüfen, genügt es, das Tag im Quelltext der Seite zu finden und die angegebene Adresse zu öffnen, sicherzustellen, dass es nur ein Tag pro Seite gibt, und zu prüfen, dass es mit Sitemap und internen Links übereinstimmt. Bei großen Websites erfolgt die Prüfung pro Vorlagentyp: Je ein Beispiel aus Produkt-, Kategorie-, Blog- und Suchseiten genügt.
- Öffnen Sie eine Produktseite. Suchen Sie im Quelltext die Canonical-Zeile; prüfen Sie, ob sie auf die eigene Adresse zeigt.
- Testen Sie eine Adresse mit Parametern. Rufen Sie dieselbe Seite mit einem Sortier- oder Tracking-Parameter auf; das Tag sollte auf die Adresse ohne Parameter zeigen.
- Öffnen Sie die angegebene Adresse. Sie sollte problemlos aufrufbar sein, ohne Weiterleitung und ohne Fehler.
- Zählen Sie die Tags. Auf der Seite sollte genau eine Zeile stehen.
- Testen Sie die Adressversionen. Mit und ohne www, http und https, mit und ohne abschließenden Schrägstrich sollten alle zu einer Version führen oder dasselbe Canonical anzeigen.
- Vergleichen Sie mit der Sitemap. Das Canonical jeder Adresse in der Sitemap sollte sie selbst sein.
- Prüfen Sie die Berichte im Verwaltungstool der Suchmaschine. Warnungen zu doppelten Inhalten und zur gewählten Originaladresse zeigen die Seiten, bei denen Ihre Wahl und die der Suchmaschine auseinandergehen.
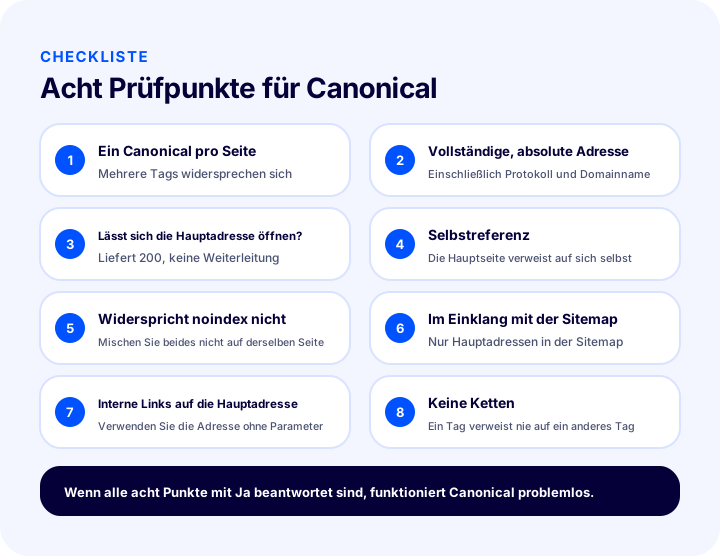
Die acht Punkte der Abbildung stehen unten auch als Liste, damit Sie sie bei einer detaillierten Prüfung zur Hand haben:
| # | Prüfpunkt | Was passiert, wenn es falsch ist? |
|---|---|---|
| 1 | Jede Seite hat genau ein Canonical | Widersprüchliche Tags können ignoriert werden |
| 2 | Die Adresse ist vollständig und absolut (mit Protokoll und Domain) | Das Tag wird falsch interpretiert |
| 3 | Die Originaladresse liefert 200 und leitet nicht weiter | Das Tag läuft ins Leere |
| 4 | Die Hauptseite verweist auf sich selbst | Keine Absicherung gegen Adressvarianten |
| 5 | Widerspricht noindex nicht | Die Suchmaschine erhält zwei gegensätzliche Anweisungen |
| 6 | Die Sitemap enthält nur Originaladressen | Signale beeinträchtigen einander |
| 7 | Interne Links führen zur Originaladresse | Adressen mit Parametern gewinnen an Stärke |
| 8 | Keine Ketten: Ein Tag zeigt nicht auf ein anderes Tag | Die Kette wird womöglich nicht verfolgt |
Nach den Korrekturen kann es dauern, bis sich das Ergebnis zeigt: Bis die Suchmaschine die Seiten erneut crawlt und die Signale neu bewertet, kann der vorherige Zustand in den Ergebnissen bestehen bleiben. Nach der Änderung abzuwarten und die Berichte einige Wochen lang zu beobachten, gehört zum normalen Ablauf.
LesetippWas ist ein SSL-Zertifikat?Canonical und Adressverwaltung mit Faprika
In der Faprika-E-Commerce-Plattform gehört die Canonical-Einstellung zu den SEO-Einstellungen des Shops. Laut der Anleitung zu den SEO-Einstellungen im Hilfecenter finden Sie im Kontrollpanel unter Konfiguration, Einstellungen, Allgemeine Einstellungen im Abschnitt SEO die Option „Canonical Url Aktiv“; diese Einstellung dient dazu, einzigartige Seitenadressen festzulegen, und hilft, den Wert zu erhalten, indem sie die Vervielfältigung von Inhalten unter verschiedenen Adressen verhindert. Im selben Bereich wird mit „Domainprüfung“ auch der einheitliche Zugriff auf die Adressversionen mit und ohne www behandelt.
Im Paketvergleich finden sich Zeilen wie „Canonical / H-Tag-Verwaltung / Robots / Sitemap“ und „301 / 302 / 410-Panel / URL-Einträge verwalten“; welches Paket welche Verwaltungstools enthält, hängt vom Paket ab. Den aktuellen Umfang finden Sie auf der Seite E-Commerce-Pakete. Um Titel, Beschreibung und Canonical im gesamten Shop gemeinsam einzurichten, hilft der Ratgeber Wie richte ich die E-Commerce-SEO-Einstellungen ein; für die Weiterleitung alter Adressen bei Adressumzügen ist der Ratgeber Was ist eine 301-Weiterleitung nützlich. Wie Sie Kategorieseiten stärken, lesen Sie im Beitrag SEO für Kategorieseiten.
Häufig gestellte Fragen
Was ist das Canonical-Tag?
Das Canonical-Tag ist ein HTML-Link-Tag im head-Bereich einer Seite, das Suchmaschinen mitteilt, welche Adresse die Hauptseite (Standardseite) ist, wenn derselbe oder sehr ähnlicher Inhalt unter mehreren Adressen erreichbar ist. Es leitet den Besucher nicht weiter, sondern informiert nur die Suchmaschine.
Wozu dient das Canonical-Tag?
Es verringert die Unklarheit bei doppelten Inhalten, bündelt den auf verschiedene Adressen verteilten Linkwert auf der Originaladresse und hilft, dass in den Suchergebnissen die saubere statt einer parametrisierten oder unschönen Adresse erscheint. Im E-Commerce ist es besonders bei Adressen mit Filter-, Sortier- und Tracking-Parametern wichtig.
Sind Canonical-Tag und 301-Weiterleitung dasselbe?
Nein. Eine 301-Weiterleitung schickt Besucher und Suchmaschine dauerhaft zur neuen Adresse, die alte Adresse wird nicht mehr geöffnet. Das Canonical-Tag lässt die doppelte Adresse geöffnet und gibt nur die Hauptadresse an; es ist keine endgültige Weiterleitung, sondern ein starker Hinweis. Wurde die Seite dauerhaft verschoben, nutzen Sie 301; bestehen die Adressen nebeneinander, nutzen Sie Canonical.
Sollte ich jede Seite mit einem Canonical-Tag versehen?
Ja, grundsätzlich sollte jede indexierbare Seite ein Canonical-Tag tragen, das auf die eigene Adresse zeigt (selbstreferenzierender Canonical). Auch wenn die Seite keine Duplikate hat, dient es als Absicherung gegen Adressvarianten, die Sie nicht kennen. Jede Seite darf nur ein Tag enthalten.
Sollte der Canonical von Paginierungsseiten die erste Seite sein?
In der Regel nein. Die zweite und die folgenden Seiten zeigen andere Produkte als die erste Seite; sie alle auf die erste Seite zu verweisen, kann die Auffindbarkeit dieser Produkte erschweren. Sicherer ist es, wenn jede Paginierungsseite auf ihre eigene Adresse verweist.
Was können die Gründe sein, wenn das Canonical-Tag nicht funktioniert?
Die häufigsten Gründe: Die Adresse, auf die das Tag verweist, leitet weiter oder liefert einen Fehler, es widerspricht noindex auf derselben Seite, eine Seite enthält mehrere Tags, Sitemap und interne Links zeigen auf eine andere Adresse, es entsteht eine Kette, oder unterschiedliche Seiten verweisen auf dieselbe Adresse. Alle Signale sollten auf dieselbe Hauptadresse zeigen.


