Contenido 10 secciones
- ¿Qué es el presupuesto de rastreo (crawl budget)?
- ¿Cómo rastrean los bots de los buscadores un sitio?
- ¿Para quién es importante el presupuesto de rastreo?
- ¿Qué consume el presupuesto de rastreo en el comercio electrónico?
- ¿Cómo detectar un problema de presupuesto de rastreo?
- ¿Cómo se optimiza el presupuesto de rastreo?
- ¿Qué errores son frecuentes en la optimización del presupuesto de rastreo?
- Lista de verificación del presupuesto de rastreo
- Gestión del rastreo con Faprika
- Preguntas frecuentes
Imagine que ayer añadió una colección nueva a su tienda y publicó cientos de productos. Pasan los días y la mayoría de esos productos sigue sin aparecer en los resultados de búsqueda. En muchos casos, la culpa no es de la calidad del contenido ni de la competencia: el bot del buscador está gastando su tiempo entre combinaciones de filtros, opciones de ordenación y URL antiguas, sin llegar a sus productos. De eso trata esta guía: qué es el presupuesto de rastreo, cuándo se convierte en un problema real y cómo se gestiona en un sitio de comercio electrónico.
En la guía explicamos primero cómo recorren los bots un sitio, los dos componentes del presupuesto de rastreo y para quién es importante. Después encontrará las seis fuentes que consumen el presupuesto en el comercio electrónico, los métodos de detección con registros del servidor e informes de rastreo, las herramientas de solución (robots.txt, canonical, redirecciones, mapa del sitio, enlaces internos, velocidad), los errores más frecuentes y una lista de verificación. También incluimos una respuesta equilibrada a la pregunta «¿me afecta este tema en mi sitio pequeño?».
¿Qué es el presupuesto de rastreo (crawl budget)?
El presupuesto de rastreo es la cantidad de páginas que el bot de un buscador puede y quiere recorrer en un sitio durante un tiempo determinado. Consta de dos componentes: el ritmo de rastreo que su servidor puede soportar (límite de velocidad de rastreo) y cuánto quiere el bot rastrear su sitio (demanda de rastreo).
Para que los buscadores puedan ver las páginas, primero tienen que encontrarlas y luego descargarlas y analizarlas. El software que hace este trabajo se llama bot de rastreo o araña. El bot parte de URL conocidas, descubre nuevas URL siguiendo los enlaces de la página y ordena en una cola lo que encuentra. Como no es posible recorrer todos los sitios del mundo a velocidad ilimitada, cada sitio tiene una especie de «tiempo asignado». Ese tiempo asignado se llama presupuesto de rastreo.
El presupuesto no se presenta como una cifra fija y no puede conocerse con exactitud desde fuera; varía de un sitio a otro y con el tiempo. Por eso en este artículo no damos números ni umbrales. Lo importante es entender cómo funciona el presupuesto y qué lo consume.
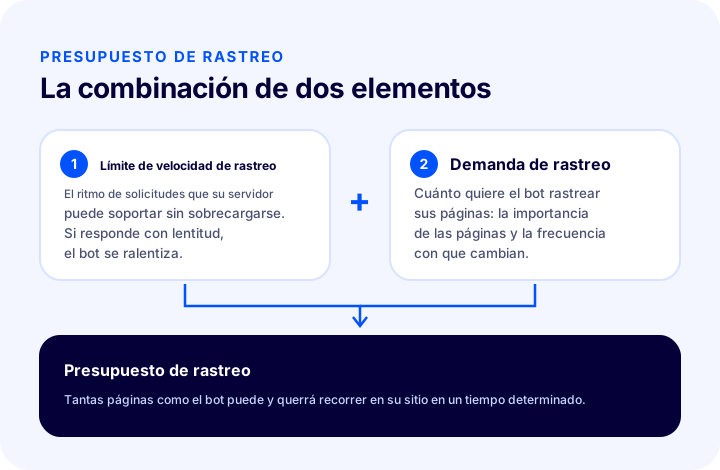
Límite de velocidad de rastreo
El límite de velocidad de rastreo es el ritmo de solicitudes que el bot puede realizar sin sobrecargar su servidor. Si el servidor responde con rapidez y estabilidad, el bot puede recorrer el sitio con más holgura; si detecta lentitud, tiempos de espera agotados o errores del servidor, reduce su ritmo. Es decir, la velocidad de su sitio no solo afecta a la experiencia del visitante, sino también a cuántas páginas puede ver el bot. Para el lado del visitante, consulte los artículos por qué es importante la velocidad del sitio en el comercio electrónico y qué es Core Web Vitals.
Demanda de rastreo
La demanda de rastreo es cuánto quiere el bot rastrear su sitio. Factores como la importancia aparente de las páginas, la frecuencia con la que cambian y cuánto se «desactualizan» las URL conocidas determinan esta demanda. Las páginas que se actualizan a menudo y reciben muchos enlaces pueden visitarse con más frecuencia; las que llevan años sin cambiar y a las que nadie enlaza pueden quedar relegadas. Si el número de URL de su sitio se dispara, la demanda se reparte entre las páginas importantes.
Le recomendamos leer¿Qué es robots.txt? Uso correcto en un sitio de comercio electrónico¿Cómo rastrean los bots de los buscadores un sitio?
El bot primero encuentra una URL, luego solicita la página, analiza su contenido y añade a la cola los enlaces de la página como nuevas URL. Este ciclo se alimenta de muchas fuentes, como el mapa del sitio, los enlaces internos y los enlaces externos.
- Descubrimiento. El bot conoce las URL a través del mapa del sitio, los enlaces internos de las páginas y los enlaces procedentes de otros sitios.
- Comprobación de permisos. Antes de ir a la página, consulta las reglas del archivo robots.txt; no entra en las URL prohibidas.
- Solicitud. Pide la página al servidor. El servidor responde con un código de estado como 200, 301, 404 o 5xx.
- Análisis. Procesa el contenido de la página, su título, su etiqueta canonical, sus datos estructurados y sus enlaces.
- Ordenación. Coloca las nuevas URL que encuentra en una cola de rastreo; decide a cuál volver y cuándo según sus propias prioridades.
Hay un punto al que conviene prestar atención: rastreo e indexación no son lo mismo. El bot puede rastrear una página y no gustarle, o considerarla copia de otra URL y no indexarla. El rastreo es requisito previo de la indexación, pero no toda página rastreada aparece en el índice. Conviene recordar los temas que tratamos aparte sobre los problemas de indexación: los artículos qué es el contenido duplicado y qué es la etiqueta canonical completan la relación entre estos dos conceptos.
¿Para quién es importante el presupuesto de rastreo?
El presupuesto de rastreo es más importante para los sitios grandes que generan muchas URL y para los sitios cuyo contenido cambia constantemente. En un sitio pequeño y ordenado, por lo general no es un problema en sí mismo.
Conviene evitar la exageración en este asunto. En una tienda con unos cientos de páginas y una estructura de URL limpia, que el bot recorra todas las páginas no suele ser un problema; en un sitio así, en lugar de «optimizar el presupuesto de rastreo» es más rentable dedicar tiempo a la calidad del contenido, las páginas de producto y los enlaces internos. En cambio, hay que tomarse el tema en serio en estos casos:
- Tiendas con muchos productos y categorías,
- Sitios que dejan abiertas como URL las páginas de filtros, ordenación y resultados de búsqueda,
- Tiendas cuyo stock y precios cambian con frecuencia o que añaden y eliminan constantemente muchos productos,
- Sitios que atraviesan una migración, un cambio de URL o una reestructuración,
- Sitios en los que las páginas recién publicadas tardan mucho en indexarse.
| Situación | ¿Es un problema el presupuesto de rastreo? | ¿Qué hacer primero? |
|---|---|---|
| Pocas páginas, URL limpias | Por lo general, no | Céntrese en el contenido y los enlaces internos |
| Muchos productos, los filtros generan URL | Puede | Gestione las URL de filtros y ordenación |
| Muchas URL duplicadas | Puede | Ordene canonical y redirecciones |
| Las páginas nuevas tardan en indexarse | Puede serlo; también puede haber otras causas | Revise primero la calidad de las páginas y los enlaces |
| Tras una migración o un cambio de URL | Puede intensificarse de forma temporal | Mantenga limpias las redirecciones y el mapa del sitio |
¿Qué consume el presupuesto de rastreo en el comercio electrónico?
En el comercio electrónico, las fuentes que más presupuesto consumen son las URL de filtros y ordenación, las páginas duplicadas, las cadenas de redirecciones, las páginas de error, la paginación infinita y las respuestas lentas del servidor. Lo que tienen en común es que hacen que el bot pierda tiempo en URL de poco valor.
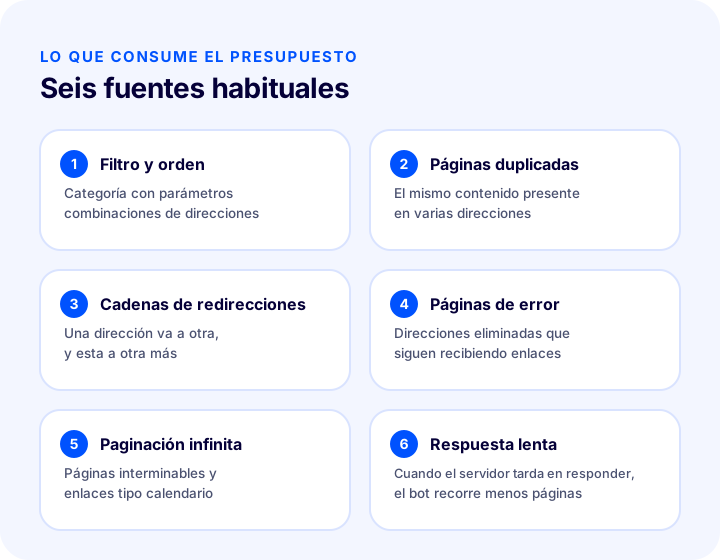
| Fuente | ¿Por qué consume presupuesto? | Dirección general de la solución |
|---|---|---|
| Direcciones de filtro y orden | Cada combinación es una URL nueva; los mismos productos se rastrean una y otra vez en distinto orden | robots.txt, canonical, revisión de enlaces internos |
| Páginas duplicadas | Que el mismo contenido esté en varias URL obliga al bot a leer lo mismo otra vez | Canonical, 301, consolidación |
| Cadenas de redirecciones | Cada eslabón es una solicitud aparte; el bot gasta varias solicitudes hasta llegar al destino | Una sola redirección directa al destino |
| Páginas de error | El bot vuelve a intentar una y otra vez las URL 404 que aún reciben enlaces | Corrija los enlaces y use 301 donde corresponda |
| Paginación infinita | Las páginas sin fin o los enlaces de tipo calendario meten al bot en un camino infinito | Limite la paginación y establezca una cadena de enlaces clara |
| Respuesta lenta | Cuando el servidor tarda en responder, el bot reduce su ritmo | Mejora de la velocidad y del servidor |
1. URL de filtros y ordenación
En una página de categoría, las opciones de color, talla, rango de precio y ordenación suelen añadirse a la URL como parámetros. Cada combinación se convierte en una URL distinta, y el número de combinaciones se multiplica rápidamente a medida que aumentan las opciones. Por ejemplo, incluso una categoría con solo unos pocos filtros y unas pocas opciones de ordenación puede generar muchas URL si se usan todos a la vez. Mientras el bot visita estas URL una por una, se reduce el tiempo disponible para llegar a las páginas de producto reales.
Aquí el objetivo no es impedir que el visitante use los filtros, sino evitar que el bot salga a explorar cada combinación. Las páginas de filtro con demanda de búsqueda real (por ejemplo, un color y un tipo de producto que la gente busca por su nombre) pueden tratarse como una página independiente; el resto puede marcarse con un canonical que apunte a la categoría principal o cerrarse al rastreo con robots.txt. Para la experiencia de filtrado y búsqueda también le ayudará la guía de optimización del filtrado de productos y de la barra de búsqueda en el comercio electrónico.
2. Páginas duplicadas
La versión con www y sin www de una misma página, la forma con y sin barra final, los enlaces con parámetros de seguimiento o las URL distintas para las variantes de producto son, para el bot, páginas independientes. El bot las visita todas, comprueba que el contenido es el mismo y aun así vuelve en la siguiente visita. Cuantas más URL duplicadas hay, más presupuesto se desperdicia. Explicamos con detalle las causas y las opciones de solución en el artículo qué es el contenido duplicado.
3. Cadenas de redirecciones
Si una URL redirige a otra y esta a una tercera, se forma una cadena. Los traslados y ajustes de URL hechos varias veces en el sitio acumulan con el tiempo este tipo de cadenas: de la URL antigua A a B, de B a C. El bot hace una solicitud distinta por cada eslabón hasta llegar al destino; además, en cadenas largas puede abandonar en algún punto. La solución es redirigir cada URL antigua directamente al destino final en un solo paso. Para entender la lógica de las redirecciones, el artículo qué es una redirección 301 es un buen punto de partida.
Le recomendamos leer¿Qué es una redirección 301? Guía de uso correcto en el comercio electrónico4. Páginas de error (404) y soft 404
Si las URL de productos eliminados siguen en los enlaces internos, en el mapa del sitio o en enlaces de otros sitios, el bot sigue acudiendo a ellas y recibe un 404 cada vez. Un número reducido de 404 es normal; el problema es que su propio sitio siga enlazando a URL con 404. Existe además el llamado «soft 404»: la página devuelve el código de estado 200, pero el contenido dice «producto no encontrado». El bot puede tomar estas páginas por páginas reales y seguir rastreándolas. Para configurar bien la página de error, consulte la guía qué es una página 404.
5. Paginación infinita y espacios de enlaces infinitos
La paginación es una parte natural de las listas de productos; pero si el número de página puede aumentar sin límite o si incluso las páginas vacías se abren como URL, el bot avanza por un camino sin final. El mismo problema se ve en los enlaces de tipo calendario por los que se puede avanzar y retroceder indefinidamente y en las páginas de resultados de búsqueda que generan una URL nueva con cada clic. Los detalles para configurar bien la paginación se explican en el artículo SEO de la paginación.
6. Respuesta lenta del servidor
Cuando el servidor responde con lentitud, el bot reduce su ritmo para no perjudicarlo, y en el mismo tiempo recorre menos páginas. En épocas de campañas intensas, un servidor sobrecargado o plantillas de página innecesariamente pesadas ralentizan tanto al visitante como al bot.
¿Cómo detectar un problema de presupuesto de rastreo?
Para detectar un problema de presupuesto de rastreo, hay que observar a qué direcciones accede realmente el bot en su sitio. Hay dos fuentes principales: los registros del servidor y las estadísticas de rastreo que ofrece el motor de búsqueda.
Registros del servidor (archivos de log)
Los registros del servidor son archivos en los que se guarda, línea por línea, cada solicitud que llega al sitio. Cada línea suele incluir la hora, el nombre del cliente (incluido el nombre del bot), la dirección solicitada y el código de estado que devolvió el servidor. Es el dato que mejor muestra cómo reparte el bot las direcciones, porque no se basa en suposiciones sino en solicitudes reales.
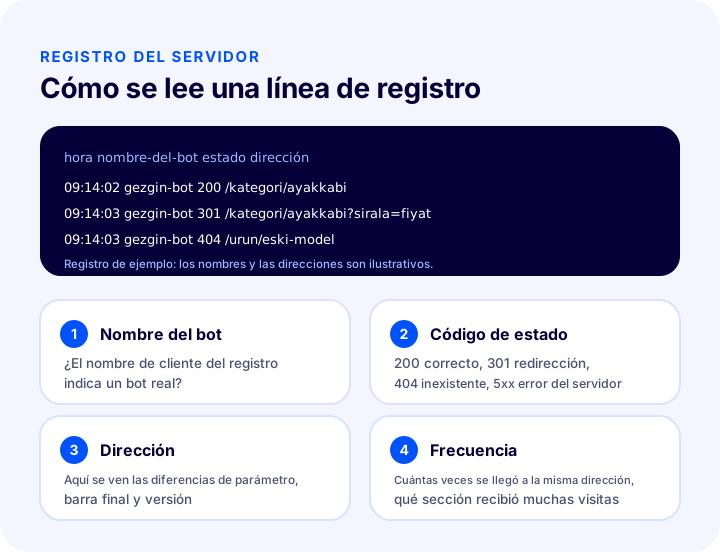
Al revisar los registros, busque respuesta a estas preguntas:
- ¿Qué secciones (categoría, producto, filtro, búsqueda, blog) visita más el bot?
- ¿Qué peso tienen las direcciones con parámetros (orden, filtro, seguimiento) en comparación con sus páginas principales?
- ¿Se devuelven muchas respuestas 301, 404 o 5xx? ¿En qué direcciones?
- ¿Se visitan sus páginas nuevas importantes muy tarde o nunca?
- ¿El nombre del bot corresponde a un bot real de un motor de búsqueda o a un cliente que se hace pasar por él?
El acceso a los archivos de registro varía según el tipo de alojamiento; en una infraestructura de tienda ya preparada, es posible que usted no tenga acceso directo a ellos. En ese caso, hay que solicitarlos al proveedor de la infraestructura o a su equipo técnico.
Estadísticas de rastreo del motor de búsqueda
Las herramientas que los motores de búsqueda ofrecen a los propietarios de sitios suelen incluir una sección llamada «estadísticas de rastreo» o similar. En ella verá información resumida sobre cómo cambian con el tiempo las solicitudes del bot a su sitio, qué códigos de estado se devuelven, qué tipos de archivo se rastrean y qué tan rápido responde su servidor. No es tan detallada como los registros del servidor, pero es un punto de partida sencillo para ver la tendencia. Una caída repentina en el número de solicitudes, un deterioro en la velocidad de respuesta o un aumento en la tasa de errores pueden ser señales de un problema de presupuesto.
Comprobaciones rápidas manuales
- Cuente las direcciones con parámetros. Seleccione un filtro y un orden en su página de categoría y observe la barra de direcciones; si las selecciones se añaden a la dirección, cada combinación es una dirección distinta.
- Revise el mapa del sitio. Si en él hay direcciones que redirigen, devuelven 404 o están duplicadas, está llamando al bot a un lugar equivocado. Para más detalles, consulte la guía qué es un mapa del sitio.
- Revise los enlaces internos. ¿Los enlaces del menú, del pie de página y de las páginas de producto llevan a direcciones que redirigen o están duplicadas?
- Pruebe las cadenas de redirección. Abra una dirección antigua y compruebe en cuántos pasos se llega al destino.
- Repita la medición de velocidad. Anote las páginas en las que la respuesta del servidor es lenta.
¿Cómo optimizar el presupuesto de rastreo?
La forma de optimizar el presupuesto de rastreo es dirigir el tiempo del bot hacia las páginas valiosas y reducir las direcciones sin valor. Para ello se usan en conjunto robots.txt, canonical, redirecciones, mapa del sitio, enlaces internos y velocidad del servidor.
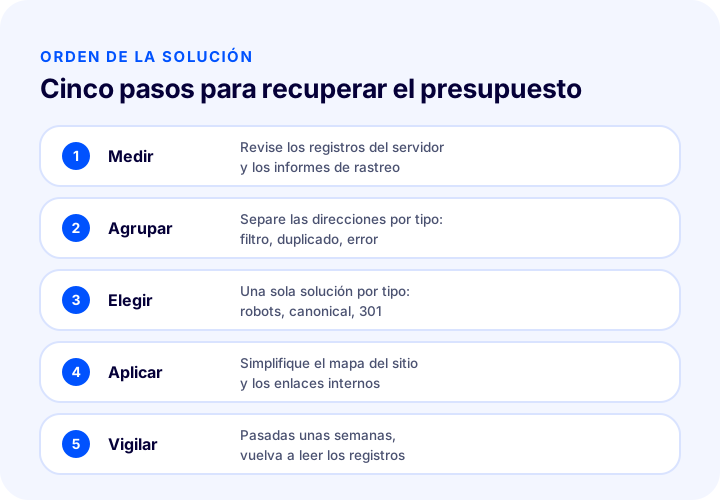
| Herramienta | ¿Qué hace? | ¿Cuándo se elige? |
|---|---|---|
| robots.txt | Impide que el bot entre en determinados patrones de direcciones | Direcciones de filtro y búsqueda que no necesitan rastrearse nunca |
| Etiqueta canonical | Indica que la dirección duplicada apunta a la dirección principal | Direcciones que deben seguir abiertas al visitante, pero cuya página principal debe aparecer en los resultados de búsqueda |
| Redirección 301 | Traslada de forma permanente la dirección antigua a la nueva | Direcciones eliminadas o fusionadas de forma permanente y versiones de direcciones |
| Sitemap | Informa a los bots de las direcciones importantes | Solo las direcciones principales que desea que se indexen |
| Enlace interno | Lleva al bot y al visitante a las páginas importantes | Descubrimiento de páginas nuevas y valiosas |
| Mejora de la velocidad | Reduce la respuesta del servidor y el peso de la página | Casos en que el bot reduce su ritmo porque el servidor se ralentiza |
Cerrar direcciones innecesarias con robots.txt
robots.txt es un archivo que indica a los bots a qué patrones de direcciones no deben entrar. Resulta útil para las direcciones de filtro, orden y búsqueda interna que nunca deberían rastrearse. Una regla de ejemplo se ve así (las direcciones son ilustrativas y deben adaptarse a la estructura de sus propias direcciones):
User-agent: *
Disallow: /*?sirala=
Disallow: /*?filtre=
Disallow: /arama
Aquí hay una advertencia importante: el bot no rastrea una dirección bloqueada con robots.txt, pero eso no significa que esa dirección no vaya a aparecer nunca en el índice, ya que, si recibe enlaces desde otros sitios, la dirección puede seguir siendo conocida. Además, el hecho de que el bot no pueda leer la página bloqueada le impide ver también la etiqueta canonical o noindex de esa página. Por eso, poner a la misma dirección un bloqueo en robots.txt y una marca canonical suele carecer de sentido. Qué herramienta elegir en cada caso se explica en detalle en el artículo qué es robots.txt.
Indicar la dirección principal con canonical
Si una página de filtro u orden debe seguir abierta al visitante, la página señala la dirección principal de la categoría mediante la etiqueta canonical:
<link rel="canonical" href="https://magazaadresiniz/kategori/ayakkabi">Canonical no detiene directamente el rastreo del bot; es solo una pista sólida que indica cuál es la dirección principal. El bot sigue visitando la página. Por tanto, canonical es muy útil para la indexación y la consolidación de señales, pero por sí sola no resuelve el presupuesto de rastreo; si el problema de presupuesto es grande, debe considerarse junto con robots.txt y la simplificación de los enlaces internos. Para más detalles, consulte el artículo qué es la etiqueta canonical.
Simplificar las redirecciones
Encuentre las cadenas y redirija cada dirección antigua directamente al destino final. No deje en los enlaces internos del sitio direcciones que redirigen; actualice el enlace directamente a la dirección de destino. Así, tanto el bot como el visitante ahorran un paso. Para notas útiles sobre la organización de las direcciones y la reestructuración, puede consultar el artículo cómo debe ser la estructura de URL.
Mantener limpio el mapa del sitio
El mapa del sitio es la lista con la que les dice a los bots «estas son las direcciones importantes». Si en él hay páginas que redirigen, devuelven 404, tienen etiqueta noindex o cuyo canonical apunta a otra dirección, se llama al bot a un lugar equivocado. Un buen mapa del sitio contiene únicamente las direcciones principales que desea indexar y que devuelven respuesta 200. Cuando se añaden páginas nuevas, deben entrar en el mapa, y las páginas eliminadas deben salir de él. Los detalles de este tema están en la guía qué es un mapa del sitio.
Le recomendamos leer¿Qué es un mapa del sitio (sitemap)? Configuración correcta para un sitio de comercio electrónicoLlevar al bot a las páginas correctas con enlaces internos
El bot recorre su sitio siguiendo enlaces. Si da muchos enlaces internos a una página, esa página parece más importante y aumenta la probabilidad de que el bot vuelva a ella; una página que no recibe enlaces desde ningún sitio, en cambio, tiene dificultades para ser encontrada. Empezando por la página de inicio y el menú, asegure que se llegue por el camino más corto a las páginas importantes de categoría y de producto. Reduzca los enlaces internos que llevan a direcciones duplicadas o sin valor: por ejemplo, no es necesario que todos los enlaces de filtro sean enlaces simples que el bot pueda seguir. Para conocer los detalles de cómo crear enlaces internos, le serán útiles los artículos qué es un enlace interno y SEO de la página de categoría.
Controlar la paginación y las páginas vacías
Cada página de paginación debe mostrar su propia dirección y debe haber una cadena de enlaces clara entre las páginas. Si existen direcciones de páginas vacías que se abren aunque se hayan agotado los productos, asegúrese de que devuelvan 404 o de que ni siquiera se generen. Dividir los productos de las categorías con una estructura razonable alivia tanto al visitante como al bot.
Mejorar la velocidad y la estabilidad del servidor
Cuando el bot recibe respuestas lentas, reduce su ritmo; un servidor rápido y estable permite recorrer más páginas en el mismo tiempo. Mantener las imágenes ligeras, reducir los scripts innecesarios y aprovechar la caché es útil tanto para la experiencia del visitante como para el rastreo. Para mejorar la velocidad, puede consultar la guía velocidad del sitio en el comercio electrónico.
¿Cuáles son los errores más comunes en la optimización del presupuesto de rastreo?
El error más frecuente es intentar resolver todas las direcciones duplicadas con el mismo método e intervenir innecesariamente en un sitio que no tiene un problema de presupuesto. Los siguientes errores son ejemplos que se ven mucho en la práctica.
- Cerrar por error páginas importantes con robots.txt. Una regla puede aplicarse con más amplitud de la esperada y bloquear también páginas de producto o de categoría. Pruebe las direcciones importantes después de cada cambio.
- Creer que canonical resolverá por sí solo el presupuesto. Canonical no detiene el rastreo; solo señala la dirección principal.
- Poner noindex en las páginas y mantener los enlaces. Las páginas con noindex se siguen rastreando; que el bot llegue a ellas gasta presupuesto.
- Dejar cadenas de redirección. Añadir un nuevo eslabón en cada traslado, en lugar de enlazar la dirección antigua con el destino final, alarga la cadena.
- Poner todo en el mapa del sitio. Si las direcciones duplicadas, que redirigen o con noindex permanecen en el mapa, este pierde credibilidad.
- Intervenir en exceso en un sitio sin problema. Escribir reglas complejas de robots.txt en un sitio pequeño aumenta el riesgo de bloquear por error páginas que sí son útiles.
- Decidir sin medir. Decir «el presupuesto no alcanza» sin mirar los registros puede ocultar la causa real (calidad del contenido, falta de enlaces).
- No hacer seguimiento tras aplicar la solución. Para ver cómo se refleja el cambio en el comportamiento del bot, vuelva a la misma medición unas semanas después.
Lista de verificación del presupuesto de rastreo
La lista siguiente es la versión en texto de los puntos del gráfico; puede revisar su tienda en este orden.
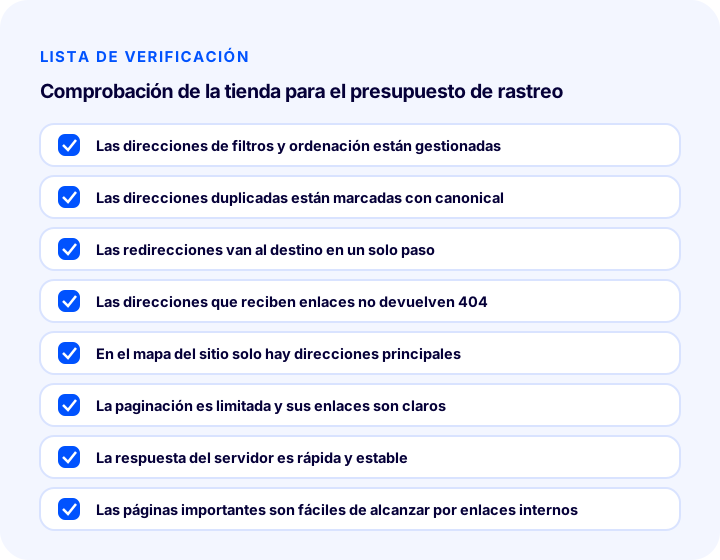
- Las direcciones de filtro y orden están gestionadas: las innecesarias están cerradas al rastreo o apuntan a la dirección principal.
- Las direcciones duplicadas están marcadas con canonical; las versiones de la dirección (www, http, barra final) se redirigen a una sola versión.
- Las redirecciones van directamente al destino en un solo paso; los enlaces internos no usan direcciones que redirigen.
- Las direcciones que reciben enlaces no devuelven 404; las páginas eliminadas se redirigen al lugar adecuado.
- En el mapa del sitio solo hay direcciones principales que devuelven respuesta 200.
- La paginación es limitada y sus enlaces son claros; las páginas vacías no se abren como direcciones.
- La respuesta del servidor es rápida y estable; no se resiente en épocas de mucha actividad.
- Se llega por el camino más corto a las páginas importantes de categoría y de producto desde el menú y los enlaces internos.
- Los registros del servidor o las estadísticas de rastreo se revisan a intervalos regulares.
Gestión del rastreo con Faprika
En Faprika, varias herramientas de gestión que influyen en el presupuesto de rastreo se encuentran dentro de los ajustes de SEO. Según la formación sobre ajustes de SEO del Centro de ayuda, en la sección SEO de Configuración, Ajustes, Ajustes generales hay una opción de dirección canonical; este ajuste ayuda a indicar las direcciones de cada página. La misma formación trata el control del nombre de dominio y el acceso coherente a las versiones de la dirección con y sin www; reunir las versiones de la dirección en una sola reduce las veces que el bot visita la misma página en varias direcciones.
En la comparación de características de los planes, la fila «Canonical / Gestión de etiquetas H / Robots / Sitemap» incluye la gestión de canonical, etiquetas de encabezado, robots y mapa del sitio; la fila «Panel 301 / 302 / 410 / Gestión de registros de URL» incluye la gestión de redirecciones y registros de direcciones. Las filas «Actualización masiva automática de información SEO/Meta» e «Informes SEO» también figuran entre las herramientas que facilitan estas tareas. Qué herramientas incluye cada plan puede variar según el plan; para conocer el alcance actual, puede consultar la página de planes de comercio electrónico.
La edición de la información SEO de productos y categorías producto por producto se explica en la formación sobre gestión del catálogo. Mantener ordenados los ajustes de catálogo y multimedia reduce que el bot se encuentre con direcciones innecesarias o rotas. Para planificar las herramientas de forma conjunta según la estructura de su tienda, en lugar de configurarlas una a una, puede consultar la guía cómo configurar el SEO del comercio electrónico, y para explicar las páginas al motor de búsqueda, el artículo qué son los datos estructurados. Si tiene una tienda multilingüe, el artículo qué es la etiqueta hreflang es complementario para conectar entre sí las versiones de idioma.
Preguntas frecuentes
¿Qué es el presupuesto de rastreo?
El presupuesto de rastreo es la cantidad de páginas que el bot de un buscador puede y quiere recorrer en un sitio durante un tiempo determinado. Lo definen en conjunto el ritmo de rastreo que su servidor puede soportar (límite de velocidad de rastreo) y el nivel de interés del bot por rastrear su sitio (demanda de rastreo).
¿Puede el presupuesto de rastreo ser un problema para un sitio pequeño de comercio electrónico?
Por lo general, no. En un sitio con pocas páginas y una estructura de URL limpia, el bot puede recorrer todas las páginas. El asunto se vuelve serio en las tiendas grandes que generan muchas URL de productos, filtros y ordenación, o que añaden y eliminan contenido constantemente.
¿Qué consume más presupuesto de rastreo?
En el comercio electrónico, las causas más frecuentes son las direcciones de filtro y orden, las páginas duplicadas, las cadenas de redirección, las direcciones con errores, la paginación infinita y la respuesta lenta del servidor. El punto común de todas es que el bot gasta tiempo en direcciones de poco valor.
¿Cómo se detecta un problema de presupuesto de rastreo?
La forma más fiable es revisar los registros del servidor y ver a qué URL accede el bot. Además, las estadísticas de rastreo que ofrece el buscador muestran la tendencia de solicitudes del bot, los códigos de estado y la velocidad de respuesta. Que las páginas nuevas tarden en indexarse puede ser una señal, pero por sí solo no es una prueba.
¿Protege el presupuesto de rastreo la etiqueta canonical?
Por sí sola, no. Canonical es una pista sólida que indica la URL principal y sirve mucho para la indexación y la consolidación de señales, pero el bot puede seguir visitando la página con canonical. Para las URL que no deben rastrearse en absoluto resulta más adecuado robots.txt, y para las URL trasladadas de forma permanente, una redirección 301.
¿Desaparece del índice una página que bloqueo con robots.txt?
No siempre. robots.txt impide que el bot rastree la página, pero si la URL recibe enlaces desde otros sitios, puede seguir siendo conocida. Si no quiere que una página aparezca en el índice, puede ser necesario combinar el permiso de rastreo con una señal como noindex; elija la herramienta adecuada según la finalidad de la página.