
Contenido 14 secciones
- ¿Qué es el robots.txt?
- ¿Qué es un rastreador (bot) y cómo se relaciona con el robots.txt?
- ¿Dónde está el archivo robots.txt y cómo se crea?
- ¿Qué significan las líneas del robots.txt?
- ¿Cuál es la diferencia entre robots.txt y noindex?
- ¿Qué debe bloquearse con robots.txt en una tienda de comercio electrónico?
- ¿Qué nunca debe bloquearse con robots.txt?
- ¿Cómo es un archivo robots.txt de ejemplo para una tienda de comercio electrónico?
- ¿Cuáles son los errores más comunes en robots.txt?
- ¿Cómo se gestionan los rastreadores de IA con robots.txt?
- ¿Cómo se prueba y se supervisa robots.txt?
- ¿Cómo funcionan juntos robots.txt y el SEO técnico?
- Gestión de robots y rastreo con Faprika
- Preguntas frecuentes
El escaparate de una tienda está abierto a todos, pero el almacén, la trastienda y la oficina de dirección no. En su sitio web ocurre algo parecido: las páginas de productos y categorías están abiertas a los visitantes y a los buscadores, mientras que el carrito, los pasos de pago, el área de administración y las infinitas URL de filtros no son lugares que todo el mundo deba ver. Existe un pequeño archivo de texto que explica esos límites a los robots automáticos de los buscadores (rastreadores, es decir, bots): robots.txt.
En esta guía respondemos con sencillez a la pregunta qué es robots.txt: qué es el archivo, dónde se ubica, cómo se escriben las líneas User-agent, Disallow, Allow y Sitemap, en qué se diferencia de noindex, qué conviene bloquear y qué nunca debe bloquearse en un sitio de comercio electrónico, cómo se gestionan los rastreadores de IA, los errores más frecuentes y los métodos de prueba. Al final encontrará la gestión de robots con Faprika y una sección de preguntas frecuentes de seis preguntas.
¿Qué es robots.txt?
Robots.txt es un archivo de texto plano ubicado en el directorio raíz de su sitio que indica a los rastreadores de los buscadores a qué direcciones pueden acceder y a cuáles no. Esta práctica, también conocida como “Protocolo de exclusión de robots”, es una norma común que se usa desde los primeros años de internet.
El archivo es una petición, no una orden. La gran mayoría de los buscadores la respeta, pero el archivo no obliga a nadie. Los bots malintencionados pueden ni siquiera leerlo; por eso robots.txt no se considera una medida de seguridad. Para un área que deba permanecer privada se necesitan contraseñas, autorización y ajustes del servidor; robots.txt es solo un acuerdo con los rastreadores honestos.
El archivo es un texto sencillo con extensión .txt; no se necesita ningún software especial. Se puede escribir con un bloc de notas, pero su nombre y su ubicación deben ser exactos: el nombre del archivo es robots.txt en minúsculas y su ubicación es el directorio raíz del sitio. En su forma más simple es así:
User-agent: *
Disallow:

Sitemap: https://magazaadresiniz/sitemap.xml
Este archivo de dos líneas significa “todos los rastreadores pueden acceder a todo, y la dirección de mi mapa es esta”. Una línea Disallow vacía no bloquea nada.
¿Qué es un rastreador (bot) y cómo se relaciona con robots.txt?
Un rastreador, bot o araña es un software que visita páginas web de forma automática, lee su contenido y descubre nuevas páginas siguiendo los enlaces. Los buscadores descubren su sitio con estos programas y lo añaden a sus índices.
Cuando un rastreador llega a un sitio, primero consulta el archivo robots.txt del directorio raíz. Si hay una regla para él, la aplica y luego empieza a recorrer el sitio. Si el archivo no existe (devuelve 404), supone que puede entrar en todas partes. Cada rastreador tiene su propio nombre y puede dirigirse a él en el archivo; ese nombre se llama “user-agent”.
El tiempo y los recursos que un rastreador dedica a un sitio son limitados. En el sector esto se llama presupuesto de rastreo. En un sitio de comercio electrónico grande, las combinaciones de filtros, los parámetros de ordenación y las páginas de búsqueda interna pueden generar cientos de miles de URL; si el rastreador gasta tiempo en ellas, sus productos nuevos y categorías importantes pueden descubrirse tarde. Robots.txt es la primera y más económica forma de dirigir ese recurso hacia las páginas valiosas.
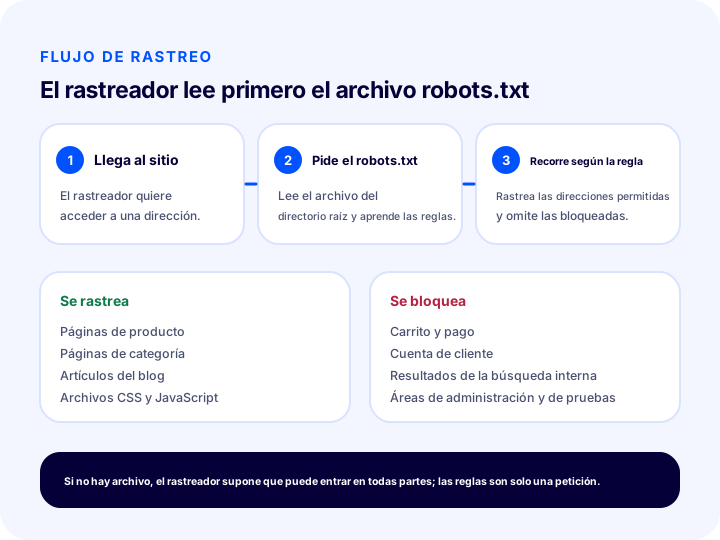
La ilustración resume el flujo: el rastreador llega al sitio, solicita el archivo robots.txt, lee las reglas y rastrea las direcciones permitidas; no entra en las bloqueadas. El mismo orden en texto es este: primero el archivo, luego la regla y después el rastreo.
¿Dónde se ubica robots.txt y cómo se crea?
Robots.txt debe estar en el directorio raíz de cada dominio (y de cada subdominio), en la dirección /robots.txt. Los rastreadores no buscan un archivo que esté en otra carpeta.
Esto tiene consecuencias prácticas:
- Una raíz, un archivo. Para el dominio principal de su tienda es válida la dirección
magazaadresiniz/robots.txt. Si tiene un subdominio (por ejemplo, para el blog), debe tener su propio robots.txt; el archivo del dominio principal no vincula al subdominio. - El protocolo y la versión del dominio importan. http y https, con www y sin www, son técnicamente direcciones distintas. Si hay una redirección a una sola versión, la regla debe estar en el archivo de esa versión.
- El nombre del archivo se escribe en minúsculas. Formatos como
Robots.txtorobots.TXTno son fiables. - El archivo debe ser texto plano. No un HTML, una imagen ni un documento con formato; texto sin formato, preferiblemente con codificación UTF-8.
- El archivo debe abrirse con código de estado 200. Si el archivo da error, el rastreador no sabe qué hacer, lo que hace impredecible su comportamiento de rastreo.
Hay dos formas de crearlo: escribir el archivo a mano y colocarlo en el directorio raíz, o usar el ajuste de robots que ofrece su plataforma de comercio electrónico. En las plataformas listas para usar, el archivo suele gestionarse desde el panel; en ese caso no hace falta subirlo manualmente. En las secciones siguientes construiremos el contenido del archivo paso a paso.
¿Qué significan las líneas de robots.txt?
Robots.txt se compone de cuatro líneas básicas: User-agent indica a quién pertenece la regla, Disallow qué se bloquea, Allow la excepción dentro del bloqueo y Sitemap la dirección del mapa del sitio. Las líneas se escriben en grupos y cada grupo empieza con una línea User-agent.
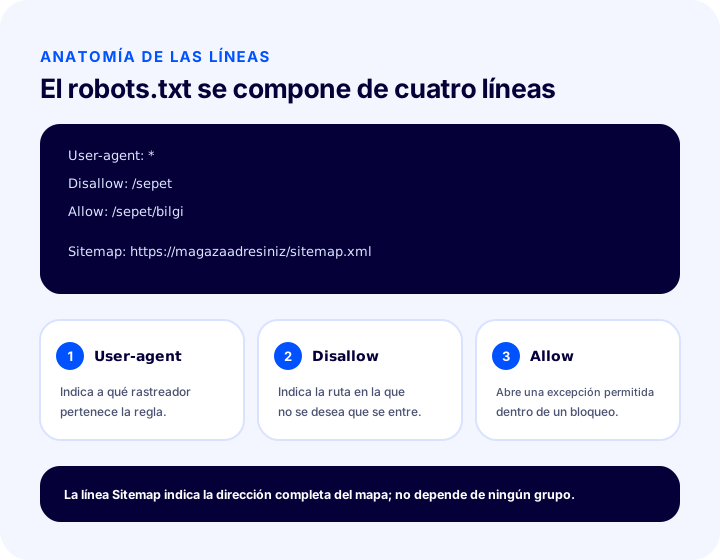
| Línea | ¿Qué indica? | Ejemplo |
|---|---|---|
| User-agent | A qué rastreador pertenece la regla; el asterisco (*) significa todos | User-agent: * |
| Disallow | Ruta a la que no se desea que se acceda | Disallow: /sepet |
| Allow | Ruta permitida dentro de un área bloqueada | Allow: /sepet/bilgi |
| Sitemap | Dirección completa del mapa del sitio | Sitemap: https://magazaadresiniz/sitemap.xml |
1. User-agent
User-agent indica a quién pertenece la regla. El asterisco (*) abarca a todos los rastreadores. Si desea escribir una regla aparte para un rastreador concreto, escribe su nombre; ese rastreador consulta tanto su propio grupo como el grupo del asterisco, pero si existe un grupo específico para él, normalmente aplica solo ese. Por eso, al abrir un grupo aparte para un rastreador concreto, puede que deba escribir también en él las reglas generales.
2. Disallow
Disallow indica la ruta bloqueada. La ruta empieza con una barra y abarca todas las direcciones que empiezan por ella. Si escribe Disallow: /sepet, se bloquea toda dirección que empiece por /sepet (por ejemplo, /sepet/odeme). Dejar la línea vacía significa “no bloquear nada”.
3. Allow
Allow sirve para abrir una pequeña excepción dentro de un bloqueo amplio. Por ejemplo, puede bloquear una carpeta y permitir una única subcarpeta dentro de ella. Si varias reglas abarcan la misma dirección, por lo general gana la ruta más específica (más larga).
4. Sitemap
La línea Sitemap indica la dirección completa de su mapa del sitio. Puede estar en cualquier parte del archivo y no depende de ningún grupo User-agent. Al leer robots.txt, el rastreador conoce también la dirección de su mapa. Cómo preparar el mapa del sitio se explica en la guía qué es un mapa del sitio.
5. Comodines y marcador de fin de línea
El asterisco (*) dentro de una ruta significa “cualquier secuencia de caracteres”; el signo de dólar ($) indica que la dirección termina justo ahí. Ambos son compatibles con los rastreadores principales, pero la compatibilidad de cada rastreador puede no ser igual; verifique primero las reglas críticas con una pequeña prueba.
User-agent: *
Disallow: /*?sirala=
Disallow: /*.pdf$
La primera regla bloquea toda dirección que contenga ?sirala=; la segunda cierra las direcciones que terminan exactamente en .pdf. Preste atención a la distinción entre mayúsculas y minúsculas: las rutas suelen distinguirlas, mientras que los nombres de las directivas (User-agent, Disallow) no.
También se pueden escribir líneas de comentario en el archivo: los rastreadores ignoran las líneas que empiezan por #. Dejar notas breves para recordar dentro de unos meses por qué puso esa regla es un buen hábito.
¿Cuál es la diferencia entre robots.txt y noindex?
Robots.txt impide que el rastreador acceda a una dirección; noindex pide que la página no aparezca en los resultados de búsqueda. Una página bloqueada con robots.txt puede seguir apareciendo en el índice con su dirección si recibe enlaces de otros sitios, porque el rastreador no entra en la página y no puede ver su contenido ni la instrucción noindex.
Este es el malentendido más frecuente: robots.txt no elimina una página del índice. Si quiere que una página desaparezca de los resultados, el rastreador debe poder entrar en ella y leer la directiva noindex; esto significa que no debe bloquear esa página en robots.txt.
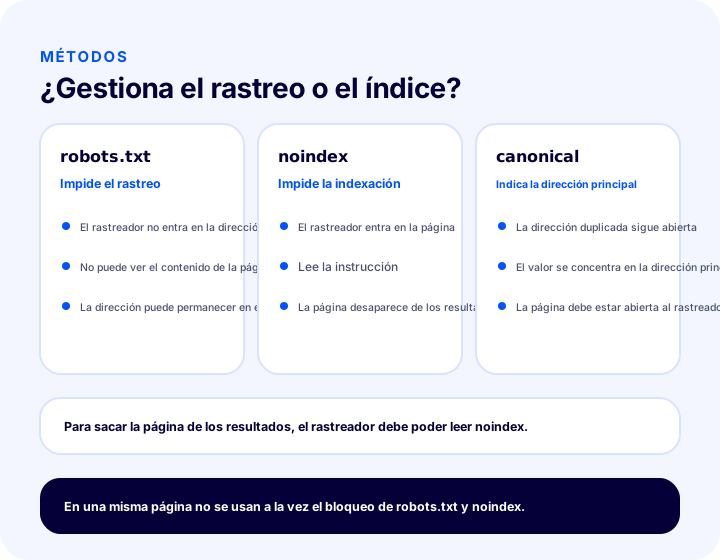
| Función | Robots.txt | Noindex |
|---|---|---|
| ¿Dónde se define? | En el archivo robots.txt del directorio raíz | En la metaetiqueta de la página o en el encabezado de la respuesta del servidor |
| ¿Qué gestiona? | El rastreo (¿entra el rastreador en la página?) | La indexación (¿aparece la página en los resultados?) |
| ¿Es visible la página en los resultados? | Si hay enlaces desde otros sitios, puede aparecer como dirección | No es visible, si el rastreador puede leer la instrucción |
| ¿Entra el rastreador en la página? | No entra | Entra y lee la instrucción |
| Uso típico | Proteger el recurso de rastreo y cerrar espacios de direcciones infinitos | Páginas que no deben aparecer en los resultados |
| ¿Se pueden usar juntos? | Entra en conflicto con noindex en la misma página | No bloquee la misma página con robots.txt |
El criterio es este: cierre con robots.txt las áreas que malgastan el recurso de rastreo y que nunca deben estar en los resultados (como las combinaciones de filtros infinitas). Use noindex cuando la página no deba aparecer en los resultados pero el rastreador deba poder leerla. Si el mismo contenido tiene varias direcciones, indique la dirección principal con la etiqueta canonical; para los detalles de esta diferencia puede consultar el artículo qué es la etiqueta canonical.
¿Qué debe bloquearse con robots.txt en un sitio de comercio electrónico?
En un sitio de comercio electrónico suelen bloquearse con robots.txt el carrito y los pasos de pago, las páginas de cuenta de cliente, los resultados de búsqueda interna, las direcciones con parámetros de filtro y ordenación y las áreas de administración. El punto en común es que estas direcciones no tienen equivalente en los resultados de búsqueda y malgastan el recurso de rastreo.
1. Carrito y pasos de pago
Las páginas del carrito y del pago son personales; muestran contenido distinto a cada visitante y no tiene sentido que aparezcan en los resultados de búsqueda. No hace falta que el rastreador acceda a estas direcciones. La seguridad de las páginas de pago, con medidas como el certificado SSL, es otro asunto; robots.txt no protege estas páginas, solo pide mantener alejado al rastreador.
2. Cuenta de cliente y páginas de acceso
El inicio de sesión de miembros, mis pedidos, la libreta de direcciones y las páginas de restablecimiento de contraseña también se cierran por el mismo motivo. Estas páginas no tienen contenido buscable; además, como contienen información propia de cada usuario con sesión iniciada, no tiene sentido que el rastreador se ocupe de ellas.
3. Resultados de búsqueda interna
Cada consulta que el cliente escribe en el cuadro de búsqueda genera una dirección nueva. El número de estas direcciones es ilimitado y no tiene valor de contenido permanente. Cerrar esta área con robots.txt evita que el rastreador deambule por un pozo infinito de direcciones.
4. Parámetros de filtro y ordenación
Las selecciones de color, talla, rango de precio y ordenación añaden parámetros a la dirección. La combinación de unos pocos filtros puede producir cientos de miles de direcciones. La mayoría muestra los mismos productos en otro orden, por lo que no tiene valor de búsqueda propio. En lugar de cerrarlas todas, decida qué páginas de filtro son realmente páginas de entrada buscadas; mantenga abierta al rastreo una página de filtro que se busque (p. ej., una combinación concreta de color y categoría). Para el lado del usuario del diseño de filtros, consulte la guía de optimización de filtros de productos y barra de búsqueda.
5. Áreas de administración y páginas temporales
El panel de administración, las páginas de prueba y vista previa, las copias de seguridad y los archivos de uso interno no deben aparecer en los resultados de búsqueda. Recordatorio: el archivo robots.txt es público; cualquiera puede ver también las rutas que usted bloquea. Por eso, escribir en robots.txt el nombre de un área realmente privada equivale a anunciarla. Para la privacidad es imprescindible el control de acceso.
6. Calendarios infinitos, sesiones y URL de seguimiento
Las direcciones que llevan un número de sesión o a las que se añade un parámetro de seguimiento de campañas generan copias de la página. En lugar de robots.txt, suele ser más correcto gestionarlas con canonical; si las bloquea, el rastreador no puede entrar en la página y leer la dirección principal.
| Campo | ¿Se bloquea con robots.txt? | ¿Por qué? |
|---|---|---|
| Carrito y pago | Sí | Es personal y no tiene valor de búsqueda |
| Cuenta de cliente y acceso | Sí | Contenido personal, rastreo innecesario |
| Resultados de la búsqueda interna | Sí | Direcciones infinitas, sin valor permanente |
| Filtros y ordenación aleatorios | Normalmente sí | Los mismos productos, muchas direcciones |
| Página de filtro especial que se busca | No | Puede ser una verdadera página de entrada |
| Áreas de administración y de pruebas | Sí, y además control de acceso | No debe estar en el índice |
| Direcciones con parámetros de seguimiento | Por lo general no, mejor con canonical | El rastreador debe poder leer la dirección principal |
¿Qué nunca debe bloquearse con robots.txt?
Las páginas de productos, las páginas de categorías, las entradas del blog y los archivos de estilo (CSS) y de script (JavaScript) que forman el aspecto de las páginas no deben bloquearse con robots.txt. Si se bloquean, el buscador o bien no ve la página o la ve rota.
- Páginas de productos y categorías. Son las páginas que generan ingresos en su tienda; bloquearlas supone una pérdida directa de visibilidad.
- Blog y páginas informativas. Son una fuente importante de tráfico de búsqueda.
- Archivos CSS y JavaScript. Los buscadores quieren renderizar la página tal como la ve el visitante. Si se bloquean los archivos de estilo y de script, la página puede verse rota o vacía; también se ven afectadas la evaluación de compatibilidad móvil y de experiencia de página.
- Imágenes. Bloquear el rastreo de las imágenes de producto elimina la visibilidad en la búsqueda de imágenes.
- Mapa del sitio. Ni el propio mapa ni las URL que contiene deben estar bloqueados.
- URL antiguas redirigidas. El rastreador debe poder acceder a la URL antigua para ver la redirección 301. Si bloquea la URL antigua, la redirección no transfiere valor; los detalles están en el artículo qué es una redirección 301.
- Páginas con datos estructurados. Los marcados de resultados enriquecidos, como producto y valoraciones, solo se leen si la página es rastreable; para más detalles consulte la guía qué son los datos estructurados.
¿Cómo es un archivo robots.txt de ejemplo para comercio electrónico?
El siguiente archivo es un ejemplo sencillo para un sitio de comercio electrónico de tamaño medio: bloquea el carrito, la cuenta, la búsqueda y las URL con parámetros, e indica el mapa del sitio. Las rutas varían según cada tienda; adáptelo a las rutas reales de su propio sitio.
# Tüm tarayıcılar için genel kurallar
User-agent: *
Disallow: /sepet
Disallow: /odeme
Disallow: /hesabim
Disallow: /giris
Disallow: /arama
Disallow: /*?sirala=
Disallow: /*?oturum=

Sitemap: https://magazaadresiniz/sitemap.xml
La lógica del archivo es esta: la primera línea de comentario indica su propósito; User-agent: * selecciona todos los rastreadores; las líneas siguientes bloquean las áreas personales, la búsqueda interna y las URL con parámetros de orden y sesión; la última línea indica dónde está el mapa del sitio. Ninguna línea bloquea CSS, JavaScript ni las URL de productos y categorías.
Ejemplo de excepción con Allow
Allow se usa cuando quiere bloquear una carpeta pero permitir una sola subruta dentro de ella:
User-agent: *
Disallow: /hesabim
Allow: /hesabim/yardim
En este ejemplo el área de cuenta está bloqueada; solo se puede rastrear la página de ayuda pública. Como estas excepciones complican las reglas, úselas únicamente cuando sea realmente necesario.
El precio de un error: la diferencia de una sola línea
Las dos reglas se parecen mucho, pero sus resultados son completamente opuestos:
Disallow:    # hiçbir şeyi engellemez
Disallow: /  # tüm siteyi engeller
La primera no tiene barra y permite rastrear todo el sitio. En la segunda, una sola barra bloquea todo el sitio a los rastreadores. Esta diferencia es el tema de la siguiente sección.
¿Cuáles son los errores más comunes en robots.txt?
La mayoría de los errores de robots.txt provienen de pequeños detalles de escritura, pero sus consecuencias son grandes. Como un único archivo de reglas afecta a todo el sitio, cada cambio debe hacerse con cuidado. Estos son los más habituales.
- Bloquear todo el sitio por error. La línea
Disallow: /cierra todo el sitio. Esta regla, que muchas veces se puso para el sitio de pruebas antes de la publicación, se olvida al pasar al sitio en producción y la tienda empieza a desaparecer de los resultados de búsqueda. Debe incluirse siempre en la lista de comprobación previa y posterior a la publicación. - Bloquear los archivos CSS y JavaScript. Este hábito, que fue común en el pasado, hoy hace que la página se vea rota y provoca problemas en la evaluación de la experiencia de página.
- Creer que robots.txt sirve para sacar páginas del índice. Una página bloqueada puede seguir en el índice con su URL. Para quitarla de los resultados se usa noindex.
- Dejar una página bloqueada en el mapa del sitio. Bloquear con robots.txt una URL que está en el mapa equivale a decirle al rastreador «ven» y «no entres» a la vez. Las señales contradictorias reducen la confianza en ambas.
- Colocar el archivo en un lugar equivocado. Un archivo que no está en el directorio raíz, que se guardó con otro nombre o que devuelve un error no se lee; todas las reglas se pierden.
- Escribir rutas que deben permanecer ocultas. El archivo es público; escribir la ruta del panel de administración equivale a anunciarla.
- Errores de escritura y de formato. Unos dos puntos que faltan, un nombre de directiva mal escrito o una ruta que no empieza con barra invalidan la regla. Algunos rastreadores omiten la línea errónea; otros pueden ignorar todo el grupo.
- Usar comodines demasiado amplios. Una regla con asterisco puede abarcar sin que lo advierta también las URL de productos o categorías. Pruebe cada regla con comodín sobre las URL a las que afecta.
- Copiar el archivo del sitio de pruebas a producción, o al revés. Pasar el archivo de producción al entorno de pruebas puede abrir el rastreo innecesariamente; que el archivo de pruebas pase a producción puede cerrar el sitio.
- No comprobar tras el cambio. Después de actualizar el archivo, la versión anterior puede permanecer un tiempo en la memoria del buscador; no dé el trabajo por terminado sin verificar que el cambio está vigente.
¿Cómo gestionar los rastreadores de IA con robots.txt?
Los rastreadores de IA, como los buscadores, se identifican con un nombre de user-agent y la mayoría afirma respetar las reglas de robots.txt. Así puede decidir por separado qué rastreador de IA puede acceder a su sitio.
Hay dos objetivos distintos y la decisión depende de su modelo de negocio:
- Si quiere ser visible. Si desea que los asistentes de IA mencionen sus productos, sus guías y su marca, hay que permitir el acceso a sus rastreadores. En ese caso no los bloquee; lo más importante es que su contenido sea claro, esté bien organizado y se pueda citar.
- Si quiere limitar el uso del contenido. Si no desea que un rastreador de IA concreto entre en su sitio, escribe un grupo aparte para su nombre de user-agent.
# Belirli bir yapay zekâ tarayıcısını tüm siteden uzak tutma
User-agent: ornek-yapay-zeka-botu
Disallow: /

# Diğer tarayıcılar için genel kurallar
User-agent: *
Disallow: /sepet
Disallow: /odeme
El nombre del ejemplo es representativo; los nombres reales de los rastreadores debe consultarlos en la documentación que publica cada servicio de IA. Como el nombre y el comportamiento de los rastreadores pueden cambiar con el tiempo, revise estas reglas de vez en cuando. Recuerde: robots.txt es una petición y no todos los rastreadores de IA tienen por qué respetarla; para el contenido que realmente deba protegerse es imprescindible un control de acceso.
¿Cómo se prueba y supervisa robots.txt?
Para probar robots.txt hay que abrir el archivo en el navegador y ver su contenido, comprobar que las URL importantes no están bloqueadas y seguir los informes de robots en la herramienta de administración del buscador. La prueba debe repetirse antes de publicar el archivo y después de cada cambio.
- Abra el archivo. Escriba
magazaadresiniz/robots.txten el navegador. Debe verse texto plano y la página no debe dar error. - Lea las reglas. Asegúrese de que ninguna regla bloquee sin querer todo el sitio ni el área de productos y categorías.
- Pruebe URL de ejemplo. Elija la URL de una ficha de producto, una página de categoría, un artículo del blog, un archivo de estilo y un archivo de script; compruebe que ninguna esté bloqueada. Con el mismo método, compruebe que las URL del carrito y de la búsqueda sí están bloqueadas.
- Consulte los informes de la herramienta de administración del buscador. En estas herramientas se muestran el estado del archivo robots, la fecha de la última lectura y las URL bloqueadas. Si la advertencia «Bloqueada por robots.txt» aparece para una página importante, revise la regla de inmediato.
- Compare con el mapa. Compruebe que ninguna de las URL del mapa del sitio esté bloqueada por robots.txt.
- Supervise tras el cambio. Los cambios en las reglas pueden no surtir efecto de inmediato; siga durante unas semanas las estadísticas de rastreo y el estado del índice.
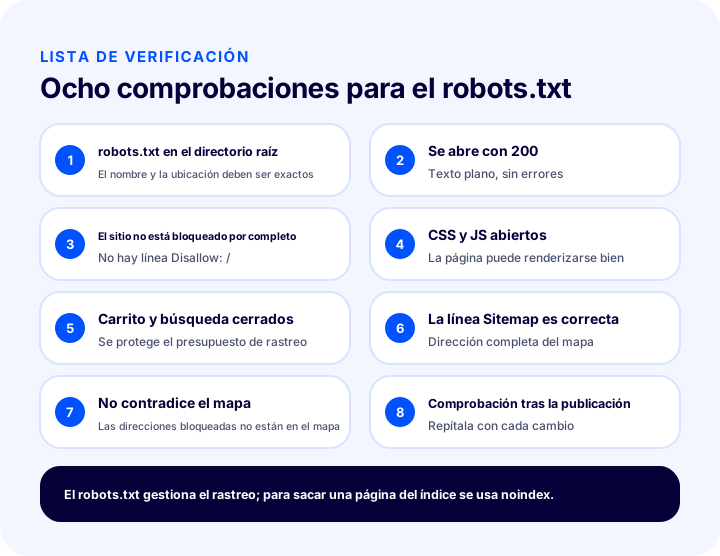
Los ocho puntos de la ilustración también aparecen a continuación como lista, para tenerlos a mano durante una revisión detallada:
| # | Comprobación | ¿Qué pasa si es incorrecto? |
|---|---|---|
| 1 | El archivo está en el directorio raíz y se llama robots.txt | Los rastreadores no encuentran el archivo |
| 2 | El archivo abre con 200 y es texto plano | El comportamiento del rastreo se vuelve impredecible |
| 3 | No hay ninguna línea que bloquee todo el sitio | La tienda desaparece de los resultados de búsqueda |
| 4 | CSS, JavaScript e imágenes accesibles | La página se ve rota o vacía |
| 5 | Carrito, cuenta y búsqueda bloqueados | Se desperdicia el presupuesto de rastreo |
| 6 | La línea Sitemap apunta a la URL correcta | Se dificulta el descubrimiento del mapa |
| 7 | Las URL bloqueadas no están en el mapa ni en noindex | Se generan señales contradictorias |
| 8 | Comprobación tras cada publicación y cambio | El error puede pasar semanas sin detectarse |
Tras las correcciones, el resultado puede tardar en verse: hasta que el buscador vuelva a leer el archivo y reevalúe las páginas, el estado anterior puede permanecer en los resultados. Esperar y seguir los informes es una parte natural de este proceso.
Le recomendamos leer¿Por qué es importante la velocidad del sitio en el comercio electrónico?¿Cómo funcionan juntos robots.txt y el SEO técnico?
Robots.txt es la capa de rastreo del SEO técnico; cobra sentido cuando funciona junto con el mapa del sitio, canonical, noindex y las redirecciones. Una regla aislada no da resultado si contradice las señales que la rodean.
| Herramienta | Pregunta que responde | Relación con robots.txt |
|---|---|---|
| Robots.txt | ¿Se debe entrar en esta URL? | Gestiona el rastreo |
| Sitemap | ¿Qué páginas quiero que se rastreen? | Las URL del mapa no deben estar bloqueadas |
| Canonical | ¿Cuál es la dirección principal de este contenido? | Una página bloqueada no puede leer canonical |
| Noindex | ¿Debe aparecer esta página en los resultados? | El rastreador debe poder entrar en la página |
| Redirección 301 | ¿Dónde está ahora esta dirección? | La URL antigua no debe estar bloqueada |
El orden práctico es este: primero decida qué páginas quiere que se rastreen e indexen y luego exprese esa decisión con la herramienta adecuada. Robots.txt sirve sobre todo para el «espacio infinito y sin valor»; para la decisión de «que esta página no aparezca en los resultados» son más adecuados noindex, y para «este contenido no está aquí, sino allí», la redirección y canonical. Para configurar todo esto en conjunto en toda la tienda, encontrará la guía cómo configurar el SEO de comercio electrónico, y en el artículo SEO de páginas de categoría verá cómo reforzar esas páginas. El artículo páginas legales de un sitio de comercio electrónico explica cómo organizar las páginas legales y corporativas de la tienda.
Gestión de robots y rastreo con Faprika
En la infraestructura de comercio electrónico de Faprika, los ajustes de buscador como robots y el mapa del sitio forman parte de la gestión SEO de la tienda. En la comparación de características de los planes, la fila «Canonical / Gestión de etiquetas H / Robots / Sitemap» muestra esta área de gestión; para los traslados de URL y la gestión de URL antiguas existe la fila «Panel 301 / 302 / 410 / Gestión de registros de URL».
Funciones como «Actualización automática masiva de SEO/Meta» para los títulos y descripciones y «Informes SEO» para seguir el rendimiento de búsqueda de la tienda también figuran en la comparación de planes. Las herramientas de gestión SEO que incluye cada plan pueden variar; para el alcance actual consulte la página de comercio electrónico planes. Para conocer qué equivale en su tienda un cambio en el archivo robots y su alcance, lo más seguro es consultar al equipo de Faprika: así aclaran juntos qué áreas se gestionan desde el panel.
Considerar el ajuste general del SEO con la guía cómo configurar el SEO de comercio electrónico, los traslados de URL con la guía redirección 301 y las decisiones sobre el mapa y las URL únicas con los artículos mapa del sitio y etiqueta canonical, hace que su tienda transmita un mensaje coherente a los buscadores.
Preguntas frecuentes
¿Qué es el robots.txt?
El robots.txt es un archivo de texto plano que se encuentra en el directorio raíz del sitio e indica a los rastreadores de los buscadores a qué direcciones pueden entrar y a cuáles no. No es una orden, sino una petición; la mayoría de los rastreadores honestos la respetan. Gestiona el rastreo, no saca las páginas del índice.
¿Dónde se encuentra el archivo robots.txt?
Se encuentra en el directorio raíz de cada nombre de dominio, en la dirección /robots.txt. Cada subdominio debe tener su propio archivo. El archivo se nombra en minúsculas, debe ser texto plano y abrirse con el código de estado 200. Puede ver su contenido escribiendo magazaadresiniz/robots.txt en el navegador.
¿Son lo mismo el robots.txt y noindex?
No. El robots.txt impide que el rastreador entre en una dirección; noindex pide que la página no aparezca en los resultados de búsqueda. Una página bloqueada con robots.txt puede seguir apareciendo en el índice con su dirección si recibe enlaces de otros sitios. Para sacar la página de los resultados, el rastreador debe poder entrar en ella y leer noindex; por eso no debe bloquear esa misma página con robots.txt.
¿Qué debe bloquearse con robots.txt en el comercio electrónico?
Por lo general se bloquean los pasos del carrito y del pago, la cuenta de cliente y las páginas de inicio de sesión, los resultados de la búsqueda interna, las direcciones con parámetros arbitrarios de filtro y orden, y las áreas de administración y de pruebas. En cambio, no deben bloquearse las páginas de producto, categoría y blog ni los archivos CSS, JavaScript e imágenes.
¿Qué hace Disallow: / en el robots.txt?
Cierra todo el sitio a los rastreadores. Se usa sobre todo en el sitio de pruebas previo a la publicación; si se traslada por olvido al sitio en producción, la tienda empieza a desaparecer de los resultados de búsqueda. Comprobar el robots.txt después de cada publicación y cambio evita este error.
¿Puedo bloquear los rastreadores de IA con el robots.txt?
Sí, la mayoría de los rastreadores de IA se identifican con su propio nombre de user-agent e indican que respetan las reglas del robots.txt. Puede escribir un grupo aparte para un rastreador concreto y cerrarle todo el sitio o algunas secciones. Sin embargo, el robots.txt es una petición; no se puede garantizar que todos la respeten. Si quiere ser visible en los asistentes de IA, piénselo antes de bloquear en bloque.


