Inhalt 11 Abschnitte
- Warum wird meine Seite nicht indexiert?
- Woran erkennen Sie, dass Ihre Seite nicht indexiert ist?
- Was sind die acht häufigsten Ursachen für eine nicht indexierte Seite?
- Wie diagnostizieren Sie eine nicht indexierte Seite?
- Welche besonderen Ursachen gibt es für fehlende Indexierung in E-Commerce-Shops?
- Wie lange sollten Sie nach der Behebung des Problems warten?
- Wie werden neue Produktseiten schneller gefunden?
- Welche Fehler passieren häufig bei Indexierungsproblemen?
- Indexierungs-Checkliste
- Indexierungsprobleme mit Faprika verwalten
- Häufig gestellte Fragen
Sie haben eine neue Produktseite veröffentlicht, die Fotos gemacht und die Beschreibung sorgfältig geschrieben. Tage vergehen, doch die Seite taucht in den Suchergebnissen immer noch nicht auf. Geben Sie ihre Adresse oder ihren Titel in die Suchleiste ein, erscheint nur die Startseite Ihrer eigenen Website. Diese Stille ist im E-Commerce eine häufige und ärgerliche Situation: Das Produkt ist da, der Bestand ist da, ein Werbebudget ist eingeplant, aber die Suchmaschine hat die Seite nicht in ihre Liste aufgenommen.
In diesem Ratgeber beantworten wir Schritt für Schritt die Frage, warum meine Seite nicht indexiert wird. Zuerst klären wir den Unterschied zwischen Crawling, Indexierung und Ranking; danach behandeln wir acht häufige Ursachen für fehlende Indexierung (das Noindex-Tag, eine robots.txt-Sperre, ein Canonical-Tag, das auf eine andere Seite zeigt, Weiterleitungen und 404, dünner oder doppelter Inhalt, eine verwaiste Seite ohne interne Links, das Fehlen in der Sitemap sowie eine neue Website mit Qualitätsbewertung). Anschließend finden Sie eine Diagnosetabelle, mit der Sie die Ursache Schritt für Schritt ermitteln, die Logik des Wartens nach einer Korrektur, Maßnahmen für die schnelle Entdeckung neuer Produktseiten, eine Checkliste, Hinweise zu Faprika und ein FAQ mit sechs Fragen.
Warum wird meine Seite nicht indexiert?
Eine Seite wird möglicherweise nicht indexiert, weil die Suchmaschine sie nicht findet, sie nicht crawlen darf, ein Signal gegen die Aufnahme in den Index erkennt oder die Seite nicht originell und wertvoll genug für eine Aufnahme findet. Zu erkennen, in welcher dieser vier Situationen Sie sich befinden, ist der erste Schritt zur richtigen Lösung.
Um das Thema richtig einzuordnen, müssen Sie drei Begriffe voneinander trennen, denn die meisten Missverständnisse entstehen durch deren Vermischung. Crawling bedeutet, dass die Suchmaschine eine Seite findet und ihren Inhalt liest. Indexierung bedeutet, dass die gelesene Seite in die große Datenbank (den Index) der Suchmaschine aufgenommen wird. Ranking ist die Position, an der eine indexierte Seite für eine Suchanfrage angezeigt wird. Eine Seite kann nicht ranken, ohne gecrawlt und indexiert zu sein; umgekehrt ist aber auch die Indexierung einer gecrawlten Seite nicht garantiert.
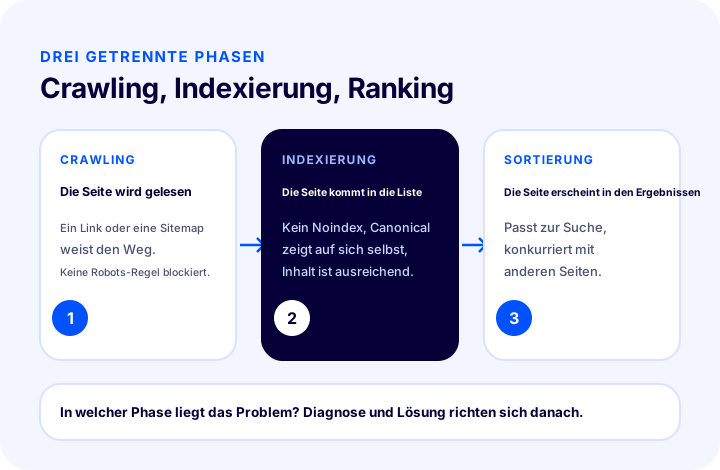
| Phase | ماذا يحدث؟ | Symptom bei einem Problem |
|---|---|---|
| Crawling | Die Suchmaschine findet und liest die Seite | Die Seite wird nie besucht oder liefert einen Fehler |
| Indexierung | Die Seite wird in den Index aufgenommen | Die Seite wurde gelesen, ist aber nicht im Index |
| Sortierung | Die Seite erhält für eine Suchanfrage eine Position | Die Seite ist im Index, aber weit hinten in den Ergebnissen |
Dieser Leitfaden konzentriert sich auf die ersten beiden Phasen. Ist Ihre Seite indexiert, rankt aber schlecht, liegt das Problem woanders: Dann spielen Themen wie die Erfüllung der Suchintention, die Qualität von Titel und Beschreibung, die Seitengeschwindigkeit und die Linkstruktur eine Rolle. Dazu empfehlen wir unsere Leitfäden zum Thema e-ticarette anahtar kelime analizi und Title-Tag richtig schreiben .
Woran erkennen Sie, dass Ihre Seite nicht indexiert ist?
Der zuverlässigste Weg zu prüfen, ob eine Seite indexiert ist, ist die URL-Prüfung im Webmaster-Tool der Suchmaschine. Das Tool zeigt Ihnen, ob die eingegebene Adresse im Index ist, wann sie zuletzt gecrawlt wurde und gegebenenfalls, warum sie nicht aufgenommen wurde.
Wenn Sie das Tool nicht nutzen können oder einen schnellen ersten Eindruck wünschen, gibt es einige einfache Wege: den vollständigen Seitentitel in Anführungszeichen in das Suchfeld eingeben, den Produktnamen zusammen mit dem Namen Ihres Shops suchen oder die Adresse der Seite direkt suchen. Diese Methoden liefern kein sicheres Ergebnis; die Seite kann indexiert sein, aber bei der Anfrage nicht auffallen. Für die eigentliche Diagnose ist daher das Webmaster-Tool entscheidend.
Die im Tool angezeigten Status liefern den ersten Hinweis. Ihre allgemeine Bedeutung ist folgende:
| Status im Tool (allgemeine Bedeutung) | Was bedeutet das? | Erste Anlaufstelle |
|---|---|---|
| Gefunden, aktuell nicht gecrawlt | Die Suchmaschine kennt die Adresse, hat die Seite aber nicht gelesen | Interne Links, Sitemap, allgemeiner Zustand der Website |
| Gecrawlt, aktuell nicht indexiert | Die Seite wurde gelesen, aber nicht als aufnahmewürdig eingestuft | Originalität und Ausführlichkeit des Inhalts, Ähnlichkeit zu Duplikaten |
| Durch noindex-Tag ausgeschlossen | Die Seite selbst verlangt, nicht aufgenommen zu werden | Seitencode und Antwort-Header |
| Durch robots.txt blockiert | Der Crawler betritt die Seite nicht | robots.txt-Regeln |
| Andere Seite als kanonisch gewählt | Eine andere Adresse hat wegen Canonical oder Ähnlichkeit Vorrang | Canonical-Tag |
| Weiterleitung oder Fehler „Nicht gefunden“ | Die Adresse führt woandershin oder lässt sich nicht öffnen | Antwortcode der Adresse |
Der genaue Wortlaut des Tools kann sich im Lauf der Zeit ändern; wichtig ist zu verstehen, in welche Gruppe ein Status gehört. Die folgenden Abschnitte behandeln jede dieser Gruppen.
Was sind die acht häufigsten Gründe, warum eine Seite nicht indexiert wird?
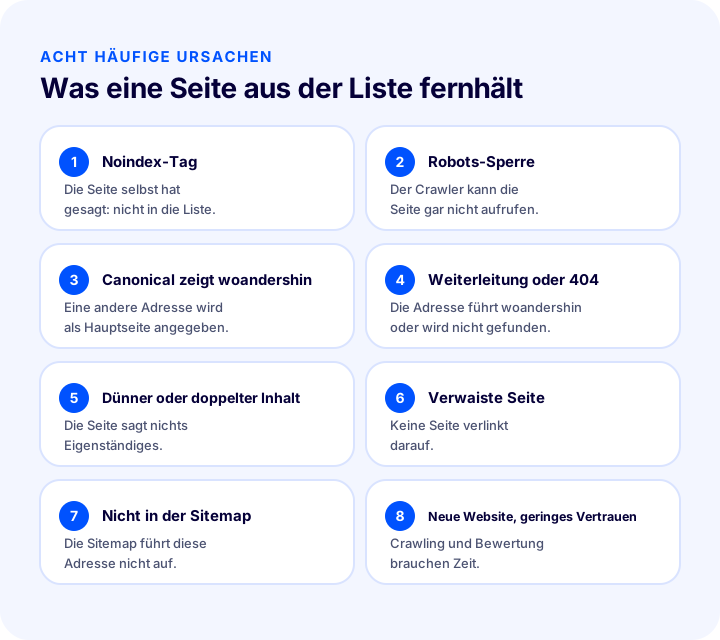
Die meisten nicht indexierten Seiten im E-Commerce lassen sich auf eine von acht Ursachen zurückführen: ein noindex-Tag, eine robots.txt-Sperre, ein Canonical auf eine andere Seite, eine Weiterleitung oder ein 404, dünner oder doppelter Inhalt, eine verwaiste Seite, das Fehlen in der Sitemap sowie eine neue Website oder geringes Vertrauen. Jede erfordert eine andere Lösung.
1. Das noindex-Tag
Noindex ist ein Signal, das besagt, dass die Seite nicht in den Suchergebnissen erscheinen soll. Es kann als Meta-Tag im Seitencode oder im Antwort-Header des Servers vorhanden sein. Bewusst eingesetzt ist es nützlich (etwa bei Warenkorb-, Kassen- und Kontoseiten); gelangt es aber versehentlich auf eine Produkt- oder Kategorieseite, wird diese nie in den Index aufgenommen.
Im E-Commerce ist die häufigste Quelle eine globale noindex-Einstellung aus der Vorbereitungsphase, die beim Livegang nicht entfernt wurde. Hinzu kommt der Template-Fehler: Ein noindex, das für einen Seitentyp gesetzt wird, gilt für alle Seiten dieses Typs. Suchen Sie im Seitencode nach einer Zeile wie dieser:
<meta name="robots" content="noindex, nofollow">Dieselbe Wirkung lässt sich mit einem vom Server gesendeten Antwort-Header erzielen; dann ist im Seitencode nichts zu sehen. Deshalb müssen Sie sowohl den Code als auch den Antwort-Header prüfen. Muss die Seite kein noindex tragen, entfernen Sie das Tag und warten Sie, bis die Seite erneut gecrawlt wird.
2. Die robots.txt-Sperre
Die robots.txt ist eine einfache Textdatei, die den Crawlern der Suchmaschinen mitteilt, welche Pfade sie betreten dürfen. Ist der Pfad einer Seite in dieser Datei gesperrt, betritt der Crawler die Seite nicht; er sieht deshalb weder ihren Inhalt noch ein noindex- oder Canonical-Signal auf der Seite.
Hier gibt es einen feinen Punkt: Die robots.txt sperrt das Crawling, steuert aber nicht direkt die Indexierung. Eine gesperrte Adresse kann wegen Links von außen im Index erscheinen, ohne dass ihr Inhalt gelesen wurde. Wenn Sie also nicht möchten, dass eine Seite im Index erscheint, ist noindex die richtigere Wahl als die robots.txt; umgekehrt müssen Sie die Sperre aufheben, wenn Sie eine Seite, die indexiert werden soll, per robots.txt gesperrt haben. Eine Beispielzeile für eine Sperre:
User-agent: *
Disallow: /urunler/
Eine solche Regel schließt alle Seiten unter „urunler“. Der Geltungsbereich einer Regel ist meist größer, als man denkt; wenn viele Seiten gleichzeitig nicht indexiert werden, ist dies eine der ersten Stellen, die Sie prüfen sollten. Details finden Sie im Leitfaden Was ist die robots.txt.
LesempfehlungWas ist die robots.txt? So richten Sie sie für einen E-Commerce-Shop ein3. Das Canonical-Tag verweist auf eine andere Seite
Das Canonical-Tag kennzeichnet unter ähnlichen Seiten die „Hauptseite“. Verweist das Canonical Ihrer Seite auf eine andere Adresse statt auf sich selbst, behandelt die Suchmaschine Ihre Seite als Duplikat und indexiert die andere Adresse. Wird Ihre Seite nicht indexiert, aber eine andere Adresse an ihrer Stelle gelistet, ist dies sehr wahrscheinlich die Ursache.
Typische Ursachen im E-Commerce sind: alle Variantenprodukte verweisen auf das Hauptprodukt (korrekt, wenn beabsichtigt), ein Template-Fehler, durch den alle Seiten auf die Startseite oder eine Kategorie verweisen, sowie Inkonsistenzen zwischen Adressvarianten (mit und ohne www, http und https). Die Prüfung ist einfach: Sehen Sie sich die Canonical-Zeile im Seitencode an und achten Sie darauf, ob die angegebene Adresse die eigene Adresse der Seite ist.
<link rel="canonical" href="https://magazaadresiniz/urun/ornek-urun">Soll eine Seite die Hauptseite sein, muss ihr Canonical-Tag auf sie selbst verweisen. Detaillierte Regeln finden Sie im Beitrag Was ist ein Canonical-Tag, zu den Quellen doppelter Seiten im Leitfaden Was ist Duplicate Content.
4. Weiterleitung oder 404
Gelangt eine Suchmaschine zu einer Adresse und wird statt zur Seite auf eine andere Adresse weitergeleitet, nimmt sie die Zieladresse in den Index auf. Lässt sich die Adresse gar nicht öffnen (404 oder Serverfehler), gibt es nichts aufzunehmen. Rufen Sie die Adresse Ihrer Seite im Browser auf: Öffnet sich das Produkt, ändert sich der Pfad in der Adressleiste, erscheint eine Fehlerseite?
Im E-Commerce zeigt sich das meist so: Wird ein Produktname oder eine Kategorie bearbeitet, ändert sich die Adresse, und die alte Adresse wird auf die neue weitergeleitet (richtig); nach einiger Zeit ändert sich aber auch die neue Adresse, und es entsteht eine Weiterleitungskette. Oder die Adresse eines gelöschten Produkts liefert einen 404 und steht weiterhin in der Sitemap. Sie müssen den richtigen Antwortcode wählen: 301 bei dauerhaften Umzügen, bei dauerhaft entfernten Seiten eine Weiterleitung auf eine passende Seite oder, wo nötig, 410. Das Thema vertiefen wir in den Beiträgen Was ist eine 301-Weiterleitung und Was ist eine 404-Seite.
| Antwort der Adresse | Was macht die Suchmaschine? | Was ist zu tun? |
|---|---|---|
| 200 (Seite wird geöffnet) | Liest und bewertet die Seite | Das Problem liegt woanders; setzen Sie die Diagnose fort |
| 301 (dauerhafte Weiterleitung) | Versucht, die Zieladresse zu indexieren | Die Zieladresse selbst sollte 200 liefern, ohne Kette |
| 302 (temporäre Weiterleitung) | Versucht möglicherweise, die ursprüngliche Adresse beizubehalten | Verwenden Sie bei einem dauerhaften Umzug 301 |
| 404 oder 410 | Entfernt die Seite aus dem Index | Soll die Seite bleiben, stellen Sie sie wieder her |
| 5xx (Serverfehler) | Kann die Seite nicht lesen und versucht es später erneut | Beheben Sie die Fehlerursache auf Serverseite |
5. Dünner oder doppelter Inhalt
Nach dem Lesen einer Seite stellt sich die Suchmaschine auch die Frage: „Lohnt sich die Aufnahme?“ Hat die Seite nichts Unterscheidbares (eine Beschreibung von wenigen Wörtern, den Herstellertext, den auch andere Websites verwenden, Dutzende nahezu identische Variantenseiten), wird sie gecrawlt, gelangt aber nicht in den Index. Ein beträchtlicher Teil der im Tool als „gecrawlt, aber nicht indexiert“ angezeigten Fälle gehört hierher.
Häufige Beispiele im E-Commerce: Produkte mit leerer oder einsätziger Beschreibung, Seiten mit unverändertem Herstellertext, Variantenseiten, die sich nur in Farbe oder Größe unterscheiden, sowie Kategorieseiten ohne gelistete Produkte und ohne Inhalt. Die Lösung besteht darin, der Seite tatsächlich etwas hinzuzufügen: eine Beschreibung auf Basis von Kundenfragen, Maß- und Pflegehinweise, ein Anwendungsszenario, eigene Bilder. Was eine Produktseite enthalten sollte, lesen Sie unter Wie sollte eine E-Commerce-Produktseite aussehen, zu Kategorieseiten unter SEO für Kategorieseiten.
6. Verwaiste Seite: von nirgendwo verlinkt
Eine verwaiste Seite ist eine Seite, die von keiner anderen Seite Ihrer Website einen Link erhält. Suchmaschinen finden neue Seiten meist, indem sie Links auf bestehenden Seiten folgen; ohne Links lässt sich die Seite nur über die Sitemap oder einen externen Link finden. Selbst wenn sie gefunden wird, vermittelt eine unverlinkte Seite den Eindruck, „für Ihre Website unwichtig“ zu sein.
Im E-Commerce entsteht eine verwaiste Seite meist so: Das Produkt wurde keiner Kategorie zugeordnet, durch die Seitennummerierung rutscht das Produkt auf eine sehr tiefe Seite der Kategorie, die Aktionsseite fehlt im Menü oder ein Blogbeitrag ist nirgends verlinkt. Die Lösung: die Seite mit der passenden Kategorie verknüpfen, im Menü oder in verwandten Inhalten einen Link setzen und nach Möglichkeit einen kurzen Weg von der Startseite oder einer Hub-Seite öffnen. Zur Linkstruktur helfen Ihnen die Beiträge Was ist ein interner Link und Wie sollte die Menüstruktur eines E-Commerce-Shops aussehen.
LesempfehlungWas ist ein interner Link? So bauen Sie ihn in einem E-Commerce-Shop auf7. Nicht in der Sitemap
Die Sitemap ist die Datei, die der Suchmaschine eine Liste der Seiten vorlegt, die indexiert werden sollen. Das Fehlen in der Sitemap ist für sich genommen kein Grund für die Nichtindexierung; eine Seite kann auch über Links gefunden werden. Besonders bei neuen, tief liegenden oder kaum verlinkten Seiten ist die Sitemap jedoch eine wichtige Hilfe, die die Entdeckung beschleunigt.
Sitemap-Probleme treten in zwei Richtungen auf. Manchmal ist eine Seite nie in die Sitemap gelangt (die Sitemap ist veraltet oder deckt bestimmte Seitentypen nicht ab). Manchmal enthält die Sitemap umgekehrt Adressen, die noindex tragen, weiterleiten oder 404 liefern, was ihre Glaubwürdigkeit untergräbt. Die Sitemap sollte nur Adressen enthalten, die Sie wirklich indexiert haben möchten, die 200 liefern und deren Canonical auf sie selbst verweist. Details finden Sie im Beitrag Was ist eine Sitemap.
8. Neue Website und geringes Vertrauen
Bei einer neuen, noch unbekannten Website verhält sich die Suchmaschine vorsichtiger: Sie besucht Seiten seltener und entscheidet selektiver über die Aufnahme. Das ist keine Strafe, sondern ein Kennenlernprozess. Verkürzt wird diese Phase wiederum durch dieselben Dinge: eine saubere technische Struktur, originelle und nützliche Inhalte, ein gutes internes Linknetz und mit der Zeit Links von außen.
Auch Geschwindigkeit und Nutzungsqualität der Website gehören zu den Vertrauenssignalen; eine langsame oder häufig fehlerhafte Website wird seltener gecrawlt. Deshalb beeinflussen die Geschwindigkeit eines E-Commerce-Shops und die Core Web Vitals die allgemeine Gesundheit, auch wenn sie nicht unmittelbar mit dem Indexierungsproblem zusammenhängen. Bei einer neuen Website braucht man Geduld; doch bevor Sie die Ausrede „Geduld“ bemühen, müssen Sie unbedingt die sieben genannten Ursachen ausschließen.
Wie diagnostizieren Sie eine nicht indexierte Seite?
Um eine nicht indexierte Seite zu diagnostizieren, müssen Sie die Ursachen der Reihe nach ausschließen: zuerst, dass sich die Adresse öffnen lässt, dann, dass nichts den Crawler behindert, danach die noindex- und Canonical-Signale und zuletzt Inhaltsqualität, Links und Sitemap. Die Reihenfolge ist wichtig, denn ein Hindernis in einem frühen Schritt macht die späteren Schritte bedeutungslos.
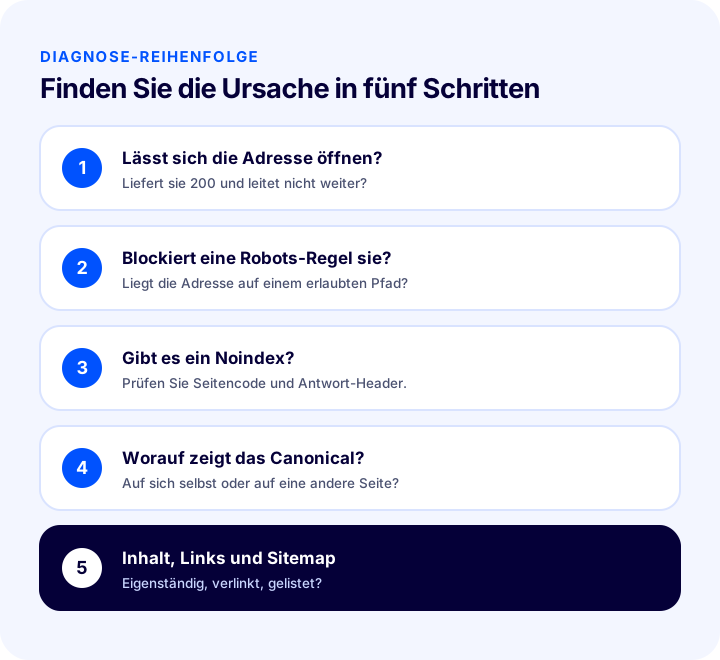
| Reihenfolge | Prüfpunkt | So prüfen Sie | Bei einem Befund |
|---|---|---|---|
| 1 | Lässt sich die Adresse öffnen? | Öffnen Sie sie im Browser; leitet sie weiter oder liefert sie einen Fehler? | Beheben Sie die Weiterleitung oder den 404/5xx |
| 2 | Blockiert eine Robots-Regel sie? | Gibt es in der robots.txt eine Regel, die zum Pfad der Adresse passt? | Schränken Sie die Regel ein oder entfernen Sie sie |
| 3 | Gibt es ein Noindex? | Suchen Sie im Seitencode und im Antwort-Header nach noindex | Entfernen Sie das Tag |
| 4 | Worauf zeigt das Canonical? | Ist die Adresse in der Canonical-Zeile die eigene Adresse der Seite? | Korrigieren Sie sie so, dass sie auf sich selbst verweist |
| 5 | Ist der Inhalt originell und ausreichend? | Vergleichen Sie die Seite mit konkurrierenden Seiten | Fügen Sie originellen Mehrwert hinzu |
| 6 | Wird auf die Seite verlinkt? | Suchen Sie nach Links in Kategorie, Menü und verwandten Inhalten | Fügen Sie interne Links hinzu |
| 7 | Ist sie in der Sitemap? | Suchen Sie die Adresse in der Sitemap-Datei | Aktualisieren Sie die Sitemap |
In der Praxis dauern die ersten vier Schritte nur Minuten und decken den Großteil der Probleme auf. Der fünfte und die folgenden erfordern mehr redaktionellen Aufwand. Notieren Sie bei jedem Schritt, was Sie finden; listen Sie außerdem weitere Seiten mit demselben Problem auf, denn technische Ursachen betreffen meist einen ganzen Seitentyp.
Was sind die besonderen Gründe für nicht indexierte E-Commerce-Shops?
Neben den allgemeinen Ursachen gibt es einige Situationen, die speziell den E-Commerce betreffen: nicht vorrätige Produkte, Filter- und Sortieradressen, Einstellungen aus der Staging-Umgebung, entfernte Aktionsseiten und die Crawl-Last, die bei großen Katalogen durch die schiere Seitenzahl entsteht. Jede dieser Situationen muss einzeln bewertet werden.
Nicht vorrätige und ausgelaufene Produkte
Die Seite eines vorübergehend nicht vorrätigen Produkts online zu lassen, ist meist sinnvoll, um das Ranking zu erhalten, wenn der Artikel wieder verfügbar ist; geben Sie den Status auf der Seite klar an und verlinken Sie auf ähnliche Produkte. Für ein dauerhaft entferntes Produkt ist eine 301-Weiterleitung auf ein verwandtes Produkt oder eine Kategorie vorzuziehen. Eine leere, unerklärte Seite „Produkt nicht gefunden“ mit 200-Antwort online zu lassen, sendet der Suchmaschine ein Signal für eine schwache Seite.
Filter-, Sortier- und Parameter-URLs
Ändert sich die URL, wenn auf Kategorieseiten ein Farb-, Größen- oder Preisfilter gewählt wird, entstehen viele ähnliche Seiten. Ein Teil davon darf bewusst nicht indexiert werden; das Problem entsteht, wenn eine Filterseite, die Sie tatsächlich wollen (etwa eine gesuchte Kombination aus Farbe und Produkt), als Duplikat gilt und aussortiert wird. Entscheiden Sie, welche Filterseiten eigenständige Seiten sein sollen, und kennzeichnen Sie den Rest mit einem Canonical, das auf die Hauptkategorie zeigt. Für das Filtererlebnis ist der Leitfaden Optimierung von Produktfilter und Suchleiste hilfreich.
Aus der Staging-Umgebung übrig gebliebene Einstellungen
Ein noindex, das beim Aufbau der Website auf alle Seiten gesetzt wurde, eine pauschale Sperre in der robots.txt oder ein passwortgeschützter Zugang können beim Livegang vergessen werden. Das ist die am leichtesten zu behebende, aber teuerste Ursache für die Klage „Hunderte Seiten werden gar nicht indexiert“. Nehmen Sie robots.txt, das Meta-Robots-Tag des Haupttemplates und die Antwort-Header unbedingt in Ihre Checkliste für den Livegang auf.
Sehr große Kataloge
Bei Websites mit Tausenden Produkten besucht die Suchmaschine nicht jede Seite gleich häufig; Linkstruktur, Sitemap und saubere URLs gewinnen an Bedeutung, damit wichtige Seiten hervortreten. Weniger doppelte und wertlose URLs helfen dabei, dass die Crawling-Zeit auf die wichtigen Seiten entfällt. Zur URL-Struktur lesen Sie den Beitrag Wie sollte die URL-Struktur aussehen.
| Situation | Häufiger Fehler | Der richtige Ansatz |
|---|---|---|
| Vorübergehend nicht vorrätiges Produkt | Seite löschen oder 404 ausgeben | Seite online lassen und den Status angeben |
| Dauerhaft entfernte Produkte | Leere Seite mit 200 online lassen | 301-Weiterleitung auf die passende Seite |
| Filter-URLs | Alle indexieren lassen oder alle sperren | Einige gesuchte Seiten eigenständig machen und den Rest mit einem Canonical kennzeichnen |
| Livegang | Das noindex aus der Staging-Phase zu entfernen vergessen | Eine Checkliste für den Livegang verwenden |
| Neue Kampagnenseite | Von nirgends verlinken | Im Menü und auf der Startseite verlinken |
Wie lange muss man nach der Behebung des Problems warten?
Nach einer Korrektur lässt sich keine feste Zeit für das erneute Crawlen und Indexieren der Seite nennen; sie hängt von der Größe der Website, der Verlinkung der Seite und der Aufmerksamkeit ab, die die Suchmaschine der Website widmet. Manche Seiten werden schnell neu bewertet, andere deutlich später.
Wegen dieser Unsicherheit passieren zwei Fehler: Entweder wartet man endlos und tut nichts, oder man stellt jeden Tag erneut eine Anfrage für dieselbe Seite. Der richtige Ansatz liegt dazwischen:
- Prüfen Sie, ob die Korrektur tatsächlich umgesetzt wurde. Öffnen Sie die Seite erneut und kontrollieren Sie Code und Antwort-Header; möglicherweise wird eine alte Version aus dem Cache geliefert.
- Beantragen Sie ein erneutes Crawlen der Seite. Über die URL-Prüfung im Tool für Websitebetreiber können Sie eine Indexierungsanfrage senden; das ist ein Beschleunigungsversuch, keine Garantie. Wiederholte Anfragen für dieselbe Seite bringen nichts.
- Stärken Sie die Auffindbarkeit. Halten Sie die Seite in der Sitemap aktuell und ergänzen Sie interne Links; die Suchmaschine soll auch andere Wege zur Seite erkennen.
- Warten Sie eine Weile und prüfen Sie erneut. Verfolgen Sie den Statusbericht des Tools in regelmäßigen Abständen; achten Sie darauf, ob der Status von „nicht gecrawlt“ über „gecrawlt“ zu „indexiert“ übergeht.
- Ändert sich weiterhin nichts, kehren Sie zur Diagnose zurück. Vermutlich ist entweder die Korrektur unvollständig, oder die eigentliche Ursache liegt im Wert des Inhalts.
Wurde ein schwerwiegendes Problem behoben (zum Beispiel ein noindex, das die gesamte Website betrifft), kann die Erholung länger dauern als bei einzelnen Seiten, weil die Suchmaschine den Großteil der Website neu crawlen muss. Ändern Sie in dieser Zeit nicht ständig Seiten und Sitemap; jede Änderung kann die Bewertung neu starten.
Wie werden neue Produktseiten schneller gefunden?
Drei Dinge wirken für die schnelle Entdeckung neuer Produktseiten zusammen: die interne Verlinkung der Seite mit ihrer Kategorie und verwandten Produkten, die automatische Aufnahme der neuen Seite in die Sitemap und die Veröffentlichung der Seite von Anfang an als indexierbar (ohne noindex, mit korrektem Canonical und 200-Antwort). Fehlt eines davon, verzögert sich die Entdeckung.
- Führen Sie vor der Veröffentlichung eine technische Prüfung durch. Ist die URL sauber, fehlt ein noindex, verweist das Canonical auf sich selbst, lässt sich die Seite mobil problemlos öffnen?
- Ordnen Sie das Produkt der richtigen Kategorie zu. Die Kategorieseite ist der stärkste Weg, damit ein neues Produkt gefunden wird; erscheint das Produkt in der Kategorie und auf den ersten Seiten, erreicht die Suchmaschine es leicht.
- Verlinken Sie von der Startseite und von verwandten Seiten. Ein Bereich „Neuheiten“, verwandte Produkte und natürliche Links in Blogbeiträgen rücken die Seite näher ins Zentrum der Website.
- Stellen Sie sicher, dass die Sitemap aktuell ist. Falls es eine Wartezeit gibt, bis das neue Produkt in die Sitemap aufgenommen wird, planen Sie diese ein.
- Starten Sie mit reichhaltigem und originellem Inhalt. Eine Seite, die mit leerer Beschreibung veröffentlicht wird, nach dem Motto „fülle ich später aus“, kann beim ersten Crawl als dünner Inhalt gewertet werden. Veröffentlichen Sie die Seite, wenn sie fertig ist.
- Senden Sie bei Bedarf eine Crawling-Anfrage. Für ein wichtiges Produkt oder eine wichtige Kampagne lassen sich im Tool für Websitebetreiber einzelne Anfragen senden; setzen Sie das selektiv ein.
- Vergessen Sie Teilen und externe Links nicht. Social-Media-Beiträge und Newsletter verbessern das Ranking nicht direkt, bringen der Seite aber echte Besucher und manchmal Links.
Wichtig ist auch, dass die Seite beim Teilen korrekt dargestellt wird; werfen Sie dazu einen Blick in den Leitfaden Was ist ein Open-Graph-Tag. Bei mehrsprachigen Websites muss das Hreflang-Tag für die Verbindung zwischen den Sprachversionen korrekt eingerichtet sein, sonst können die Versionen als Kopien voneinander gelten.
LesempfehlungWas ist eine Sitemap? So erstellen Sie sie für einen E-Commerce-ShopWelche Fehler werden bei Indexierungsproblemen häufig gemacht?
Die häufigsten Fehler sind: dieselbe Anfrage immer wieder zu senden, ohne die Ursache zu diagnostizieren, robots.txt mit noindex zu verwechseln, Staging-Einstellungen im Livebetrieb zu belassen, jede URL in die Sitemap zu packen und die Seitenzahl zu erhöhen, statt Inhalte aufzuwerten. Gemeinsam ist ihnen, dass man sich mit dem Symptom beschäftigt, statt die Ursache zu betrachten.
- Für dieselbe Seite ständig erneut Anfragen senden. Solange das Problem nicht behoben ist, nützen Anfragen nichts; finden Sie zuerst die Ursache.
- Eine Seite, die nicht indexiert werden soll, per robots.txt zu sperren und die Sache für erledigt zu halten. Das verhindert das Crawling; erhält die Seite externe Links, kann sie dennoch in den Ergebnissen erscheinen. Damit sie nicht aufgelistet wird, ist noindex die bessere Wahl.
- Seiten mit noindex in die Sitemap aufzunehmen. Sitemap und Seite sagen Gegensätzliches, was das Vertrauen untergräbt.
- Über die Seitenzahl wachsen zu wollen. Hunderte wenig wertvolle Seiten verursachen mehr Probleme als zehn wertvolle. Verbessern Sie zuerst die bestehenden Seiten.
- Das Canonical automatisch laufen zu lassen und nie zu prüfen. Template-Fehler betreffen alle Seiten gleichzeitig.
- Weiterleitungsketten aufzubauen. Leiten Sie bei jedem Umzug die alte URL direkt auf das endgültige Ziel weiter.
- Von einer neuen Website sofort Ergebnisse zu erwarten. Der Prozess braucht Zeit; das ist aber keine Ausrede, technische Prüfungen zu überspringen.
- Mehrsprachige Seiten als Kopien voneinander zu belassen. Sprachversionen müssen übersetzt und korrekt ausgezeichnet sein.
Indexierungs-Checkliste
Eine indexierungsbereite Seite ist eine Seite, deren URL sich öffnen lässt, die weder für den Crawler noch für die Aufnahme in den Index Hindernisse trägt, deren Canonical auf sie selbst zeigt, die originellen und ausreichenden Inhalt hat, von innerhalb der Website verlinkt wird und in der Sitemap steht. Nutzen Sie die folgende Liste, wenn Sie eine neue Seite veröffentlichen oder eine nicht indexierte Seite untersuchen.
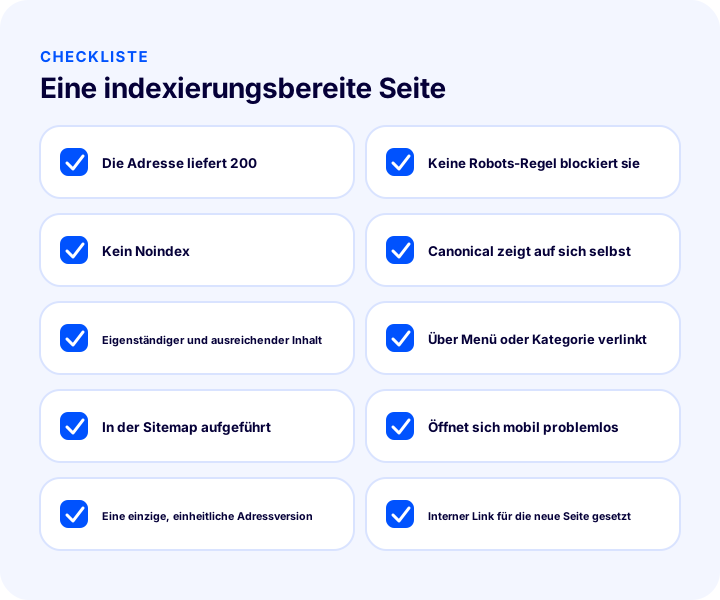
- Die URL liefert eine 200-Antwort, ohne Weiterleitung oder Fehler.
- Keine Robots-Regel sperrt den Pfad der Seite.
- Weder im Seitencode noch im Antwort-Header steht ein noindex.
- Das Canonical-Tag zeigt auf die eigene URL der Seite.
- Der Inhalt ist originell und ausreichend: Beschreibung, Bilder, Größen- und Pflegehinweise, Kundenfragen.
- Die Seite ist vom Menü, von einer Kategorie oder von verwandten Inhalten aus verlinkt.
- Die Seite ist in der aktuellen Sitemap aufgeführt.
- Die Seite öffnet sich mobil problemlos und schnell.
- Die URL-Variante (www, http/https, Schrägstrich am Ende) ist einheitlich und konsistent.
- Interne Links für die neue Seite wurden zum Zeitpunkt der Veröffentlichung gesetzt.
| Wann? | Was zu tun ist |
|---|---|
| Vor der Veröffentlichung | Prüfen Sie URL, noindex, Canonical, Inhalt und Kategoriezuordnung |
| Bei der Veröffentlichung | Setzen Sie interne Links und stellen Sie sicher, dass die Sitemap aktuell ist |
| Nach der Veröffentlichung | Verfolgen Sie den Status der Seite im Tool für Websitebetreiber |
| Bei einem Problem | Folgen Sie der Reihenfolge der Diagnosetabelle, prüfen Sie die Korrektur, warten Sie |
| Regelmäßig | Überprüfen Sie robots.txt, Template-Meta-Tags und Weiterleitungen |
Indexierungsprobleme mit Faprika managen
Die SEO-Einstellungen im Faprika-Kontrollpanel bündeln mehrere für die Indexierbarkeit wichtige Punkte. Laut der Anleitung zu den SEO-Einstellungen im Hilfecenter finden Sie unter Konfiguration, Einstellungen, Allgemeine Einstellungen im Bereich SEO die Option „Canonical Url Aktif“ (Canonical-URL aktiv); diese Einstellung hilft dabei, eindeutige und originäre Seiten-URLs festzulegen. Im selben Bereich wird mit „Alan Adı Kontrolü“ (Domain-Prüfung) auch der konsistente Zugriff auf die Varianten mit und ohne www behandelt. Diese beiden Einstellungen sind Ausgangspunkte, um die oben beschriebenen Canonical- und URL-Varianten-Probleme zu verringern.
Im Funktionsvergleich der Pakete finden sich Zeilen wie „Canonical / H Etiket Yönetimi / Robots / Sitemap“ (Canonical-/Überschriften-Tag-Verwaltung/Robots/Sitemap), „301 / 302 / 410 Paneli / URL Kayıtlarını Yönetme“ (301-/302-/410-Panel/Verwaltung von URL-Einträgen), „Toplu Otomatik SEO/Meta Bilgi Güncelleme“ (automatische Massenaktualisierung von SEO-/Meta-Angaben) und „SEO Raporları“ (SEO-Berichte). Diese Zeilen betreffen die Verwaltung von robots.txt und Sitemap, Weiterleitungseinträge, die Massenaktualisierung von Produkttiteln und -beschreibungen sowie SEO-Berichte; welches Paket was enthält, kann je nach Paket variieren, den aktuellen Umfang finden Sie auf der Seite E-Commerce-Pakete.
Die SEO-Angaben der Produktseiten werden pro Produkt im Bereich Katalog, Produktverwaltung bearbeitet. Dieselbe Anleitung beschreibt das Erzeugen von SEO-Angaben mit Platzhaltern wie Produktname, Artikelnummer und Preis sowie die Option, Produkt-Meta-Beschreibungen automatisch zu erstellen. Diese Werkzeuge sparen Zeit; wendet man jedoch dieselbe Vorlage auf jedes Produkt an, können ähnliche Titel und Beschreibungen entstehen. Für Ihre wichtigsten Produkte liefert das manuelle Schreiben von Titel und Beschreibung originellere Ergebnisse. Zum Verfassen von Meta-Beschreibungen hilft der Leitfaden Wie schreibt man eine Meta-Beschreibung, für die gemeinsame Einrichtung der shopweiten Einstellungen der Beitrag E-Commerce-SEO-Einstellungen: So gehen Sie vor. Sehen Sie sich außerdem den Beitrag Was sind strukturierte Daten an, um Ihre Seiten der Suchmaschine strukturiert zu beschreiben.
Häufig gestellte Fragen
Warum wird eine Seite nicht indexiert?
Eine Seite wird möglicherweise nicht indexiert, weil die Suchmaschine sie nicht erreichen kann (Robots-Sperre, Fehler, Weiterleitung), weil sie ein Signal trägt, nicht in die Liste aufgenommen zu werden (Noindex, ein Canonical auf eine andere Seite), oder weil sie nicht eigenständig und wertvoll genug für die Aufnahme erscheint (dünner oder doppelter Inhalt, eine unverlinkte Seite, eine neue Website). Die Ursache sollte in der Reihenfolge der Diagnosetabelle ausgeschlossen werden.
Was ist der Unterschied zwischen Crawling und Indexierung?
Crawling bedeutet, dass die Suchmaschine eine Seite findet und liest. Indexierung bedeutet, dass die gelesene Seite in die Liste der Suchmaschine aufgenommen wird. Eine Seite kann gecrawlt sein und dennoch nicht in die Liste kommen; Ranking wiederum ist die Reihenfolge, in der eine Seite aus der Liste bei einer Suchanfrage angezeigt wird.
Was ist der Unterschied zwischen Noindex und einer robots.txt-Sperre?
Robots.txt verhindert, dass der Crawler die Seite betritt; Noindex teilt der Suchmaschine mit, die Seite nach dem Lesen nicht in die Liste aufzunehmen. Wenn eine Seite nicht in der Liste erscheinen soll, ist Noindex das richtige Werkzeug. Da eine per robots.txt gesperrte Seite nicht gecrawlt wird, wird auch das Noindex-Tag nicht gelesen.
Wie lange dauert es nach der Korrektur, bis eine Seite indexiert wird?
Eine genaue Zeitangabe ist nicht möglich; sie hängt von der Größe der Website, der Verlinkung der Seite und dem Interesse der Suchmaschine ab. Überprüfen Sie die Korrektur, senden Sie eine Anfrage zum erneuten Crawlen, stärken Sie die Auffindbarkeit durch interne Links und die Sitemap und beobachten Sie den Status nach einiger Zeit.
Wie werden meine neuen Produktseiten schneller indexiert?
Ordnen Sie das Produkt der richtigen Kategorie zu, verlinken Sie es von der Startseite und von verwandten Seiten, stellen Sie sicher, dass die Sitemap aktuell ist, veröffentlichen Sie die Seite ohne Noindex und mit einem auf sich selbst zeigenden Canonical und schreiben Sie die Beschreibung von Anfang an eigenständig. Für wichtige Produkte können Sie zusätzlich über das Webmaster-Tool eine Crawling-Anfrage senden.
Was bedeutet eine Seite, die gecrawlt, aber nicht indexiert wurde?
Es bedeutet, dass die Suchmaschine die Seite gelesen, sie aber nicht für aufnahmewürdig befunden hat. Meist liegt es daran, dass der Inhalt dünn ist, anderen Seiten stark ähnelt oder keinen unterscheidenden Wert bietet. Die Lösung besteht darin, der Seite eigenständige, nützliche Inhalte hinzuzufügen und sie von innerhalb der Website besser zu verlinken.