
İçindekiler 14 bölüm
- Robots.txt Nedir?
- Tarayıcı (Bot) Nedir ve Robots.txt ile İlişkisi Nasıldır?
- Robots.txt Dosyası Nerede Durur ve Nasıl Oluşturulur?
- Robots.txt Satırları Ne Anlama Gelir?
- Robots.txt ile Noindex Arasındaki Fark Nedir?
- E-Ticaret Sitesinde Robots.txt ile Nelerin Engellenmesi Gerekir?
- Robots.txt ile Asla Engellenmemesi Gerekenler Nelerdir?
- Örnek Bir E-Ticaret Robots.txt Dosyası Nasıl Görünür?
- Robots.txt’de Sık Yapılan Hatalar Nelerdir?
- Yapay Zekâ Tarayıcıları Robots.txt ile Nasıl Yönetilir?
- Robots.txt Nasıl Test Edilir ve İzlenir?
- Robots.txt ve Teknik SEO Birlikte Nasıl Çalışır?
- Faprika ile Robots ve Tarama Yönetimi
- Sıkça Sorulan Sorular
Bir mağazanın vitrini herkese açıktır, ama deposuna, kasa arkasına ve yönetim odasına herkes giremez. Web sitenizde de benzer bir düzen vardır: ürün ve kategori sayfaları ziyaretçiye ve arama motorlarına açıkken sepet, ödeme adımları, yönetim alanı ve sonsuz sayıda filtre adresi herkesin görmesi gereken yerler değildir. Arama motorlarının otomatik gezginlerine (tarayıcılara, yani botlara) bu sınırları anlatan küçük bir metin dosyası vardır: robots.txt.
Bu rehberde robots.txt nedir sorusunu sade bir dille cevaplıyoruz: dosyanın ne olduğu, nerede durduğu, User-agent, Disallow, Allow ve Sitemap satırlarının nasıl yazıldığı, noindex ile farkı, e-ticaret sitesinde nelerin engellenmesi ve nelerin asla engellenmemesi gerektiği, yapay zekâ tarayıcılarının nasıl yönetildiği, sık yapılan hatalar ve test yöntemleri. Sonda Faprika ile robots yönetimini ve altı soruluk bir SSS bulacaksınız.
Robots.txt Nedir?
Robots.txt, sitenizin kök dizininde duran ve arama motoru tarayıcılarına hangi adreslere girebileceklerini, hangilerine girmemeleri gerektiğini bildiren düz metin dosyasıdır. “Robot Dışlama Protokolü” olarak da anılan bu uygulama, internetin ilk yıllarından beri kullanılan ortak bir kuraldır.
Dosya bir emir değil, bir istektir. Arama motorlarının büyük çoğunluğu bu isteğe uyar, ama dosyanın kendisi kimseyi zorlamaz. Kötü niyetli botlar dosyayı hiç okumayabilir; bu yüzden robots.txt bir güvenlik önlemi sayılmaz. Gizli kalması gereken bir alan için parola, yetkilendirme ve sunucu ayarları gerekir; robots.txt ise yalnızca dürüst tarayıcılarla yapılan bir anlaşmadır.
Dosya .txt uzantılı sade bir metindir; özel bir yazılım gerekmez. Bir not defteriyle yazılabilir, ama adı ve yeri tam olmalıdır: dosyanın adı küçük harflerle robots.txt ve konumu sitenin kök dizinidir. En yalın hali şudur:
User-agent: *
Disallow:

Sitemap: https://magazaadresiniz/sitemap.xml
Bu iki satırlık dosya, “tüm tarayıcılar her yere girebilir, harita adresim de şu” demektir. Boş bırakılmış Disallow satırı hiçbir şeyi engellemez.
Tarayıcı (Bot) Nedir ve Robots.txt ile İlişkisi Nasıldır?
Tarayıcı, bot ya da örümcek; web sayfalarını otomatik olarak ziyaret edip içeriği okuyan, bağlantıları izleyerek yeni sayfalar bulan yazılımdır. Arama motorları bu yazılımlarla sitenizi keşfeder ve dizinlerine ekler.
Tarayıcı bir siteye geldiğinde önce kök dizindeki robots.txt dosyasına bakar. Dosyada kendisi için bir kural varsa onu uygular, sonra gezmeye başlar. Dosya yoksa (404 dönerse) her yere girmesine izin verildiğini varsayar. Her tarayıcının kendine ait bir adı vardır ve dosyada bu ada seslenebilirsiniz; bu ada “user-agent” denir.
Tarayıcıların bir sitede harcayacağı zaman ve kaynak sınırlıdır. Buna sektörde tarama bütçesi denir. Büyük bir e-ticaret sitesinde filtre kombinasyonları, sıralama parametreleri ve site içi arama sayfaları yüz binlerce adres üretebilir; tarayıcı bu adreslere zaman harcarsa yeni ürünleriniz ve önemli kategorileriniz geç keşfedilebilir. Robots.txt, bu kaynağı değerli sayfalara yönlendirmenin ilk ve en ucuz yoludur.
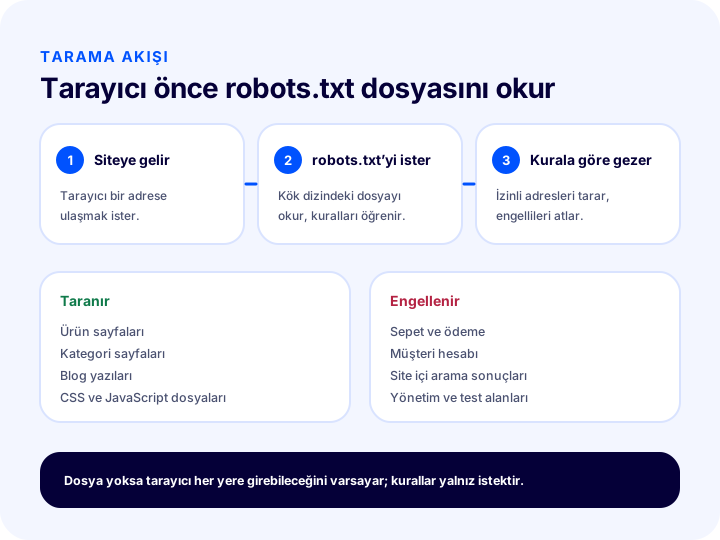
Çizim akışı özetler: tarayıcı siteye gelir, robots.txt dosyasını ister, kuralları okur ve izin verilen adresleri tarar; engellenen adreslere girmez. Aynı sıra metin olarak da şöyledir: önce dosya, sonra kural, sonra tarama.
Robots.txt Dosyası Nerede Durur ve Nasıl Oluşturulur?
Robots.txt, her alan adının (ve alt alan adının) kök dizininde, /robots.txt adresinde bulunmalıdır. Başka bir klasörde duran dosya tarayıcılar tarafından aranmaz.
Bunun pratik sonuçları vardır:
- Tek kök, tek dosya. Mağazanızın ana alan adı için
magazaadresiniz/robots.txtadresi geçerlidir. Bir alt alan adınız (örneğin blog için) varsa onun kendi robots.txt dosyası olmalıdır; ana alan adındaki dosya alt alan adını bağlamaz. - Protokol ve alan adı sürümü önemlidir. http ve https, www’lu ve www’suz adresler teknik olarak ayrı adreslerdir. Tek sürüme yönlendirme yapılmışsa kural o sürümün dosyasında olmalıdır.
- Dosya adı küçük harfle yazılır.
Robots.txtya darobots.TXTbiçimleri güvenilir değildir. - Dosya sade metin olmalıdır. HTML, görsel ya da biçimli belge değil; düz metin, tercihen UTF-8 kodlamasıyla.
- Dosya 200 durum koduyla açılmalıdır. Dosya hata verirse tarayıcı ne yapacağını bilemez; bu da tarama davranışını öngörülemez kılar.
Oluşturmak için iki yol vardır: dosyayı elle yazıp kök dizine koymak ya da e-ticaret altyapınızın sunduğu robots ayarını kullanmak. Hazır altyapılarda dosya çoğu zaman panelden yönetilir; bu durumda dosyayı elle yüklemenize gerek kalmaz. Aşağıdaki bölümlerde dosyanın içeriğini adım adım kuracağız.
Robots.txt Satırları Ne Anlama Gelir?
Robots.txt dört temel satırdan oluşur: User-agent kuralın kime ait olduğunu, Disallow neyin engellendiğini, Allow engelin içindeki istisnayı, Sitemap ise site haritasının adresini belirtir. Satırlar gruplar halinde yazılır ve her grup bir User-agent satırıyla başlar.
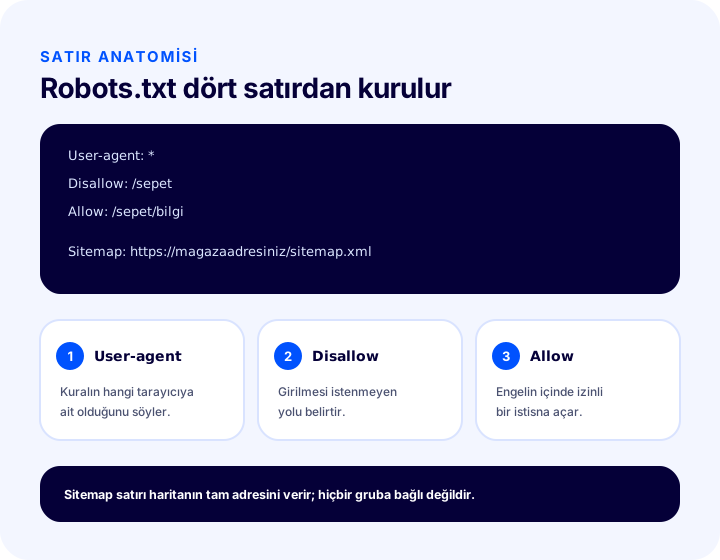
| Satır | Ne söyler? | Örnek |
|---|---|---|
| User-agent | Kuralın hangi tarayıcıya ait olduğu; yıldız (*) tümü demektir | User-agent: * |
| Disallow | Girilmesi istenmeyen yol | Disallow: /sepet |
| Allow | Engellenen bir alanın içinde izin verilen yol | Allow: /sepet/bilgi |
| Sitemap | Site haritasının tam adresi | Sitemap: https://magazaadresiniz/sitemap.xml |
1. User-agent
User-agent, kuralın kime ait olduğunu söyler. Yıldız işareti (*) tüm tarayıcıları kapsar. Belirli bir tarayıcı için ayrı kural yazmak isterseniz onun adını yazarsınız; o tarayıcı hem kendi grubuna hem de yıldızlı gruba bakar, ama kendine özel grup varsa çoğunlukla yalnız onu uygular. Bu yüzden belirli bir tarayıcıya ayrı grup açarken genel kuralları o gruba da yazmanız gerekebilir.
2. Disallow
Disallow, engellenen yolu belirtir. Yol eğik çizgiyle başlar ve o yolla başlayan tüm adresleri kapsar. Disallow: /sepet yazarsanız /sepet ile başlayan her adres (örneğin /sepet/odeme) engellenir. Satırı boş bırakmak “hiçbir şeyi engelleme” demektir.
3. Allow
Allow, geniş bir engelin içinde küçük bir istisna açmak için kullanılır. Örneğin bir klasörü engelleyip içindeki tek bir alt klasöre izin verebilirsiniz. Birden çok kural aynı adresi kapsıyorsa genellikle daha belirgin (daha uzun) yol kazanır.
4. Sitemap
Sitemap satırı, site haritanızın tam adresini verir. Dosyanın herhangi bir yerinde bulunabilir ve hiçbir User-agent grubuna bağlı değildir. Tarayıcı robots.txt’yi okurken haritanızın adresini de öğrenir. Site haritasının nasıl hazırlanacağı site haritası nedir rehberinde anlatılmıştır.
5. Joker karakterler ve satır sonu işareti
Yıldız (*) yol içinde “herhangi bir karakter dizisi” anlamına gelir; dolar işareti ($) adresin tam burada bittiğini söyler. İkisi de büyük tarayıcılar tarafından desteklenir, ama her tarayıcının desteği aynı olmayabilir; kritik kuralları önce küçük bir testle doğrulayın.
User-agent: *
Disallow: /*?sirala=
Disallow: /*.pdf$
Birinci kural, adresinde ?sirala= geçen her adresi engeller; ikinci kural, tam olarak .pdf ile biten adresleri kapatır. Büyük küçük harf duyarlılığına dikkat edin: yollar genellikle büyük küçük harfe duyarlıdır, yönerge adları (User-agent, Disallow) ise değildir.
Dosyaya yorum satırı da yazılabilir: # ile başlayan satırlar tarayıcılar tarafından yok sayılır. Birkaç ay sonra bakıldığında neden bu kuralı koyduğunuzu hatırlamak için kısa notlar bırakmak iyi bir alışkanlıktır.
Robots.txt ile Noindex Arasındaki Fark Nedir?
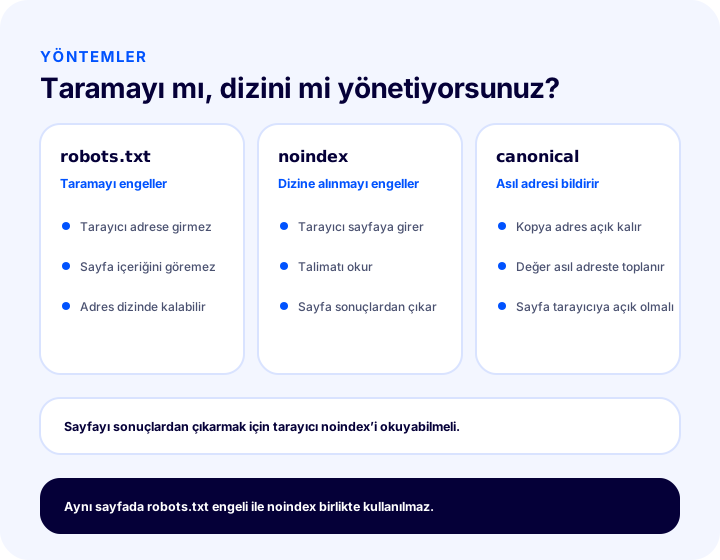
Robots.txt tarayıcının bir adrese girmesini engeller; noindex ise sayfanın arama sonuçlarında yer almamasını ister. Robots.txt ile engellenen bir sayfa, başka sitelerden bağlantı alıyorsa yine de dizinde adresiyle görünebilir; çünkü tarayıcı sayfaya girmediği için içeriği ve noindex talimatını göremez.
Bu, en sık yapılan yanlış anlamadır: robots.txt bir sayfayı dizinden çıkarmaz. Bir sayfanın arama sonuçlarından kalkmasını istiyorsanız tarayıcının sayfaya girip noindex yönergesini okuması gerekir; bu da robots.txt’de o sayfayı engellememeniz demektir.
| Özellik | Robots.txt | Noindex |
|---|---|---|
| Nerede tanımlanır? | Kök dizindeki robots.txt dosyasında | Sayfanın meta etiketinde ya da sunucu cevabının başlığında |
| Neyi yönetir? | Taramayı (tarayıcı sayfaya girer mi?) | Dizine alınmayı (sayfa sonuçlarda çıkar mı?) |
| Sayfa sonuçlarda görünür mü? | Başka sitelerden bağlantı varsa adres olarak görünebilir | Görünmez, tarayıcı talimatı okuyabilirse |
| Tarayıcı sayfaya girer mi? | Girmez | Girer, talimatı okur |
| Tipik kullanım | Tarama kaynağını korumak, sonsuz adres alanlarını kapatmak | Sonuçlarda görünmesi istenmeyen sayfalar |
| Birlikte kullanılabilir mi? | Aynı sayfada noindex ile çelişir | Aynı sayfayı robots.txt ile engellemeyin |
Karar çerçevesi şöyledir: tarama kaynağını boşa harcayan, hiçbir zaman sonuçlarda olması gerekmeyen alanları (sonsuz filtre kombinasyonları gibi) robots.txt ile kapatın. Sayfanın kendisi sonuçlarda görünmemeli ama tarayıcı onu okuyabilmeli ise noindex kullanın. Aynı içeriğin birden çok adresi varsa asıl adresi canonical etiketiyle bildirin; bu farkın ayrıntısı için canonical etiketi nedir yazısına bakabilirsiniz.
E-Ticaret Sitesinde Robots.txt ile Nelerin Engellenmesi Gerekir?
E-ticaret sitesinde robots.txt ile genellikle sepet ve ödeme adımları, müşteri hesabı sayfaları, site içi arama sonuçları, filtre ve sıralama parametreli adresler ile yönetim alanları engellenir. Ortak nokta, bu adreslerin arama sonuçlarında karşılığı olmaması ve tarama kaynağını boşa harcamasıdır.
1. Sepet ve ödeme adımları
Sepet ve ödeme sayfaları kişiye özeldir; her ziyaretçide farklı içerik gösterir ve arama sonuçlarında yer almasının bir anlamı yoktur. Tarayıcının bu adreslere girmesi gereksizdir. Ödeme sayfalarının güvenliği için SSL sertifikası gibi önlemler ayrı bir konudur; robots.txt bu sayfaları korumaz, yalnız tarayıcıdan uzak tutmayı ister.
2. Müşteri hesabı ve giriş sayfaları
Üye girişi, siparişlerim, adres defteri ve şifre yenileme sayfaları da aynı nedenle kapatılır. Bu sayfalarda aranabilir bir içerik yoktur; ayrıca oturum açmış kullanıcıya özel bilgiler taşıdıkları için tarayıcının bunlarla uğraşması anlamsızdır.
3. Site içi arama sonuçları
Müşterinin arama kutusuna yazdığı her sorgu yeni bir adres üretir. Bu adreslerin sayısı sınırsızdır ve kalıcı bir içerik değeri taşımaz. Robots.txt ile bu alanı kapatmak, tarayıcının sonsuz bir adres havuzunda dolaşmasını önler.
4. Filtre ve sıralama parametreleri
Renk, beden, fiyat aralığı ve sıralama seçimleri adrese parametre ekler. Birkaç filtrenin birleşimi yüz binlerce adres çıkarabilir. Çoğu aynı ürünleri farklı dizilişle gösterdiği için ayrı bir arama değeri taşımaz. Hepsini kapatmak yerine, hangi filtre sayfalarının gerçekten aranan bir giriş sayfası olduğuna karar verin; aranan bir filtre sayfasını (ör. belirli bir renk ve kategori birleşimi) taramaya açık tutun. Filtre tasarımının kullanıcı tarafı için ürün filtreleme ve arama çubuğu optimizasyonu rehberine bakabilirsiniz.
5. Yönetim alanları ve geçici sayfalar
Yönetim paneli, test ve önizleme sayfaları, yedekler ve iç kullanım dosyaları arama sonuçlarında olmamalıdır. Hatırlatma: robots.txt dosyası herkese açıktır; engellediğiniz yolları da herkes görebilir. Bu nedenle gerçekten gizli olan bir alanın adını robots.txt’ye yazmak, onu ilan etmek anlamına gelir. Gizlilik için erişim denetimi şarttır.
6. Sonsuz takvim, oturum ve izleme adresleri
Oturum numarası taşıyan ya da kampanya izleme parametresi eklenen adresler sayfanın kopyalarını üretir. Bunları robots.txt yerine çoğunlukla canonical ile yönetmek daha doğrudur; engellerseniz tarayıcı sayfaya girip asıl adresi okuyamaz.
| Alan | Robots.txt ile engellensin mi? | Neden? |
|---|---|---|
| Sepet ve ödeme | Evet | Kişiye özel, aranma değeri yok |
| Müşteri hesabı ve giriş | Evet | Kişisel içerik, tarama gereksiz |
| Site içi arama sonuçları | Evet | Sonsuz adres, kalıcı değer yok |
| Rastgele filtre ve sıralama | Genellikle evet | Aynı ürünler, çok sayıda adres |
| Aranan özel filtre sayfası | Hayır | Gerçek bir giriş sayfası olabilir |
| Yönetim ve test alanları | Evet, ek olarak erişim denetimi | Dizinde olmaması gerekir |
| İzleme parametreli adresler | Çoğunlukla hayır, canonical ile | Tarayıcı asıl adresi okuyabilmeli |
Robots.txt ile Asla Engellenmemesi Gerekenler Nelerdir?
Ürün sayfaları, kategori sayfaları, blog yazıları ve sayfaların görünümünü oluşturan stil (CSS) ile betik (JavaScript) dosyaları robots.txt ile engellenmemelidir. Bunlar engellendiğinde arama motoru sayfayı ya hiç görmez ya da bozuk görür.
- Ürün ve kategori sayfaları. Mağazanızın gelir getiren sayfalarıdır; engel, doğrudan görünürlük kaybıdır.
- Blog ve bilgi sayfaları. Arama trafiğinin önemli bir kaynağıdır.
- CSS ve JavaScript dosyaları. Arama motorları sayfayı ziyaretçinin gördüğü gibi çizebilmek ister. Stil ve betik dosyaları kapatılırsa sayfa bozuk ya da boş görünebilir; mobil uyumluluk ve sayfa deneyimi değerlendirmesi de bundan etkilenir.
- Görseller. Ürün görsellerini taramaya kapatmak, görsel aramadaki görünürlüğü ortadan kaldırır.
- Site haritası. Haritanın kendisi ve içindeki adresler engellenmemelidir.
- Yönlendirilen eski adresler. Tarayıcı, 301 yönlendirmeyi görmek için eski adrese girebilmelidir. Eski adresi engellerseniz yönlendirmenin değer aktarımı çalışmaz; bu konunun ayrıntısı 301 yönlendirme nedir yazısındadır.
- Yapılandırılmış veri içeren sayfalar. Ürün ve değerlendirme gibi zengin sonuç işaretlemeleri ancak sayfa taranabilirse okunur; ayrıntı için yapılandırılmış veri nedir rehberine bakın.
Örnek Bir E-Ticaret Robots.txt Dosyası Nasıl Görünür?
Aşağıdaki dosya, orta ölçekli bir e-ticaret sitesi için sade bir örnektir: sepet, hesap, arama ve parametreli adresleri kapatır, haritayı bildirir. Adresler bu mağazaya göre değişir; kendi sitenizin gerçek yollarına uyarlayın.
# Tüm tarayıcılar için genel kurallar
User-agent: *
Disallow: /sepet
Disallow: /odeme
Disallow: /hesabim
Disallow: /giris
Disallow: /arama
Disallow: /*?sirala=
Disallow: /*?oturum=

Sitemap: https://magazaadresiniz/sitemap.xml
Dosyanın mantığı şudur: ilk yorum satırı dosyanın amacını belirtir; User-agent: * tüm tarayıcıları seçer; sonraki satırlar kişiye özel alanları, site içi aramayı ve sıralama ile oturum parametreli adresleri kapatır; en alttaki satır haritanın yerini gösterir. CSS, JavaScript, ürün ve kategori adresleri hiçbir satırla kapatılmamıştır.
Allow ile istisna açma örneği
Bir klasörü kapatıp içindeki tek bir alt yola izin vermek istediğinizde Allow kullanılır:
User-agent: *
Disallow: /hesabim
Allow: /hesabim/yardim
Bu örnekte hesap alanı kapalıdır; yalnızca herkese açık yardım sayfası taranabilir. Böyle istisnalar kuralları karmaşıklaştırdığı için yalnız gerçekten gerektiğinde kullanın.
Bir yanlışın bedeli: tek satırlık fark
İki kural birbirine çok benzer, ama sonuçları taban tabana zıttır:
Disallow:    # hiçbir şeyi engellemez
Disallow: /  # tüm siteyi engeller
Birincisinde eğik çizgi yoktur ve tüm site taranabilir. İkincisinde tek bir eğik çizgi, sitenin tamamını tarayıcılara kapatır. Bu fark, bir sonraki bölümün konusudur.
Robots.txt’de Sık Yapılan Hatalar Nelerdir?
Robots.txt hatalarının çoğu küçük yazım ayrıntılarından çıkar, ama sonuçları büyüktür. Kural dosyası tek bir yerden herkesin sitesini etkilediği için her değişiklik dikkatle yapılmalıdır. En sık karşılaşılanlar şunlardır.
- Tüm siteyi yanlışlıkla engellemek.
Disallow: /satırı tüm siteyi kapatır. Çoğu zaman yayına geçmeden önce test sitesi için konulmuş bu kural, canlı siteye taşınırken unutulur ve mağaza arama sonuçlarından kaybolmaya başlar. Yayın öncesi ve sonrası kontrol listesine mutlaka girmelidir. - CSS ve JavaScript dosyalarını engellemek. Bir zamanlar yaygın olan bu alışkanlık, bugün sayfanın bozuk görünmesine ve sayfa deneyimi değerlendirmesinde sorun çıkmasına yol açar.
- Robots.txt’yi dizinden çıkarma aracı sanmak. Engellenen sayfa dizinde adresiyle kalabilir. Sonuçlardan çıkarmak için noindex kullanılır.
- Engellenen sayfayı site haritasında bırakmak. Haritada olan bir adresi robots.txt ile kapatmak tarayıcıya hem “gel” hem “girme” demektir. Çelişkili işaretler, ikisine de güveni azaltır.
- Dosyayı yanlış yere koymak. Kök dizinde olmayan, farklı bir adla kaydedilmiş ya da hata veren dosya okunmaz; tüm kurallar boşa gider.
- Gizli alan adlarını yazmak. Dosya herkese açıktır; yönetim paneli yolunu yazmak yolu duyurmak olur.
- Yazım ve biçim hataları. Eksik iki nokta, yanlış yazılmış yönerge adı, yolun eğik çizgiyle başlamaması kuralı geçersiz kılar. Bazı tarayıcılar hatalı satırı atlar, bazıları tüm grubu yok sayabilir.
- Çok geniş joker kullanmak. Yıldızlı bir kural, farkında olmadan ürün ya da kategori adreslerini de kapsayabilir. Her joker kuralı etkilediği adresler üzerinden test edin.
- Test sitesindeki dosyayı canlıya kopyalamak, ya da tersi. Canlı dosyanın test ortamına taşınması taramayı gereksiz yere açabilir; test dosyasının canlıya geçmesi ise siteyi kapatabilir.
- Değişiklik sonrası kontrol etmemek. Dosya güncellendikten sonra eski sürüm bir süre arama motorunun belleğinde kalabilir; değişikliğin geçerli olduğunu doğrulamadan işi bitmiş saymayın.
Yapay Zekâ Tarayıcıları Robots.txt ile Nasıl Yönetilir?
Yapay zekâ tarayıcıları da arama motorları gibi kendilerini bir user-agent adıyla tanıtır ve çoğu robots.txt kurallarına uyduğunu belirtir. Bu sayede hangi yapay zekâ tarayıcısının sitenize girebileceğine ayrı ayrı karar verebilirsiniz.
Bu konuda iki farklı hedef vardır ve karar iş modelinize bağlıdır:
- Görünür olmak istiyorsanız. Yapay zekâ asistanlarının ürünlerinizden, rehberlerinizden ve markanızdan bahsetmesini istiyorsanız tarayıcılarına izin vermek gerekir. Bu durumda onları engellemeyin; içeriğinizin anlaşılır, düzenli ve alıntılanabilir olması daha önemlidir.
- İçeriğin kullanılmasını sınırlamak istiyorsanız. Belirli bir yapay zekâ tarayıcısının sitenize girmesini istemiyorsanız onun user-agent adı için ayrı bir grup yazarsınız.
# Belirli bir yapay zekâ tarayıcısını tüm siteden uzak tutma
User-agent: ornek-yapay-zeka-botu
Disallow: /

# Diğer tarayıcılar için genel kurallar
User-agent: *
Disallow: /sepet
Disallow: /odeme
Örnekteki ad temsilidir; gerçek tarayıcı adlarını her yapay zekâ hizmetinin kendi yayımladığı belgelerden öğrenmeniz gerekir. Tarayıcıların adı ve davranışı zamanla değişebileceği için bu kuralları ara ara gözden geçirin. Unutmayın: robots.txt bir istektir, yapay zekâ tarayıcılarının hepsi buna uymayabilir; gerçekten korunması gereken içerik için erişim denetimi şarttır.
Robots.txt Nasıl Test Edilir ve İzlenir?
Robots.txt’yi test etmek için dosyayı tarayıcıda açıp içeriğini görmek, önemli adreslerin engellenmediğini doğrulamak ve arama motoru yönetim aracındaki robots raporlarını izlemek gerekir. Test, dosyayı yayına almadan önce ve her değişiklikten sonra tekrarlanmalıdır.
- Dosyayı açın. Tarayıcıya
magazaadresiniz/robots.txtyazın. Düz metin görünmeli ve sayfa hata vermemelidir. - Kuralları okuyun. Hiçbir kuralın istemeden tüm siteyi ya da ürün ve kategori alanını kapatmadığından emin olun.
- Örnek adresleri test edin. Bir ürün sayfası, bir kategori sayfası, bir blog yazısı, bir stil dosyası ve bir betik dosyası adresi seçin; hiçbirinin engellenmediğini doğrulayın. Aynı yöntemle sepet ve arama adreslerinin engellendiğini doğrulayın.
- Arama motoru yönetim aracındaki raporlara bakın. Bu araçlarda robots dosyasının durumu, son okunma zamanı ve engellenen adresler listelenir. “Robots.txt tarafından engellendi” uyarısı, önemli bir sayfa için görünüyorsa kuralı hemen gözden geçirin.
- Haritayla karşılaştırın. Site haritasındaki adreslerden hiçbirinin robots.txt ile engellenmediğini doğrulayın.
- Değişiklik sonrası izleyin. Kural değişiklikleri hemen etkisini göstermeyebilir; birkaç hafta tarama istatistiklerini ve dizin durumunu izleyin.
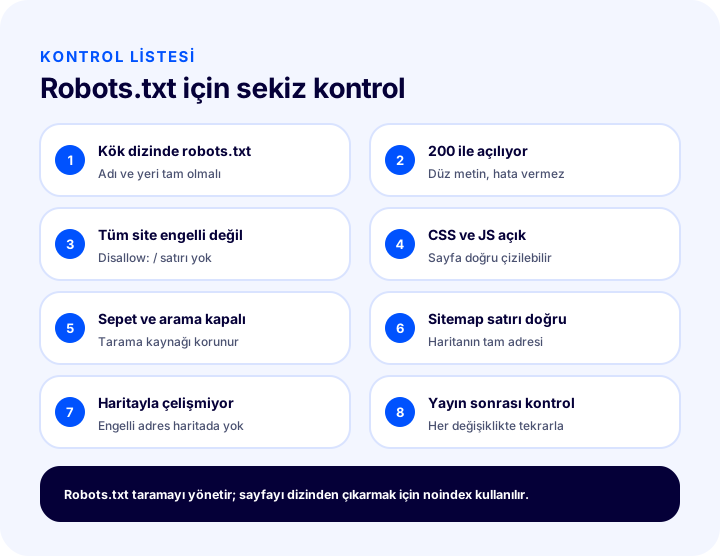
Çizimdeki sekiz madde aşağıda da liste olarak yer alır; ayrıntılı bir kontrol sırasında elinizin altında olması için:
| # | Kontrol | Yanlışsa ne olur? |
|---|---|---|
| 1 | Dosya kök dizinde, adı robots.txt | Tarayıcılar dosyayı hiç bulamaz |
| 2 | Dosya 200 ile açılıyor, düz metin | Tarama davranışı öngörülemez olur |
| 3 | Tüm siteyi engelleyen satır yok | Mağaza arama sonuçlarından kaybolur |
| 4 | CSS, JavaScript ve görseller açık | Sayfa bozuk ya da boş görünür |
| 5 | Sepet, hesap ve arama kapalı | Tarama kaynağı boşa harcanır |
| 6 | Sitemap satırı doğru adresi gösteriyor | Harita keşfi zorlaşır |
| 7 | Engellenen adres haritada ve noindex’te yok | Çelişkili işaretler oluşur |
| 8 | Her yayın ve değişiklikten sonra kontrol | Hata haftalarca fark edilmeyebilir |
Düzeltmelerden sonra sonucun görünmesi zaman alabilir: arama motoru dosyayı yeniden okuyup sayfaları yeniden değerlendirmeden önceki durum sonuçlarda kalabilir. Beklemek ve raporları izlemek bu sürecin doğal parçasıdır.
Okumanızı öneririzE-Ticarette Site Hızı Neden Önemlidir?Robots.txt ve Teknik SEO Birlikte Nasıl Çalışır?
Robots.txt, teknik SEO’nun tarama katmanıdır; site haritası, canonical, noindex ve yönlendirmelerle birlikte çalıştığında anlamlı olur. Tek başına bir kural, çevresindeki işaretlerle çelişiyorsa sonuç vermez.
| Araç | Cevapladığı soru | Robots.txt ile ilişkisi |
|---|---|---|
| Robots.txt | Bu adrese girilsin mi? | Taramayı yönetir |
| Site haritası | Taranmasını istediğim sayfalar hangileri? | Haritadaki adresler engellenmemeli |
| Canonical | Bu içeriğin asıl adresi hangisi? | Engellenen sayfa canonical okutamaz |
| Noindex | Bu sayfa sonuçlarda çıksın mı? | Tarayıcı sayfaya girebilmeli |
| 301 yönlendirme | Bu adres artık nerede? | Eski adres engellenmemeli |
Pratik sıralama şöyledir: önce hangi sayfaların taranıp dizine alınmasını istediğinize karar verin, sonra bu kararı doğru araçla ifade edin. Robots.txt çoğunlukla “sonsuz ve değersiz alan” içindir; “bu sayfa sonuçlarda görünmesin” kararı için noindex, “bu içerik burada değil, orada” kararı için yönlendirme ve canonical daha uygundur. Mağaza genelinde bu ayarları birlikte kurmak için e-ticaret SEO ayarları nasıl yapılır rehberini, kategori sayfalarının nasıl güçlendirileceğini ise kategori sayfası SEO’su yazısında bulabilirsiniz. Mağazanın yasal ve kurumsal sayfalarının nasıl düzenleneceğini e-ticaret sitesi yasal sayfalar yazısı anlatır.
Faprika ile Robots ve Tarama Yönetimi
Faprika e-ticaret altyapısında robots ve site haritası gibi arama motoru ayarları mağazanın SEO yönetiminin parçasıdır. Paket özellik karşılaştırmasında “Canonical / H Etiket Yönetimi / Robots / Sitemap” satırı bu yönetim alanını gösterir; adres taşımaları ve eski adreslerin yönetimi için ise “301 / 302 / 410 Paneli / URL Kayıtlarını Yönetme” satırı bulunur.
Başlık ve açıklama güncellemeleri için “Toplu Otomatik SEO/Meta Bilgi Güncelleme” ve mağazanın arama performansını izlemek için “SEO Raporları” gibi özellikler de paket karşılaştırmasında yer alır. Hangi paketin hangi SEO yönetim araçlarını içerdiği paketlere göre değişebilir; güncel kapsam için e-ticaret paketleri sayfasına bakabilirsiniz. Robots dosyasında yapacağınız değişikliğin mağazanızdaki karşılığını ve kapsamını bilmek için Faprika ekibine danışmanız en güvenli yoldur: hangi alanların panelden yönetildiğini birlikte netleştirirsiniz.
Genel SEO kurulumunu e-ticaret SEO ayarları rehberiyle, adres taşımalarını 301 yönlendirme rehberiyle, harita ve tekil adres kararlarını ise site haritası ve canonical etiketi yazılarıyla birlikte düşünmek, mağazanızın arama motorlarına tutarlı bir mesaj vermesini sağlar.
Sıkça Sorulan Sorular
Robots.txt nedir?
Robots.txt, sitenin kök dizininde duran ve arama motoru tarayıcılarına hangi adreslere girebileceklerini, hangilerine girmemeleri gerektiğini bildiren düz metin dosyasıdır. Bir emir değil, bir istektir; dürüst tarayıcıların çoğu buna uyar. Taramayı yönetir, sayfaları dizinden çıkarmaz.
Robots.txt dosyası nerede bulunur?
Her alan adının kök dizininde, /robots.txt adresinde bulunur. Alt alan adlarının her birinin kendi dosyası olmalıdır. Dosya küçük harfle adlandırılır, düz metin olmalı ve 200 durum koduyla açılmalıdır. Tarayıcıya magazaadresiniz/robots.txt yazarak içeriğini görebilirsiniz.
Robots.txt ile noindex aynı şey mi?
Hayır. Robots.txt tarayıcının bir adrese girmesini engeller; noindex ise sayfanın arama sonuçlarında yer almamasını ister. Robots.txt ile engellenen sayfa, başka sitelerden bağlantı alıyorsa adresiyle yine dizinde görünebilir. Sayfayı sonuçlardan çıkarmak için tarayıcı sayfaya girip noindex’i okuyabilmelidir; bu yüzden aynı sayfayı robots.txt ile engellememelisiniz.
E-ticarette robots.txt ile neler engellenmeli?
Genellikle sepet ve ödeme adımları, müşteri hesabı ve giriş sayfaları, site içi arama sonuçları, rastgele filtre ve sıralama parametreli adresler ile yönetim ve test alanları engellenir. Ürün, kategori ve blog sayfaları ile CSS, JavaScript ve görsel dosyaları ise engellenmemelidir.
Robots.txt’de Disallow: / ne yapar?
Tüm siteyi tarayıcılara kapatır. Çoğunlukla yayın öncesi test sitesi için kullanılır; canlı siteye unutularak taşınırsa mağaza arama sonuçlarından kaybolmaya başlar. Her yayın ve değişiklik sonrası robots.txt dosyasını kontrol etmek bu hatayı önler.
Yapay zekâ tarayıcılarını robots.txt ile engelleyebilir miyim?
Evet, çoğu yapay zekâ tarayıcısı kendi user-agent adını tanıtır ve robots.txt kurallarına uyduğunu belirtir. Belirli bir tarayıcı için ayrı bir grup yazıp tüm siteyi ya da bölümlerini kapatabilirsiniz. Ancak robots.txt bir istektir; hepsinin uyacağı garanti edilemez. Yapay zekâ asistanlarında görünür olmak istiyorsanız toptan engellemeden önce düşünün.


