
Sommaire 14 sections
- Qu’est-ce que Robots.txt ?
- Qu’est-ce qu’un robot d’exploration (bot) et quel est son lien avec Robots.txt ?
- Où se trouve le fichier Robots.txt et comment le créer ?
- Que signifient les lignes de Robots.txt ?
- Quelle est la différence entre robots.txt et noindex ?
- Que faut-il bloquer avec robots.txt sur un site e-commerce ?
- Que ne faut-il jamais bloquer avec robots.txt ?
- À quoi ressemble un exemple de fichier robots.txt pour un site e-commerce ?
- Quelles sont les erreurs les plus fréquentes dans robots.txt ?
- Comment gérer les robots d'IA avec robots.txt ?
- Comment tester et surveiller robots.txt ?
- Comment robots.txt et le SEO technique fonctionnent-ils ensemble ?
- Gestion des robots et de l'exploration avec Faprika
- Questions fréquentes
La vitrine d'un magasin est ouverte à tous, mais tout le monde ne peut pas entrer dans la réserve, derrière la caisse ou dans le bureau de la direction. Votre site fonctionne de la même façon : les pages produits et catégories sont ouvertes aux visiteurs et aux moteurs de recherche, tandis que le panier, les étapes de paiement, l'espace d'administration et les URL de filtres en nombre infini n'ont pas à être vus de tous. Un petit fichier texte indique ces limites aux visiteurs automatiques des moteurs de recherche (robots d'exploration, ou bots) : le fichier robots.txt.
Dans ce guide, nous répondons simplement à la question qu'est-ce que robots.txt : ce qu'est ce fichier, où il se trouve, comment rédiger les lignes User-agent, Disallow, Allow et Sitemap, en quoi il diffère de noindex, ce qu'il faut bloquer et ce qu'il ne faut jamais bloquer sur un site e-commerce, comment gérer les robots d'IA, les erreurs fréquentes et les méthodes de test. À la fin, vous trouverez la gestion des robots avec Faprika et une FAQ de six questions.
Qu'est-ce que robots.txt ?
Robots.txt est un fichier texte simple placé à la racine de votre site, qui indique aux robots des moteurs de recherche quelles URL ils peuvent consulter et lesquelles ils ne doivent pas explorer. Connu aussi sous le nom de « protocole d'exclusion des robots », c'est une convention commune depuis les débuts d'internet.
Ce fichier est une demande, pas un ordre. La grande majorité des moteurs de recherche la respectent, mais le fichier lui-même ne contraint personne. Les robots malveillants peuvent ne jamais le lire ; robots.txt n'est donc pas une mesure de sécurité. Une zone qui doit rester confidentielle nécessite un mot de passe, une autorisation et des réglages serveur ; robots.txt n'est qu'un accord avec les robots honnêtes.
Ce fichier est un texte simple avec l'extension .txt ; aucun logiciel particulier n'est nécessaire. On peut l'écrire dans un bloc-notes, mais son nom et son emplacement doivent être exacts : le nom du fichier est robots.txt en minuscules et il se trouve à la racine du site. Sous sa forme la plus simple, il ressemble à ceci :
User-agent: *
Disallow:

Sitemap: https://magazaadresiniz/sitemap.xml
Ce fichier de deux lignes signifie « tous les robots peuvent aller partout, et voici mon plan de site ». Une ligne Disallow vide ne bloque rien.
Qu'est-ce qu'un robot d'exploration (bot) et quel est son lien avec robots.txt ?
Un robot d'exploration, bot ou spider est un logiciel qui visite automatiquement les pages web, lit leur contenu et découvre de nouvelles pages en suivant les liens. Les moteurs de recherche s'en servent pour découvrir votre site et l'ajouter à leur index.
Quand un robot arrive sur un site, il consulte d'abord le fichier robots.txt à la racine. Si le fichier contient une règle qui le concerne, il l'applique, puis commence à explorer. S'il n'y a pas de fichier (erreur 404), il suppose qu'il peut aller partout. Chaque robot porte un nom, et vous pouvez vous adresser à lui dans le fichier par ce nom, appelé « user-agent ».
Le temps et les ressources qu'un robot consacre à un site sont limités. Dans le métier, on parle de budget d'exploration. Sur un grand site e-commerce, les combinaisons de filtres, les paramètres de tri et les pages de recherche interne peuvent générer des centaines de milliers d'URL ; si les robots y passent du temps, vos nouveaux produits et vos catégories importantes risquent d'être découverts tardivement. Robots.txt est le moyen le plus simple et le moins coûteux d'orienter cette ressource vers les pages de valeur.
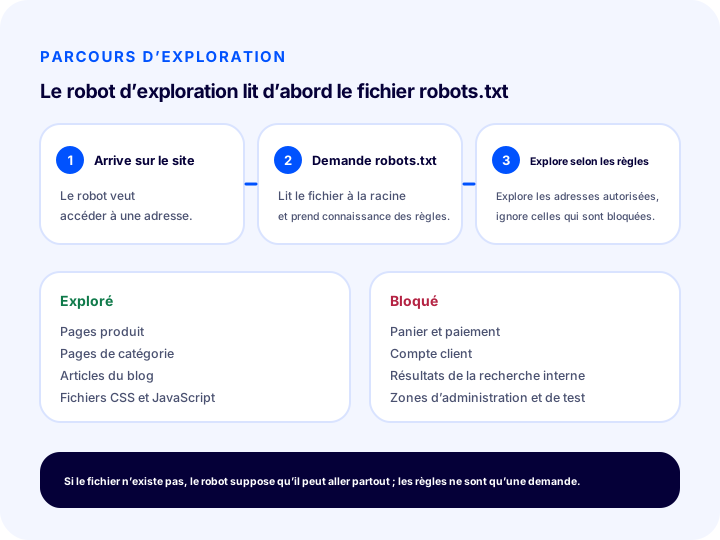
L'illustration résume le déroulement : le robot arrive sur le site, demande le fichier robots.txt, lit les règles et explore les URL autorisées ; il n'entre pas dans les URL bloquées. Le même ordre en texte : d'abord le fichier, puis la règle, puis l'exploration.
Où se trouve le fichier robots.txt et comment le créer ?
Le fichier robots.txt doit se trouver à la racine de chaque domaine (et sous-domaine), à l'adresse /robots.txt. Un fichier placé dans un autre dossier n'est pas recherché par les robots.
Cela a des conséquences pratiques :
- Une racine, un fichier. L'adresse
magazaadresiniz/robots.txts'applique au domaine principal de votre boutique. Si vous avez un sous-domaine (par exemple pour un blog), il doit avoir son propre fichier robots.txt ; le fichier du domaine principal ne lie pas le sous-domaine. - Le protocole et la version du domaine comptent. http et https, avec ou sans www, sont techniquement des adresses distinctes. Si vous redirigez vers une seule version, les règles doivent figurer dans le fichier de cette version.
- Le nom du fichier s'écrit en minuscules. Les formes comme
Robots.txtourobots.TXTne sont pas fiables. - Le fichier doit être du texte brut. Pas de HTML, d'image ni de document mis en forme ; du texte simple, de préférence encodé en UTF-8.
- Le fichier doit s'ouvrir avec un code de statut 200. S'il renvoie une erreur, le robot ne sait pas quoi faire, ce qui rend le comportement d'exploration imprévisible.
Il y a deux façons de le créer : écrire le fichier à la main et le placer à la racine, ou utiliser le réglage robots proposé par votre plateforme e-commerce. Sur les plateformes prêtes à l'emploi, le fichier se gère le plus souvent depuis le panneau d'administration ; vous n'avez alors pas besoin de le téléverser manuellement. Dans les sections suivantes, nous construirons le contenu du fichier pas à pas.
Que signifient les lignes de robots.txt ?
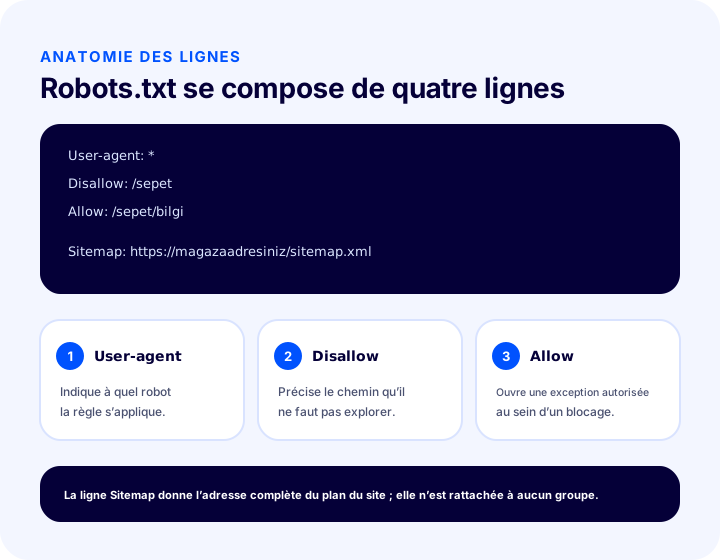
Robots.txt se compose de quatre lignes de base : User-agent indique à qui la règle s'applique, Disallow ce qui est bloqué, Allow l'exception à l'intérieur d'un blocage et Sitemap l'adresse du plan de site. Les lignes s'écrivent par groupes, et chaque groupe commence par une ligne User-agent.
| Ligne | Indique | Exemple |
|---|---|---|
| User-agent | Le robot auquel la règle s'applique ; un astérisque (*) signifie tous | User-agent: * |
| Disallow | Un chemin que vous ne voulez pas voir exploré | Disallow: /sepet |
| Allow | Un chemin autorisé à l'intérieur d'une zone bloquée | Allow: /sepet/bilgi |
| Sitemap | L'adresse complète du plan de site | Sitemap: https://magazaadresiniz/sitemap.xml |
1. User-agent
User-agent indique à qui la règle s'applique. L'astérisque (*) couvre tous les robots. Si vous voulez une règle distincte pour un robot précis, vous écrivez son nom ; ce robot consulte à la fois son propre groupe et le groupe à astérisque, mais s'il existe un groupe qui lui est propre, il n'applique le plus souvent que celui-là. Quand vous ouvrez un groupe distinct pour un robot précis, il peut donc être nécessaire d'y répéter aussi les règles générales.
2. Disallow
Disallow indique le chemin bloqué. Le chemin commence par une barre oblique et couvre toutes les URL qui commencent ainsi. Si vous écrivez Disallow: /sepet, toute URL commençant par /sepet (par exemple /sepet/odeme) est bloquée. Laisser la ligne vide signifie « ne rien bloquer ».
3. Allow
Allow sert à ouvrir une petite exception à l'intérieur d'un blocage large. Par exemple, vous pouvez bloquer un dossier et autoriser un seul sous-dossier à l'intérieur. Quand plusieurs règles couvrent la même URL, c'est généralement le chemin le plus précis (le plus long) qui l'emporte.
4. Sitemap
La ligne Sitemap donne l'adresse complète de votre plan de site. Elle peut figurer n'importe où dans le fichier et n'est rattachée à aucun groupe User-agent. En lisant robots.txt, le robot apprend aussi l'adresse de votre plan de site. La préparation d'un plan de site est expliquée dans le guide qu'est-ce qu'un sitemap.
5. Caractères génériques et marqueur de fin d'URL
L'astérisque (*) dans un chemin signifie « toute suite de caractères » ; le signe dollar ($) indique que l'URL se termine exactement ici. Les deux sont pris en charge par les principaux robots, mais pas par tous de la même façon ; vérifiez d'abord les règles critiques par un petit test.
User-agent: *
Disallow: /*?sirala=
Disallow: /*.pdf$
La première règle bloque toute URL contenant ?sirala= ; la seconde ferme les URL qui se terminent exactement par .pdf. Attention à la casse : les chemins sont généralement sensibles à la casse, alors que les noms de directives (User-agent, Disallow) ne le sont pas.
On peut aussi écrire des lignes de commentaire dans le fichier : les lignes commençant par # sont ignorées par les robots. Laisser de courtes notes pour se rappeler quelques mois plus tard pourquoi on a ajouté une règle est une bonne habitude.
Quelle est la différence entre robots.txt et noindex ?
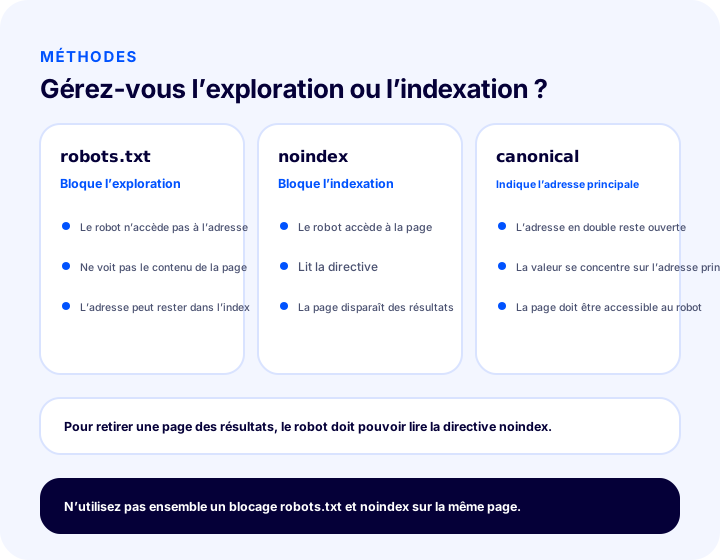
Robots.txt empêche un robot d'accéder à une URL ; noindex demande que la page n'apparaisse pas dans les résultats de recherche. Une page bloquée par robots.txt peut quand même apparaître dans l'index avec sa seule adresse si elle reçoit des liens d'autres sites, car le robot n'entre pas dans la page et ne peut donc voir ni son contenu ni la directive noindex.
C'est le malentendu le plus fréquent : robots.txt ne retire pas une page de l'index. Si vous voulez qu'une page disparaisse des résultats de recherche, le robot doit pouvoir entrer dans la page et lire la directive noindex ; cela signifie que vous ne devez pas bloquer cette page dans robots.txt.
| Fonctionnalité | Robots.txt | Noindex |
|---|---|---|
| Où se définit-elle ? | Dans le fichier robots.txt à la racine | Dans la balise meta de la page ou dans l'en-tête de la réponse du serveur |
| Que gère-t-il ? | L'exploration (le robot entre-t-il dans la page ?) | L'indexation (la page apparaît-elle dans les résultats ?) |
| La page est-elle visible dans les résultats ? | Si d'autres sites y renvoient, elle peut apparaître comme simple adresse | Non visible, à condition que le robot puisse lire la directive |
| Le robot entre-t-il dans la page ? | Non | Oui, et il lit la directive |
| Usage typique | Préserver les ressources d'exploration, fermer les espaces d'URL infinis | Pages qui ne doivent pas apparaître dans les résultats |
| Peut-on les combiner ? | Entre en conflit avec noindex sur la même page | Ne bloquez pas la même page avec robots.txt |
Le cadre de décision est le suivant : fermez avec robots.txt les zones qui gaspillent les ressources d'exploration et n'ont jamais besoin d'apparaître dans les résultats (comme les combinaisons de filtres infinies). Utilisez noindex lorsque la page elle-même ne doit pas apparaître dans les résultats mais que le robot doit pouvoir la lire. Si un même contenu possède plusieurs URL, indiquez l'URL principale avec la balise canonical ; pour les détails de cette différence, consultez l'article qu'est-ce que la balise canonical.
Que faut-il bloquer avec robots.txt sur un site e-commerce ?
Sur un site e-commerce, robots.txt sert généralement à bloquer le panier et les étapes de paiement, les pages de compte client, les résultats de recherche interne, les URL à paramètres de filtre et de tri, ainsi que les zones d'administration. Point commun : ces URL n'ont pas d'équivalent dans les résultats de recherche et gaspillent les ressources d'exploration.
1. Panier et étapes de paiement
Les pages de panier et de paiement sont personnelles ; elles affichent un contenu différent à chaque visiteur et n'ont aucun intérêt dans les résultats de recherche. Il est inutile que les robots accèdent à ces URL. La sécurité des pages de paiement, par exemple avec un certificat SSL, est une question distincte ; robots.txt ne protège pas ces pages, il demande seulement aux robots de s'en tenir à l'écart.
2. Compte client et pages de connexion
Les pages de connexion, de commandes, de carnet d'adresses et de réinitialisation du mot de passe sont fermées pour la même raison. Elles ne contiennent aucun contenu recherchable ; de plus, comme elles renferment des informations propres à l'utilisateur connecté, il n'y a aucun intérêt à ce que les robots s'en occupent.
3. Résultats de la recherche interne
Chaque requête qu'un client saisit dans la barre de recherche génère une nouvelle URL. Le nombre de ces URL est illimité et elles n'ont aucune valeur de contenu durable. Fermer cette zone avec robots.txt évite que le robot ne s'égare dans un réservoir d'URL sans fin.
4. Paramètres de filtre et de tri
Les sélections de couleur, de taille, de fourchette de prix et de tri ajoutent des paramètres à l'URL. La combinaison de quelques filtres peut produire des centaines de milliers d'URL. Comme la plupart affichent les mêmes produits dans un ordre différent, elles n'ont pas de valeur de recherche propre. Plutôt que de tout fermer, décidez quelles pages de filtre sont réellement des pages d'entrée recherchées ; laissez une page de filtre recherchée (par ex. une combinaison précise de couleur et de catégorie) ouverte à l'exploration. Pour le côté utilisateur de la conception des filtres, consultez le guide optimisation des filtres produits et de la barre de recherche.
5. Zones d'administration et pages temporaires
Les panneaux d'administration, les pages de test et d'aperçu, les sauvegardes et les fichiers à usage interne ne doivent pas apparaître dans les résultats de recherche. Rappel : le fichier robots.txt est public ; tout le monde peut voir les chemins que vous bloquez. Écrire dans robots.txt le nom d'une zone réellement confidentielle revient donc à l'annoncer. Pour la confidentialité, un contrôle d'accès est indispensable.
6. Calendriers infinis, URL de session et de suivi
Les URL qui portent un identifiant de session ou auxquelles on ajoute des paramètres de suivi de campagne produisent des copies d'une page. Il est le plus souvent plus judicieux de les gérer avec canonical plutôt qu'avec robots.txt ; si vous les bloquez, le robot ne peut pas entrer dans la page et lire l'URL principale.
| Champ | Faut-il bloquer avec robots.txt ? | Pourquoi ? |
|---|---|---|
| Panier et paiement | Oui | Personnel, sans valeur de recherche |
| Compte client et connexion | Oui | Contenu personnel, exploration inutile |
| Résultats de la recherche interne | Oui | URL infinies, sans valeur durable |
| Filtres et tris aléatoires | En général oui | Mêmes produits, de nombreuses URL |
| Page de filtre spécifique recherchée | Non | Peut être une véritable page d'entrée |
| Zones d’administration et de test | Oui, avec en plus un contrôle d'accès | Ne doit pas figurer dans l'index |
| URL avec paramètres de suivi | Le plus souvent non, utiliser canonical | Le robot doit pouvoir lire l'URL principale |
Que ne faut-il jamais bloquer avec robots.txt ?
Les pages produits, les pages de catégories, les articles de blog ainsi que les fichiers de style (CSS) et de script (JavaScript) qui composent l'apparence des pages ne doivent pas être bloqués par robots.txt. Lorsqu'ils le sont, le moteur de recherche ne voit pas la page du tout ou la voit cassée.
- Pages produits et catégories. Ce sont les pages qui génèrent du chiffre d'affaires pour votre boutique ; les bloquer entraîne une perte directe de visibilité.
- Blog et pages d'information. Ce sont une source importante de trafic de recherche.
- Fichiers CSS et JavaScript. Les moteurs de recherche veulent afficher la page comme la voient les visiteurs. Si les fichiers de style et de script sont bloqués, la page peut sembler cassée ou vide, et l'évaluation de la compatibilité mobile et de l'expérience de page en pâtit.
- Images. Bloquer l'exploration des visuels produits supprime votre visibilité dans la recherche d'images.
- Plan du site. Le plan du site lui-même et les adresses qu'il contient ne doivent pas être bloqués.
- Anciennes adresses redirigées. Le robot doit pouvoir accéder à l'ancienne adresse pour voir la redirection 301. Si vous bloquez l'ancienne adresse, la redirection ne transmet pas sa valeur ; le détail se trouve dans l'article qu'est-ce qu'une redirection 301.
- Pages avec données structurées. Les balisages de résultats enrichis, comme les produits et les avis, ne sont lus que si la page peut être explorée ; consultez le guide qu'est-ce que les données structurées pour plus de détails.
À quoi ressemble un exemple de fichier robots.txt pour une boutique e-commerce ?
Le fichier ci-dessous est un exemple simple pour un site e-commerce de taille moyenne : il bloque le panier, le compte, la recherche et les adresses à paramètres, et déclare le plan du site. Les chemins varient selon la boutique ; adaptez-les aux chemins réels de votre site.
# Tüm tarayıcılar için genel kurallar
User-agent: *
Disallow: /sepet
Disallow: /odeme
Disallow: /hesabim
Disallow: /giris
Disallow: /arama
Disallow: /*?sirala=
Disallow: /*?oturum=

Sitemap: https://magazaadresiniz/sitemap.xml
La logique du fichier est la suivante : la première ligne de commentaire indique l'objectif du fichier ; User-agent: * sélectionne tous les robots ; les lignes suivantes bloquent les espaces personnels, la recherche interne et les adresses à paramètres de tri et de session ; la dernière ligne indique l'emplacement du plan du site. Aucune ligne ne bloque les adresses CSS, JavaScript, produits et catégories.
Exemple d'exception avec Allow
On utilise Allow lorsque l'on veut bloquer un dossier tout en autorisant un seul sous-chemin :
User-agent: *
Disallow: /hesabim
Allow: /hesabim/yardim
Dans cet exemple, l'espace compte est bloqué ; seule la page d'aide accessible au public peut être explorée. Comme de telles exceptions compliquent les règles, ne les utilisez que lorsque c'est vraiment nécessaire.
Le prix d'une erreur : une seule ligne de différence
Les deux règles se ressemblent beaucoup, mais leurs conséquences sont radicalement opposées :
Disallow:    # hiçbir şeyi engellemez
Disallow: /  # tüm siteyi engeller
La première n'a pas de barre oblique et tout le site peut être exploré. Dans la seconde, une seule barre oblique ferme tout le site aux robots. Cette différence fait l'objet de la section suivante.
Quelles sont les erreurs courantes dans le fichier robots.txt ?
La plupart des erreurs de robots.txt viennent de petits détails de saisie, mais leurs conséquences sont lourdes. Comme ce fichier de règles affecte tout votre site depuis un seul endroit, chaque modification doit être faite avec soin. Voici les plus fréquentes.
- Bloquer tout le site par accident. La ligne
Disallow: /ferme tout le site. Cette règle, souvent ajoutée pour un site de test avant la mise en ligne, est oubliée lors du passage au site en production, et la boutique commence à disparaître des résultats de recherche. Elle doit figurer sur votre liste de contrôle avant et après la mise en ligne. - Bloquer les fichiers CSS et JavaScript. Cette habitude autrefois courante entraîne aujourd'hui un affichage cassé de la page et des problèmes dans l'évaluation de l'expérience de page.
- Prendre le robots.txt pour un outil de retrait de l'index. Une page bloquée peut rester dans l'index avec son adresse. Pour la retirer des résultats, on utilise noindex.
- Laisser une page bloquée dans le plan du site. Bloquer par robots.txt une adresse présente dans le plan du site dit au robot à la fois « viens » et « n'entre pas ». Des signaux contradictoires réduisent la confiance accordée aux deux.
- Placer le fichier au mauvais endroit. Un fichier qui n'est pas à la racine, qui porte un autre nom ou qui renvoie une erreur n'est pas lu ; toutes les règles sont alors inutiles.
- Écrire des chemins secrets. Le fichier est public ; y inscrire le chemin du panneau d'administration revient à l'annoncer.
- Erreurs de syntaxe et de format. Un deux-points manquant, un nom de directive mal orthographié ou un chemin qui ne commence pas par une barre oblique invalident la règle. Certains robots ignorent la ligne erronée, d'autres peuvent ignorer tout le groupe.
- Utiliser des jokers trop larges. Une règle avec un astérisque peut, sans que vous le sachiez, couvrir aussi des adresses de produits ou de catégories. Testez chaque règle à joker sur les adresses qu'elle concerne.
- Copier le fichier du site de test vers la production, ou l'inverse. Reporter le fichier de production sur l'environnement de test peut ouvrir l'exploration inutilement ; si le fichier de test passe en production, il peut fermer le site.
- Ne pas vérifier après les modifications. Une fois le fichier mis à jour, l'ancienne version peut rester un temps dans la mémoire du moteur de recherche ; ne considérez pas le travail comme terminé sans avoir vérifié que la modification est effective.
Comment gérer les robots d'IA avec le fichier robots.txt
Les robots d'IA, comme les moteurs de recherche, s'identifient par un nom d'user-agent, et la plupart indiquent respecter les règles du robots.txt. Vous pouvez ainsi décider séparément quel robot d'IA peut accéder à votre site.
Il existe ici deux objectifs différents, et la décision dépend de votre modèle économique :
- Si vous voulez être visible. Si vous souhaitez que les assistants d'IA mentionnent vos produits, vos guides et votre marque, il faut autoriser leurs robots. Dans ce cas, ne les bloquez pas ; il est plus important que votre contenu soit clair, bien organisé et citable.
- Si vous voulez limiter l'utilisation de votre contenu. Si vous ne voulez pas qu'un robot d'IA donné accède à votre site, vous écrivez un groupe distinct pour son nom d'user-agent.
# Belirli bir yapay zekâ tarayıcısını tüm siteden uzak tutma
User-agent: ornek-yapay-zeka-botu
Disallow: /

# Diğer tarayıcılar için genel kurallar
User-agent: *
Disallow: /sepet
Disallow: /odeme
Le nom dans l'exemple est représentatif ; vous devez consulter les noms réels des robots dans la documentation publiée par chaque service d'IA. Comme les noms et le comportement des robots peuvent évoluer, revoyez ces règles de temps à autre. N'oubliez pas : le robots.txt est une demande, et tous les robots d'IA ne la respectent pas forcément ; pour un contenu qui doit vraiment être protégé, un contrôle d'accès est indispensable.
Comment tester et surveiller le fichier robots.txt
Pour tester le robots.txt, il faut ouvrir le fichier dans un navigateur et consulter son contenu, vérifier que les adresses importantes ne sont pas bloquées et surveiller les rapports robots de l'outil de gestion du moteur de recherche. Le test doit être répété avant la mise en ligne du fichier et après chaque modification.
- Ouvrez le fichier. Saisissez
magazaadresiniz/robots.txtdans le navigateur. Du texte brut doit s'afficher et la page ne doit pas renvoyer d'erreur. - Lisez les règles. Assurez-vous qu'aucune règle ne bloque involontairement tout le site ou les espaces produits et catégories.
- Testez des adresses exemples. Choisissez une page produit, une page catégorie, un article de blog, un fichier de style et un fichier de script ; vérifiez qu'aucun n'est bloqué. Avec la même méthode, vérifiez que les adresses du panier et de la recherche sont bloquées.
- Consultez les rapports de l'outil de gestion du moteur de recherche. Ces outils indiquent l'état du fichier robots, sa dernière lecture et les adresses bloquées. Si l'avertissement « Bloqué par le fichier robots.txt » apparaît pour une page importante, revoyez la règle immédiatement.
- Comparez avec le plan du site. Vérifiez qu'aucune des adresses du plan du site n'est bloquée par le robots.txt.
- Surveillez après les modifications. Les changements de règles peuvent ne pas faire effet immédiatement ; suivez pendant quelques semaines les statistiques d'exploration et l'état de l'index.
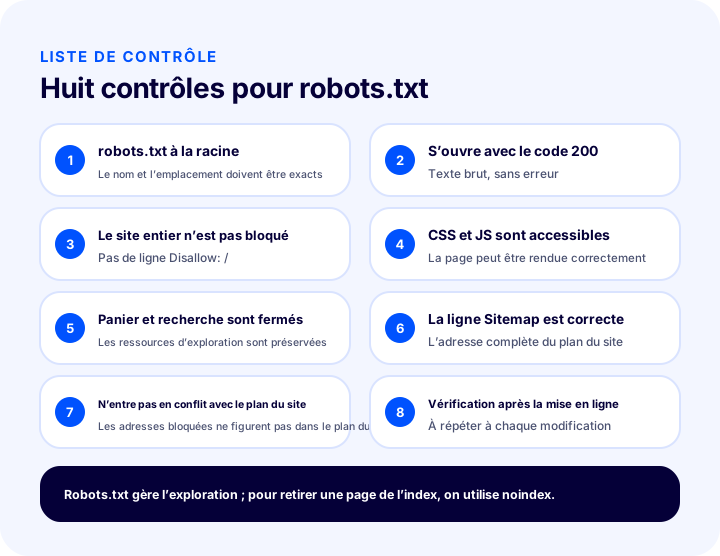
Les huit points de l'illustration figurent aussi ci-dessous sous forme de liste, pour les avoir sous la main lors d'un contrôle détaillé :
| # | Point à vérifier | Que se passe-t-il si c’est incorrect ? |
|---|---|---|
| 1 | Le fichier est à la racine et s'appelle robots.txt | Les robots ne trouvent pas du tout le fichier |
| 2 | Le fichier s'ouvre avec un code 200, en texte brut | Le comportement d'exploration devient imprévisible |
| 3 | Aucune ligne ne bloque tout le site | La boutique disparaît des résultats de recherche |
| 4 | Les fichiers CSS, JavaScript et les images sont accessibles | La page paraît cassée ou vide |
| 5 | Le panier, le compte et la recherche sont bloqués | Le budget d'exploration est gaspillé |
| 6 | La ligne Sitemap pointe vers la bonne adresse | La découverte du plan du site devient plus difficile |
| 7 | Les adresses bloquées ne figurent ni dans le plan du site ni sous noindex | Des signaux contradictoires apparaissent |
| 8 | Vérifié après chaque mise en production et chaque modification | L'erreur peut passer inaperçue pendant des semaines |
Après les corrections, le résultat peut mettre du temps à apparaître : l'état précédent peut rester dans les résultats jusqu'à ce que le moteur de recherche relise le fichier et réévalue les pages. Attendre et surveiller les rapports fait naturellement partie du processus.
À lire aussiPourquoi la vitesse du site est-elle importante en e-commerce ?Comment le robots.txt et le SEO technique fonctionnent-ils ensemble ?
Le robots.txt est la couche d'exploration du SEO technique ; il prend tout son sens lorsqu'il fonctionne avec le plan du site, le canonical, noindex et les redirections. Une règle isolée ne produit aucun effet si elle contredit les signaux qui l'entourent.
| Outil | Question à laquelle il répond | Relation avec le robots.txt |
|---|---|---|
| Robots.txt | Cette adresse peut-elle être explorée ? | Gère l'exploration |
| Sitemap | Quelles pages je veux voir explorées ? | Les adresses du plan du site ne doivent pas être bloquées |
| Canonical | Quelle est l’adresse d’origine de ce contenu ? | Une page bloquée ne peut pas faire lire son canonical |
| Noindex | Cette page doit-elle apparaître dans les résultats ? | Le robot doit pouvoir accéder à la page |
| Redirection 301 | Où se trouve désormais cette adresse ? | L'ancienne adresse ne doit pas être bloquée |
L'ordre pratique est le suivant : décidez d'abord quelles pages vous voulez voir explorées et indexées, puis exprimez cette décision avec le bon outil. Le robots.txt sert surtout pour les « zones infinies et sans valeur » ; pour la décision « cette page ne doit pas apparaître dans les résultats », noindex, et pour « ce contenu est là, pas ici », les redirections et le canonical conviennent mieux. Pour mettre en place ces réglages ensemble sur toute votre boutique, consultez le guide comment configurer le SEO e-commerce et, pour renforcer les pages catégories, l'article SEO des pages catégories. L'article pages légales d'un site e-commerce explique comment organiser les pages légales et institutionnelles de la boutique.
Gestion des robots et de l'exploration avec Faprika
Dans l'infrastructure e-commerce de Faprika, les réglages moteurs de recherche comme les robots et le plan du site font partie de la gestion SEO de la boutique. Dans la comparaison des fonctionnalités des offres, la ligne « Canonical / Gestion des balises H / Robots / Sitemap » représente ce domaine de gestion ; pour les migrations d'adresses et la gestion des anciennes adresses, il y a la ligne « Panneau 301 / 302 / 410 / Gestion des enregistrements d'URL ».
Des fonctionnalités comme « Mise à jour automatique en masse des informations SEO/Meta » pour les titres et descriptions, et « Rapports SEO » pour suivre la performance de recherche de la boutique figurent aussi dans la comparaison des offres. Les outils de gestion SEO inclus varient selon l'offre ; pour le périmètre actuel, consultez la page offres e-commerce. Pour connaître l'équivalent et la portée de votre modification du fichier robots dans votre boutique, le plus sûr est de consulter l'équipe Faprika : vous précisez ensemble quelles zones sont gérées depuis le panneau.
Penser le paramétrage SEO général avec le guide réglages SEO e-commerce, les migrations d'adresses avec le guide redirection 301, et les décisions sur le plan du site et les adresses uniques avec les articles plan du site et balise canonical, permet à votre boutique d'envoyer un message cohérent aux moteurs de recherche.
Questions fréquentes
Qu’est-ce que robots.txt ?
Robots.txt est un fichier texte brut placé à la racine d’un site, qui indique aux robots d’exploration des moteurs de recherche quelles adresses ils peuvent visiter et lesquelles ils ne doivent pas explorer. C’est une demande, pas un ordre ; la plupart des robots honnêtes la respectent. Il gère l’exploration, mais ne retire pas les pages de l’index.
Où se trouve le fichier robots.txt ?
Il se trouve à la racine de chaque nom de domaine, à l’adresse /robots.txt. Chaque sous-domaine doit avoir son propre fichier. Le nom du fichier est en minuscules, il doit être en texte brut et s’ouvrir avec le code d’état 200. Vous pouvez voir son contenu en saisissant magazaadresiniz/robots.txt dans le navigateur.
Robots.txt et noindex, est-ce la même chose ?
Non. Robots.txt empêche le robot d’accéder à une adresse ; noindex demande que la page n’apparaisse pas dans les résultats de recherche. Une page bloquée par robots.txt peut quand même apparaître dans l’index avec son adresse si elle reçoit des liens d’autres sites. Pour retirer une page des résultats, le robot doit pouvoir y accéder et lire noindex ; c’est pourquoi il ne faut pas bloquer la même page avec robots.txt.
Que faut-il bloquer avec le robots.txt en e-commerce ?
On bloque généralement les étapes du panier et du paiement, les pages de compte client et de connexion, les résultats de la recherche interne, les adresses comportant des paramètres de filtre et de tri aléatoires, ainsi que les zones d’administration et de test. Les pages produit, catégorie et blog, ainsi que les fichiers CSS, JavaScript et d’images, ne doivent pas être bloqués.
Que fait Disallow: / dans robots.txt ?
Il ferme tout le site aux robots d’exploration. Il est surtout utilisé pour un site de test avant la mise en ligne ; s’il est reporté par erreur sur le site en production, la boutique commence à disparaître des résultats de recherche. Vérifier le fichier robots.txt après chaque mise en ligne et chaque modification évite cette erreur.
Puis-je bloquer les robots d’exploration d’IA avec robots.txt ?
Oui, la plupart des robots d’exploration d’IA s’identifient par leur propre nom d’user-agent et indiquent respecter les règles de robots.txt. Vous pouvez rédiger un groupe distinct pour un robot donné et fermer tout le site ou certaines parties. Toutefois, robots.txt est une demande ; rien ne garantit que tous s’y conformeront. Si vous souhaitez être visible dans les assistants d’IA, réfléchissez avant de tout bloquer en bloc.


